
Descenso de Gradiente Explicado: La Fuerza Motriz Detrás de los Modelos de Aprendizaje Automático
En esta página
Comprendiendo el Descenso de Gradiente: La Columna Vertebral del Aprendizaje Automático
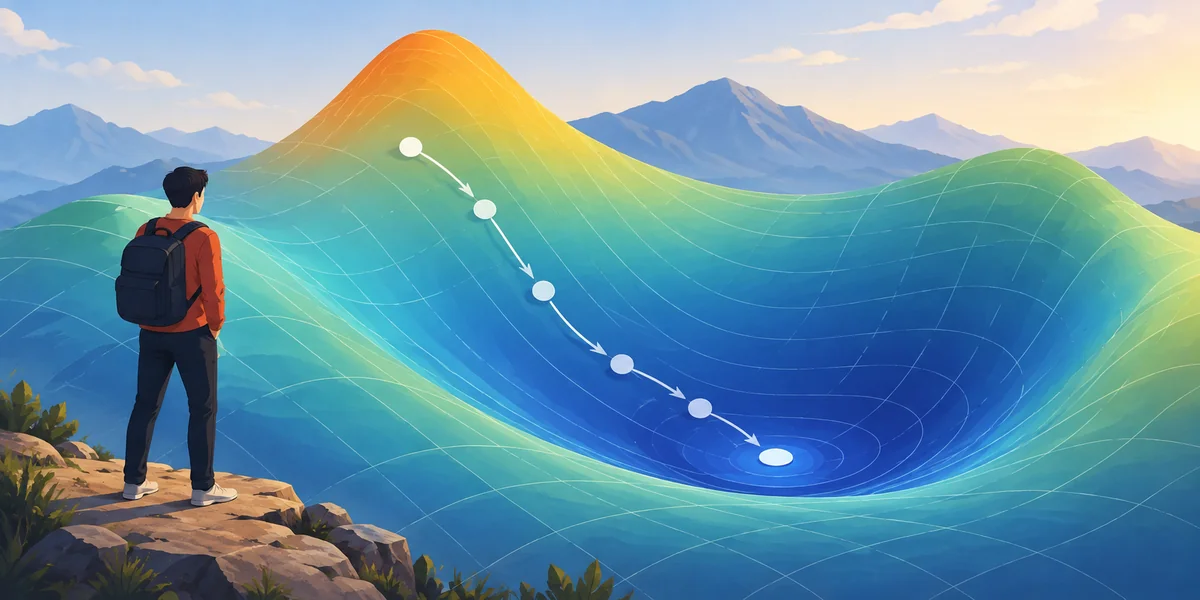
Las máquinas no aprenden mágicamente; ajustan, mejoran y refinan sus predicciones usando un proceso llamado descenso de gradiente. Imagina bajar una montaña sinuosa en medio de una densa niebla, dando pasos cuidadosos para evitar caer. Eso es lo que hace este algoritmo, excepto que en lugar de un excursionista, es un modelo que aprende a minimizar errores. Al ajustar continuamente sus parámetros, encuentra el punto de error más bajo, permitiéndole hacer mejores predicciones con el tiempo.
Ya sea entrenando redes neuronales o afinando algoritmos, el descenso de gradiente es la columna vertebral del aprendizaje automático moderno, impulsando desde sistemas de recomendación hasta coches autónomos. Pero, ¿cómo funciona realmente?
La Mecánica del Descenso de Gradiente
La esencia del descenso de gradiente radica en determinar los mejores parámetros que resultarían en un valor mínimo de una función proporcionada, comúnmente conocida como la función de pérdida o costo. Esta función indica la desviación del resultado del modelo respecto a los valores verdaderos. El objetivo es lograr el valor mínimo de la función donde la salida del modelo sería más precisa.
Comienza con una primera suposición de los parámetros del modelo. La suposición se hace al azar, lo que significa que el modelo comienza con un entendimiento nulo o mínimo de las configuraciones ideales. En segundo lugar, se calcula el gradiente, o la pendiente de la función de costo. El gradiente es la dirección de máximo incremento, y por lo tanto, el modelo ajusta sus parámetros en la dirección opuesta para minimizar el error.
Se emplea un ajuste llamado tasa de aprendizaje para dictar la magnitud en que se actualizan los parámetros en cada paso. Una tasa de aprendizaje alta causa actualizaciones mayores, acelerando el aprendizaje pero potencialmente sobrepasando la mejor solución. Una tasa de aprendizaje baja produce ajustes más precisos pero puede ralentizar el entrenamiento. Encontrar un equilibrio para esta tasa es importante para un aprendizaje eficiente.
Cada paso del algoritmo de descenso de gradiente disminuye el error en una pequeña cantidad, acercando el modelo a la solución óptima. El procedimiento se repite hasta que el error ya no disminuya notablemente o el error haya alcanzado algún límite especificado. Dependiendo del conjunto de datos y el modelo, esto puede tomar varios pasos o involucrar millones de aplicaciones.
Tipos de Descenso de Gradiente
Existen varios tipos de descenso de gradiente, cada uno capaz de manejar diferentes tipos de conjuntos de datos y necesidades computacionales. Los tres tipos más utilizados son el descenso de gradiente por lotes, el descenso de gradiente estocástico y el descenso de gradiente en mini-lotes.
-
Descenso de Gradiente por Lotes: Este método calcula el gradiente usando todo el conjunto de datos antes de actualizar los parámetros. Esto asegura estabilidad y convergencia suave, pero puede ser lento, especialmente con conjuntos de datos grandes. El método requiere una memoria significativa, haciéndolo menos adecuado para datos de alta dimensión.
-
Descenso de Gradiente Estocástico (SGD): Este enfoque actualiza los parámetros después de evaluar solo un punto de datos. Esto hace que el aprendizaje sea mucho más rápido, pero también introduce aleatoriedad en el proceso. La desventaja es que mientras el SGD puede escapar de mínimos locales superficiales, también puede realizar actualizaciones erráticas, llevando a fluctuaciones en el aprendizaje.
-
Descenso de Gradiente en Mini-Lotes: Este método encuentra un equilibrio entre los dos. En lugar de usar todo el conjunto de datos o un solo punto, procesa pequeños lotes de datos a la vez. Este método reduce el ruido mientras sigue siendo computacionalmente eficiente. Se utiliza ampliamente en aplicaciones de aprendizaje profundo y aprendizaje automático a gran escala.
Desafíos y Mejoras
A pesar de su efectividad, el descenso de gradiente presenta algunos desafíos. Un problema importante es quedarse atascado en mínimos locales. En modelos complejos, la función de costo puede tener múltiples valles, y el algoritmo puede asentarse en uno subóptimo en lugar de alcanzar el punto más bajo posible. Para mitigar esto, a menudo se utilizan técnicas como el momentum y tasas de aprendizaje adaptativas.
-
Momentum: Ayuda al algoritmo a mantener su dirección incluso cuando encuentra pequeñas fluctuaciones. En lugar de ajustar los parámetros basándose solo en el paso actual, también considera actualizaciones previas, permitiéndole superar pequeños obstáculos en la función de costo.
-
Métodos de Tasa de Aprendizaje Adaptativa: Técnicas como Adam y RMSprop modifican la tasa de aprendizaje dinámicamente basándose en gradientes pasados. Estas técnicas ayudan al modelo a aprender eficientemente, especialmente cuando diferentes parámetros requieren diferentes tasas de actualización.
Otro desafío es elegir una tasa de aprendizaje apropiada. Si es demasiado alta, el modelo puede nunca alcanzar la solución óptima, rebotando sin converger. Si es demasiado baja, el entrenamiento puede volverse excesivamente lento. Encontrar el equilibrio correcto requiere experimentación y, a veces, ajustes finos.
Aplicaciones del Descenso de Gradiente en el Aprendizaje Automático
El descenso de gradiente se utiliza ampliamente en diversas aplicaciones de aprendizaje automático, desempeñando un papel crucial en el entrenamiento de modelos en diferentes dominios. En el aprendizaje profundo, las redes neuronales dependen del descenso de gradiente para ajustar sus millones de parámetros de manera eficiente. Sin él, optimizar arquitecturas complejas como las redes neuronales convolucionales y recurrentes sería inviable.
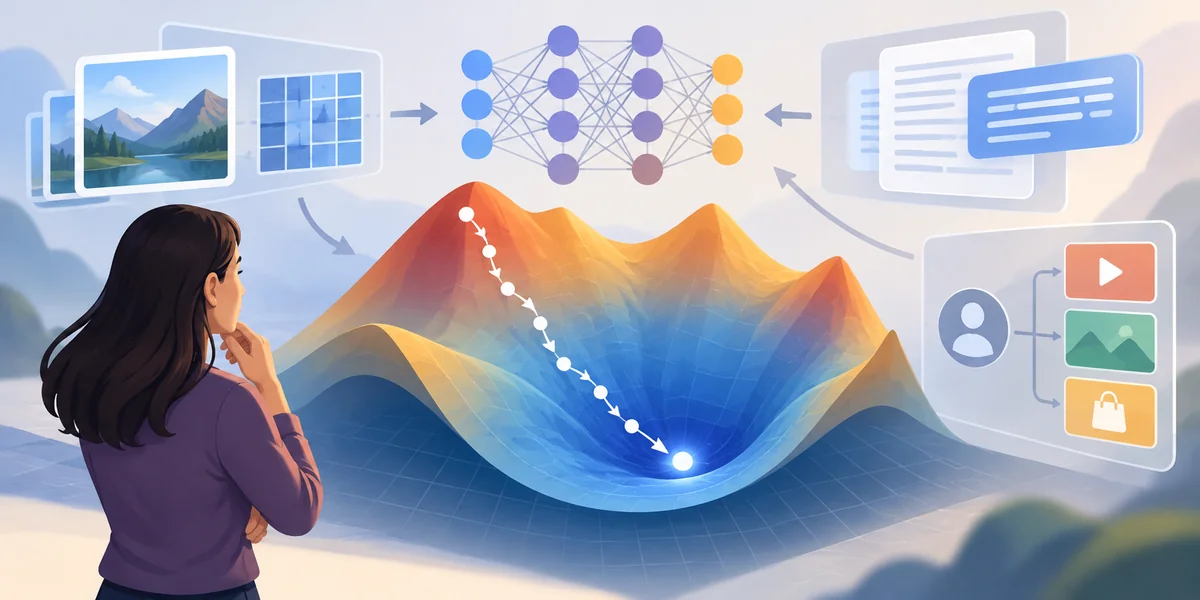
En el procesamiento del lenguaje natural, modelos como transformadores y redes neuronales recurrentes utilizan el descenso de gradiente para aprender patrones en datos textuales. Esto les permite generar texto similar al humano, realizar análisis de sentimientos y mejorar la traducción automática. La capacidad de ajustar pesos basados en gradientes hace que estos modelos sean más precisos con el tiempo.
El descenso de gradiente también impulsa los sistemas de recomendación, ayudando a plataformas como servicios de streaming y sitios web de comercio electrónico a sugerir contenido relevante a los usuarios. Al minimizar errores en la predicción de preferencias de usuario, estos sistemas se vuelven más efectivos en ofrecer recomendaciones personalizadas.
Más allá del aprendizaje automático tradicional, se utiliza el descenso de gradiente en campos como la robótica, el aprendizaje por refuerzo y la computación científica. Su capacidad para afinar modelos lo hace indispensable para tareas que van desde coches autónomos hasta pronósticos financieros. La adaptabilidad de la técnica asegura su relevancia continua a medida que el aprendizaje automático avanza.
Conclusión
El descenso de gradiente es la fuerza silenciosa detrás del aprendizaje automático, ayudando a los modelos a refinar su precisión mediante ajustes continuos. Siguiendo el camino más empinado hacia abajo, minimiza errores y afina predicciones, haciéndolo indispensable en el entrenamiento de todo, desde redes neuronales hasta sistemas de recomendación. Aunque existen desafíos como mínimos locales y selección de tasa de aprendizaje, técnicas como el momentum y optimizadores adaptativos mejoran la eficiencia. Ya sea en el aprendizaje profundo o en modelos más simples, el descenso de gradiente asegura que las máquinas aprendan efectivamente. Comprender este proceso no es solo conocimiento técnico, es la clave para construir sistemas de IA más inteligentes y precisos que impulsan aplicaciones del mundo real en todas las industrias.
Artículos relacionados
Detección de Anomalías en Aprendizaje Automático: Descubriendo Patrones Ocultos en Datos
Diferencias Clave entre Sesgo y Varianza en el Aprendizaje Automático
El Papel de la IA en la Analítica Deportiva: Transformando Datos en Perspectivas Revolucionarias
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
Curva ROC en Aprendizaje Automático: Comprendiendo el Rendimiento del Modelo
Análisis de Clúster en R: Descubriendo Estructuras de Datos Ocultas
Una Guía Completa sobre Aprendizaje Supervisado vs. No Supervisado: Ventajas, Desventajas y Aplicaciones
Técnicas de Procesamiento de Lenguaje Natural: El Futuro de la Comunicación en IA
Máquinas de Vectores de Soporte (SVM): Cómo Impulsan los Modelos de Aprendizaje Automático
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
