
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información
En esta página
Cada segundo se genera una cantidad inmensa de texto: correos electrónicos, publicaciones en redes sociales, estados financieros y comentarios de clientes. Clasificar manualmente esta interminable corriente no solo es poco práctico, es imposible. Ahí es donde entra la clasificación de texto, permitiendo que las computadoras lean, entiendan y categoricen el texto como los humanos, pero con mayor velocidad y consistencia.
Desde la detección de correos electrónicos no deseados hasta la identificación de transacciones financieras fraudulentas e interpretación de patrones de mercado, la clasificación de texto permite a las empresas tomar decisiones basadas en datos de manera más rápida. Pero, ¿qué impulsa esta tecnología? ¿Y por qué es tan crucial en el mundo acelerado de hoy? Vamos a desglosarlo de manera clara y sencilla.
Entendiendo la Clasificación de Texto
La clasificación de texto es el acto de categorizar texto en un conjunto de categorías definidas. Permite a las máquinas identificar patrones en el lenguaje, permitiéndoles procesar y categorizar información de manera efectiva. Imagina enseñar a una computadora a leer y categorizar información como un ser humano, pero mucho más rápido y sin sesgos.
En esencia, este método depende del procesamiento de texto mediante aprendizaje automático, donde los algoritmos aprenden de datos textuales previos para clasificar con precisión nuevo material. Por ejemplo, los bancos emplean la clasificación de texto para revisar estados financieros, identificar actividades fraudulentas y determinar el estado de ánimo de los clientes. Automatizar estas tareas resulta en decisiones más rápidas y precisas con menos errores humanos.
Existen varios métodos para la clasificación de texto. El más sencillo es la clasificación basada en reglas, en la que reglas predefinidas determinan la clasificación del texto. No obstante, este método falla con conjuntos de datos muy grandes y complejos. Los métodos avanzados utilizan aprendizaje automático y procesamiento del lenguaje natural (PLN) para reconocer patrones lingüísticos, mejorando con el tiempo en términos de precisión al clasificar texto.
Cómo el Aprendizaje Automático Mejora la Clasificación de Texto
El aprendizaje automático ha revolucionado la clasificación de texto al permitir que los sistemas aprendan de la experiencia. En lugar de confiar en reglas preprogramadas, estos modelos analizan enormes cantidades de datos para descubrir patrones e interdependencias entre palabras. Esto les permite aprender mejor de nuevas y cambiantes fuentes de texto.
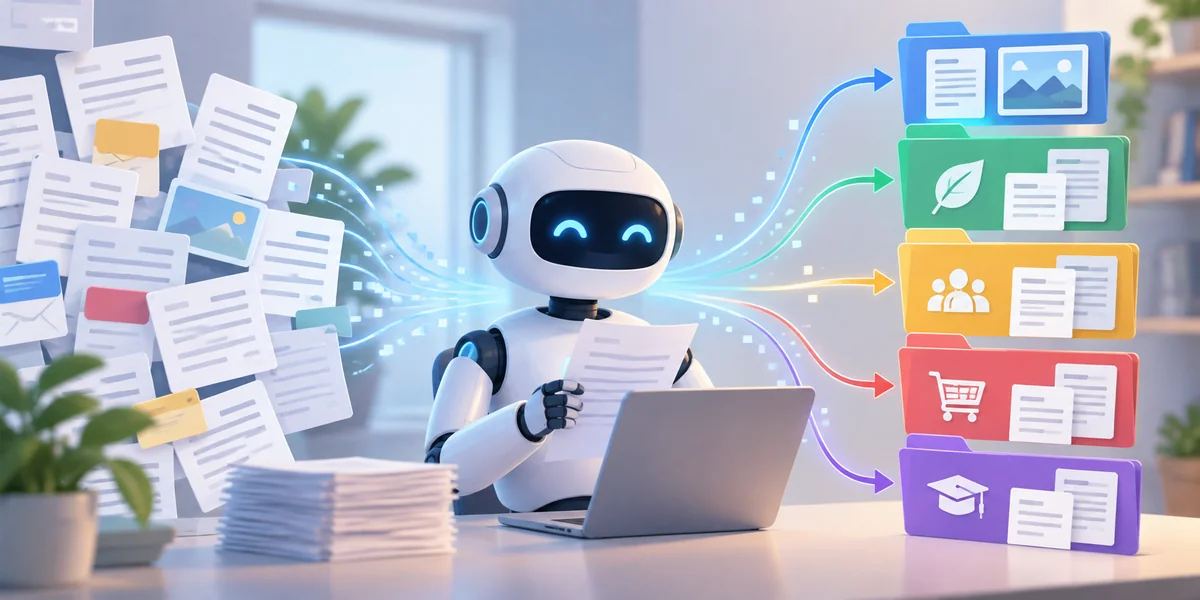
Una de las técnicas populares en el procesamiento de texto mediante aprendizaje automático es el aprendizaje supervisado. En esto, un modelo es entrenado usando ejemplos etiquetados, es decir, texto preclasificado. El sistema aprende de estos ejemplos y utiliza su conocimiento para clasificar texto nuevo y no visto. Un ejemplo clásico es la detección de spam en correos electrónicos. El sistema examina miles de mensajes marcados como "spam" o "no spam" y aprende a identificar las características del spam.
El aprendizaje no supervisado, por otro lado, funciona sin categorías predefinidas. En cambio, el sistema agrupa textos similares basándose en patrones y estructuras que descubre en los datos. Esto es útil cuando se manejan grandes volúmenes de texto no estructurado, como informes financieros o reseñas de clientes, donde las etiquetas predefinidas pueden no estar disponibles.
Otro enfoque poderoso es el aprendizaje profundo, que utiliza redes neuronales para procesar y clasificar texto. Estos modelos pueden detectar patrones complejos del lenguaje e incluso entender el contexto, lo que los hace altamente efectivos en aplicaciones como la detección de fraudes, el análisis financiero y las estrategias de comercio automatizado.
Aplicaciones de la Clasificación de Texto en Finanzas
En la industria financiera, la clasificación de texto juega un papel crítico en el análisis e interpretación de grandes cantidades de datos textuales. Las instituciones financieras, las firmas de inversión y los organismos reguladores utilizan esta tecnología para mejorar la toma de decisiones, mejorar el servicio al cliente y detectar riesgos.
Una aplicación importante es el análisis de sentimientos, donde la clasificación de texto determina el estado de ánimo u opinión detrás de noticias financieras, informes de ganancias o discusiones en redes sociales. Los inversores utilizan el análisis de sentimientos para evaluar tendencias del mercado y tomar decisiones informadas basadas en la percepción pública.
Otro uso crucial es la detección de fraudes. El fraude financiero a menudo implica patrones sospechosos ocultos dentro de datos textuales, como descripciones de transacciones, quejas de clientes o mensajes de soporte. Al clasificar texto relacionado con el fraude, los bancos y las instituciones financieras pueden identificar amenazas potenciales y prevenir pérdidas.
La clasificación de texto también es esencial para el cumplimiento normativo. Las organizaciones financieras deben cumplir con estrictas regulaciones, lo que requiere la monitorización constante de documentos, informes y registros de comunicación. La clasificación automática de texto asegura que se sigan las directrices regulatorias y ayuda a detectar posibles violaciones.
Además, la clasificación de texto está mejorando la automatización del servicio al cliente en el sector financiero. Los bancos y las empresas fintech utilizan chatbots impulsados por IA que clasifican y responden a las consultas de los clientes según su contenido. Esto reduce los tiempos de respuesta y mejora la experiencia general del cliente.
Desafíos y Limitaciones de la Clasificación de Texto
Si bien la clasificación de texto ofrece ventajas significativas, también enfrenta varios desafíos que impactan su precisión y efectividad. Un problema importante es la calidad de los datos. Los modelos de aprendizaje automático dependen de grandes conjuntos de datos para el entrenamiento, pero si estos conjuntos de datos están sesgados, incompletos o desactualizados, los resultados de la clasificación pueden ser inexactos o engañosos. Esto es particularmente preocupante en campos como las finanzas, donde las clasificaciones erróneas pueden llevar a malas decisiones de inversión o problemas de cumplimiento.
Otro obstáculo importante es la complejidad del lenguaje. El lenguaje humano es altamente matizado, con variaciones en jerga, contexto e incluso sarcasmo. Aunque el aprendizaje profundo ha mejorado la comprensión del texto, las máquinas aún tienen dificultades para interpretar el tono, las diferencias culturales y las sutiles señales lingüísticas. Esto hace difícil lograr clasificaciones consistentemente precisas, especialmente en industrias dinámicas donde el lenguaje evoluciona rápidamente.
Las actualizaciones constantes y el reentrenamiento son esenciales para que los modelos de clasificación de texto permanezcan relevantes. A medida que el lenguaje evoluciona, los modelos desactualizados corren el riesgo de clasificar incorrectamente el texto. Las actualizaciones regulares aseguran la precisión, pero requieren refinamiento de datos continuo, tiempo y experiencia. A pesar de estos desafíos, los avances en el aprendizaje automático y el procesamiento del lenguaje natural continúan mejorando la confiabilidad y efectividad de los sistemas de clasificación de texto.
Conclusión
La clasificación de texto está revolucionando cómo las empresas e instituciones financieras gestionan los datos textuales. Con el aprendizaje automático y el procesamiento del lenguaje natural, las empresas pueden automatizar la toma de decisiones, detectar fraudes y mejorar las interacciones con los clientes. Desde el análisis del sentimiento del mercado hasta el aseguramiento del cumplimiento normativo, esta tecnología optimiza las operaciones y mejora la precisión. Su capacidad para procesar grandes cantidades de información rápidamente la hace indispensable en el mundo orientado a los datos de hoy. A medida que la IA avanza, la clasificación de texto seguirá evolucionando, impulsando mayor eficiencia e innovación. Ya sea en finanzas, servicio al cliente o ciberseguridad, su impacto es innegable, convirtiéndola en una herramienta crucial para las industrias modernas que navegan en un paisaje cada vez más digital.
Artículos relacionados
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
IA Tradicional vs IA Generativa

IA en el Cuidado de la Salud: Avances Actuales y Oportunidades Futuras
Reutilización de Contenidos con IA: 5 Formas de Reutilizar tu Contenido para un Impacto Máximo
Cómo la Inteligencia Artificial está Transformando Sectores Tradicionales
Más de 20 Prompts de Imágenes AI que Realmente Funcionan para Campañas de Marketing
10 Proyectos de ChatGPT en una Hoja de Trucos
Transformando la Publicidad con Campañas Dirigidas Impulsadas por IA
Oracle Lanza Nuevo Estudio de Agentes de IA en la Suite Fusion
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
Implicaciones Éticas del Contenido Generado por IA en Medios y Arte
La Gran Divisoria de la IA: IA Simbólica vs. IA Subsimbólica—¿Cuál es la Diferencia?
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
