
Detección de Anomalías en Aprendizaje Automático: Descubriendo Patrones Ocultos en Datos
En esta página
Las máquinas son excelentes para identificar patrones, pero ¿qué sucede cuando algo no encaja? Ahí es donde la detección de anomalías juega un papel crucial. La detección de anomalías es el proceso de identificar puntos de datos raros, inusuales o sospechosos que se desvían de las tendencias esperadas. Desde detectar fraudes en la banca hasta predecir fallos en sistemas en fábricas, la detección de anomalías ayuda a las empresas a abordar problemas antes de que se agraven.
A diferencia de la detección tradicional basada en reglas, el aprendizaje automático permite descubrir anomalías ocultas en conjuntos de datos masivos con alta precisión. Ya sea un ciberataque, un diagnóstico médico o una máquina defectuosa, la detección temprana de anomalías puede marcar la diferencia entre la prevención y el desastre.
El Papel de la Detección de Anomalías
En la mayoría de las aplicaciones de la vida real, las anomalías son preocupaciones significativas que requieren resolución. Por ejemplo, en los servicios financieros, una anomalía puede indicar fraude financiero, mientras que en medicina, un patrón peculiar dentro de los datos médicos puede sugerir una enfermedad oscura y emergente. Por lo tanto, la detección de anomalías precisa y oportuna es crítica para una toma de decisiones e intervención efectivas y oportunas.
El aprendizaje automático es indispensable en la detección de anomalías, especialmente dada la creciente complejidad y volumen de datos. La detección manual de valores atípicos consume tiempo y es propensa a errores humanos. En contraste, los algoritmos de aprendizaje automático pueden detectar anomalías de manera más efectiva, a menudo identificando patrones que son extremadamente difíciles de localizar manualmente.
Al detectar anomalías, las empresas y organizaciones pueden responder a problemas potenciales más rápido y con mayor precisión. Este enfoque proactivo es particularmente beneficioso en sectores como la ciberseguridad, la atención médica y las finanzas, donde las anomalías a menudo indican riesgos u oportunidades que requieren atención urgente.
¿Cómo Funciona la Detección de Anomalías?
La detección de anomalías se enmarca comúnmente como un problema de aprendizaje automático supervisado o no supervisado. En la detección de anomalías supervisada, el modelo aprende de datos etiquetados donde el comportamiento normal y anómalo están predefinidos. Este enfoque es efectivo cuando los datos históricos contienen instancias conocidas de anomalías. Sin embargo, los datos etiquetados no siempre están disponibles, aquí es donde la detección de anomalías no supervisada se vuelve útil.
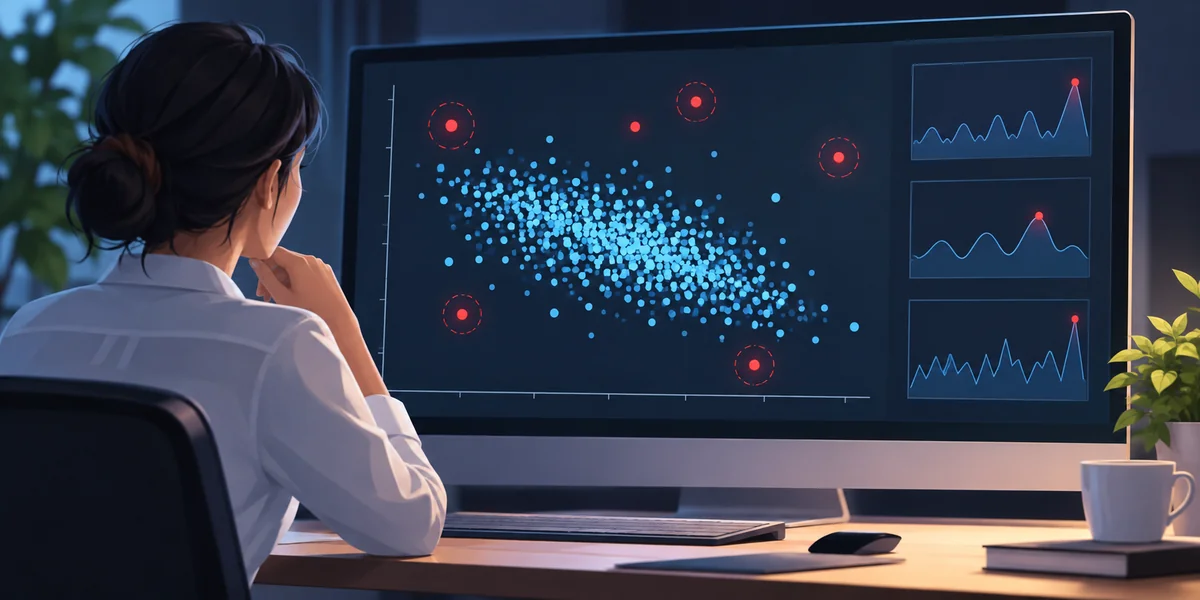
En la detección de anomalías no supervisada, el modelo no tiene etiquetas predefinidas para los puntos de datos. En su lugar, aprende los patrones normales en los datos e identifica cualquier cosa que se desvíe significativamente de este comportamiento como una anomalía. Este método es más flexible y aplicable a situaciones donde las anomalías no se definen fácilmente de antemano.
Ambos métodos, supervisados y no supervisados, dependen de algoritmos que pueden reconocer patrones subyacentes en los datos e identificar puntos estadísticamente diferentes. El objetivo no es solo encontrar valores atípicos, sino diferenciar entre variaciones normales en los datos y verdaderas anomalías que indican problemas potenciales.
Técnicas para la Detección de Anomalías
Existen varias técnicas de aprendizaje automático utilizadas para la detección de anomalías, cada una con sus fortalezas y debilidades. La elección de la técnica a menudo depende de la aplicación específica, el tipo de datos y el resultado deseado. A continuación, algunas de las técnicas más comúnmente utilizadas:
Métodos Estadísticos
Los métodos estadísticos asumen que los datos normales siguen una distribución conocida, como la Gaussiana. Calculan probabilidades y señalan puntos de datos fuera de un umbral como anomalías. Estos métodos funcionan bien para datos estructurados, pero tienen dificultades con conjuntos de datos complejos que no se ajustan a distribuciones estándar, limitando su efectividad en escenarios diversos del mundo real.
Métodos Basados en Distancia
Los métodos basados en distancia miden la proximidad de los puntos de datos. Si un punto está lejos de sus vecinos, se marca como una anomalía. Técnicas como k-nearest neighbors (k-NN) refinan esto analizando múltiples vecinos. Si bien son efectivos para datos estructurados, estos métodos se vuelven computacionalmente costosos a medida que el tamaño del conjunto de datos aumenta, limitando la escalabilidad.
Métodos Basados en Clustering
Los métodos de clustering, como k-means y DBSCAN, agrupan datos en clusters, asumiendo que los datos normales pertenecen a clusters densos. Los puntos que no encajan en clusters se marcan como anomalías. Estos métodos funcionan bien con agrupaciones estructuradas, pero tienen dificultades cuando los datos carecen de estructuras de clusters claras o exhiben un solapamiento significativo.
Isolation Forest
El algoritmo Isolation Forest aísla anomalías en lugar de modelar los datos normales. Construye árboles de decisión donde las anomalías son más fáciles de separar. Este método es altamente eficiente para grandes conjuntos de datos, requiriendo menos recursos computacionales que los enfoques tradicionales, lo que lo convierte en una opción popular para la detección de anomalías en tiempo real.
Autoencoders
Los autoencoders, un tipo de red neuronal, comprimen y reconstruyen datos, identificando anomalías a través de errores altos de reconstrucción. Son excelentes para capturar patrones ocultos, pero requieren grandes conjuntos de datos bien estructurados para el entrenamiento. Aunque son poderosos para tareas complejas de detección de anomalías, su dependencia del aprendizaje profundo los hace computacionalmente intensivos.
Aplicaciones de la Detección de Anomalías
La detección de anomalías se utiliza ampliamente en diversas industrias y campos. Aquí hay algunas aplicaciones comunes:
Detección de Fraude
Los bancos utilizan la detección de anomalías para señalar transacciones inusuales que se desvían de los patrones de gasto normales. Esto ayuda a prevenir el fraude activando alertas para la investigación o bloqueando automáticamente actividades sospechosas en tiempo real.
Ciberseguridad
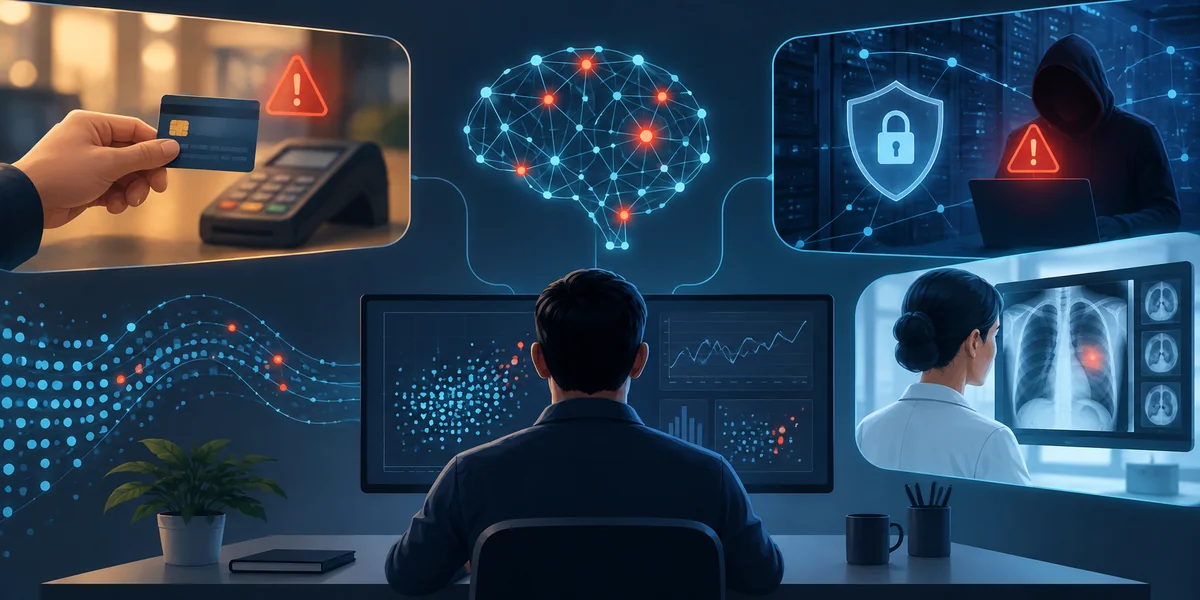
La detección de anomalías monitorea el tráfico de red y el comportamiento de los usuarios en busca de actividades sospechosas como intentos de hacking o violaciones de datos. Identificar amenazas en tiempo real mejora la seguridad al prevenir ciberataques antes de que ocurra un daño significativo.
Salud
La detección de anomalías médicas identifica registros de pacientes inusuales, enfermedades raras o patrones de imágenes anormales. Ayuda en el diagnóstico temprano, mejorando los resultados del tratamiento mientras asegura una toma de decisiones médicas más precisa para los profesionales de la salud.
Manufactura y Control de Calidad
Detectar defectos en productos utilizando la detección de anomalías previene que bienes defectuosos lleguen a los consumidores. Al monitorear datos de sensores, los fabricantes pueden identificar problemas temprano, minimizando el tiempo de inactividad de producción y mejorando la calidad general del producto.
Mantenimiento Predictivo
Al analizar datos de sensores de máquinas, la detección de anomalías predice fallas antes de que ocurran. Identificar señales de advertencia tempranas como cambios de temperatura reduce las averías de equipos, permitiendo un mantenimiento oportuno y reduciendo costos operativos.
Conclusión
La detección de anomalías en el aprendizaje automático es una herramienta vital para identificar patrones inusuales que podrían indicar problemas potenciales u oportunidades. Ya sea en finanzas, salud o ciberseguridad, detectar estas anomalías temprano puede llevar a decisiones más rápidas e informadas. Al aprovechar las técnicas de aprendizaje automático, las organizaciones pueden mejorar la eficiencia, reducir riesgos y abordar problemas de manera proactiva. A medida que la complejidad de los datos crece, el papel de la detección de anomalías se vuelve aún más esencial, asegurando que no se pierdan insights críticos en un panorama en constante evolución.
Artículos relacionados
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Máquinas de Vectores de Soporte (SVM): Cómo Impulsan los Modelos de Aprendizaje Automático
El Papel de la IA en la Analítica Deportiva: Transformando Datos en Perspectivas Revolucionarias
Una Guía Completa sobre Aprendizaje Supervisado vs. No Supervisado: Ventajas, Desventajas y Aplicaciones
Diferencias Clave entre Sesgo y Varianza en el Aprendizaje Automático
Redes Neuronales vs. Aprendizaje Profundo: Cómo Moldean la IA
El Papel de la IA en el Mantenimiento Predictivo para Reducir Tiempos de Inactividad y Costos
El Impacto de la IA en la Evaluación de Crédito: Préstamos Más Justos y Rápidos
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
Domina la Detección de IA con Estas 10 Herramientas Innovadoras
Equilibrando Modelos de IA: Comprendiendo el Sobreajuste y el Subajuste en el Aprendizaje Automático
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
