
Máquinas de Vectores de Soporte (SVM): Cómo Impulsan los Modelos de Aprendizaje Automático
En esta página
El aprendizaje automático ofrece una multitud de algoritmos diseñados para analizar datos, pero ninguno iguala la precisión de las Máquinas de Vectores de Soporte (SVM). Originalmente desarrolladas para clasificación, las SVM se han convertido en herramientas versátiles utilizadas para regresión, detección de anomalías y procesamiento de texto. Su capacidad para manejar datos de alta dimensionalidad las convierte en el algoritmo preferido cuando otras técnicas no son suficientes.
¿Pero qué contribuye al rendimiento excepcional de las SVM? El secreto radica en su habilidad para crear límites óptimos entre diferentes grupos en un conjunto de datos, logrando la mayor precisión de clasificación posible.
Entendiendo el Concepto Básico de SVM
En su núcleo, una Máquina de Vectores de Soporte busca encontrar la mejor línea divisoria—o límite de decisión—entre varias categorías en un conjunto de datos. Imagina dos categorías de objetos dispersos en un gráfico. Las SVM se esfuerzan por dibujar la línea más ideal, conocida como hiperplano, entre ellos. El objetivo es posicionar este límite de manera que se maximice la distancia entre los puntos más cercanos de cada categoría. Estos puntos cercanos se llaman "vectores de soporte", y juegan un papel crucial en la determinación del límite de decisión.
Este enfoque se llama maximización del margen. Un margen más amplio ayuda al modelo a generalizar mejor a nuevos datos, minimizando el riesgo de clasificación errónea. Mientras que los datos claramente separados hacen que esta tarea sea sencilla, los conjuntos de datos del mundo real a menudo contienen puntos superpuestos, valores atípicos o distribuciones no lineales, complicando la clasificación. Aquí, la fortaleza de las SVM en mapear datos a dimensiones más altas se vuelve invaluable.
Cómo las SVM Manejan Datos Complejos
No todos los problemas pueden resolverse con un límite lineal simple. Algunos conjuntos de datos requieren técnicas más sofisticadas para distinguir entre varios grupos. Las SVM abordan este desafío utilizando el truco del kernel. Este método permite a las SVM transformar datos en dimensiones más altas, donde se pueden separar más fácilmente por un límite.
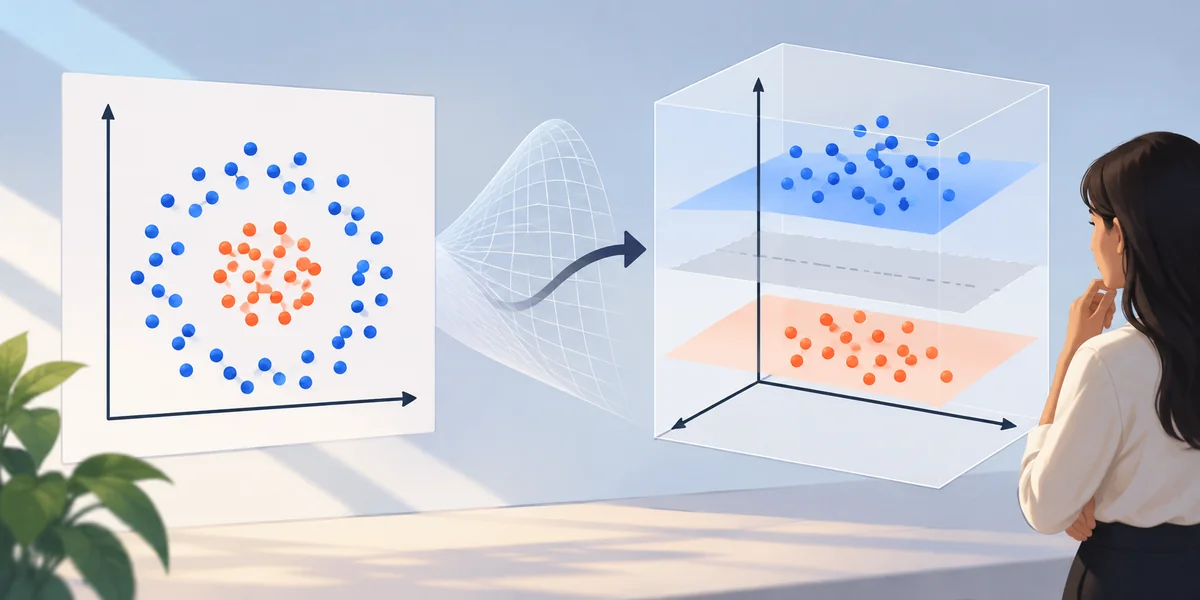
Si un conjunto de datos parece inseparable en dos dimensiones, por ejemplo, las SVM pueden proyectarlo en un espacio tridimensional donde emerge un límite claro. Las funciones de kernel comunes incluyen:
- Kernel Lineal: Ideal para casos donde los datos pueden separarse con una línea recta.
- Kernel Polinomial: Útil para relaciones más complejas entre puntos de datos.
- Kernel de Función de Base Radial (RBF): Eficaz para conjuntos de datos con patrones intrincados, creando límites de decisión flexibles.
- Kernel Sigmoide: Ocasionalmente utilizado para transformaciones inspiradas en redes neuronales.
Al seleccionar el kernel apropiado, las SVM pueden adaptarse a varias estructuras de datos, convirtiéndolas en una herramienta de aprendizaje automático altamente flexible.
Aplicaciones de SVM en el Mundo Real
La versatilidad de las SVM se extiende mucho más allá de las aplicaciones teóricas. Muchas industrias las utilizan para clasificar y predecir patrones en grandes conjuntos de datos. Una de las áreas más prevalentes es la clasificación de imágenes, donde las SVM ayudan a distinguir entre objetos en fotos, reconocer escritura a mano y detectar anomalías médicas en escaneos de MRI. Su capacidad para manejar datos de alta dimensionalidad las hace especialmente efectivas en tareas de detección de rostros y reconocimiento óptico de caracteres (OCR).
Otra aplicación significativa es en el reconocimiento de texto y voz. Los filtros de spam de correo electrónico, por ejemplo, a menudo dependen de las SVM para diferenciar entre mensajes legítimos y de basura. Del mismo modo, los sistemas de reconocimiento de voz utilizan SVM para identificar palabras y frases habladas con impresionante precisión.
En el sector financiero, las SVM identifican transacciones fraudulentas detectando patrones de gasto inusuales. Dado que la detección de fraudes implica reconocer desviaciones sutiles de las actividades normales, la capacidad de las SVM para manejar datos de alta dimensionalidad es particularmente beneficiosa.
Las SVM también juegan un papel vital en el cuidado de la salud. En la predicción de enfermedades, analizan registros médicos para identificar signos tempranos de condiciones como cáncer, enfermedades del corazón o diabetes. Al entrenar una SVM con extensos conjuntos de datos que contienen datos de pacientes anteriores, los médicos pueden hacer predicciones informadas sobre los riesgos de salud de un paciente.
Fortalezas y Limitaciones de SVM
Las SVM ofrecen varias ventajas, convirtiéndolas en una elección preferida para muchas tareas de aprendizaje automático. Su mayor fortaleza es su robustez para manejar datos de alta dimensionalidad. A diferencia de otros algoritmos que fallan con numerosas características, las SVM sobresalen incluso cuando los conjuntos de datos contienen miles de variables.
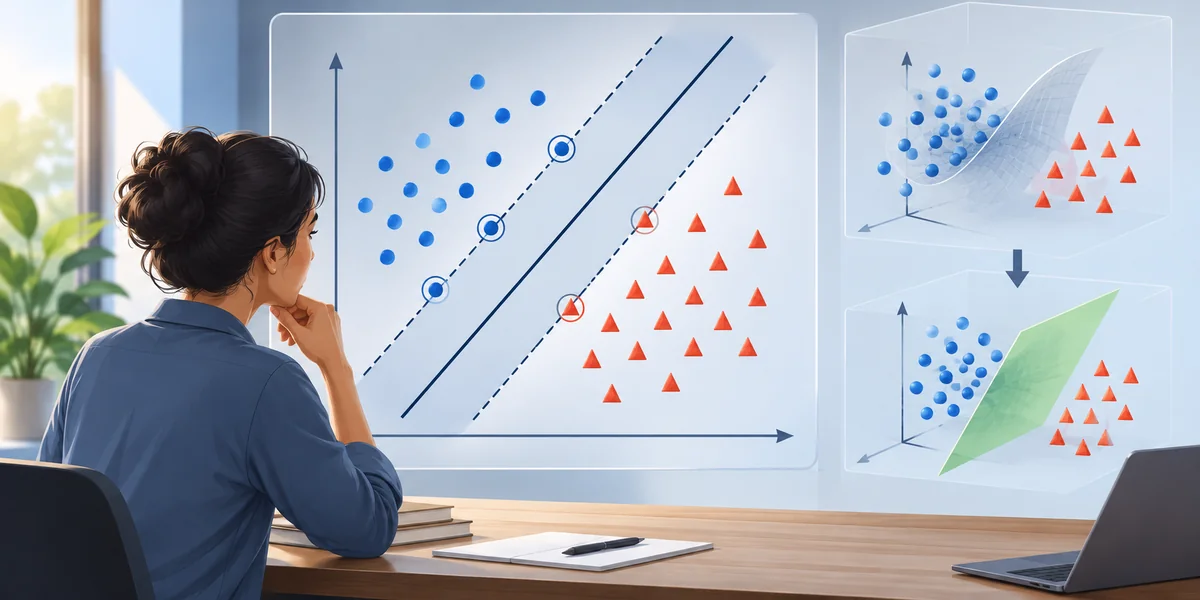
Otra ventaja significativa es su capacidad de generalización. Al maximizar el margen entre clases, las SVM a menudo producen modelos que funcionan bien con datos no vistos, reduciendo la probabilidad de sobreajuste. Además, las SVM son efectivas incluso con conjuntos de datos relativamente pequeños, lo que las convierte en una excelente opción cuando los datos etiquetados son limitados.
A pesar de estas fortalezas, las SVM no están exentas de limitaciones. Un desafío importante es la complejidad computacional. Entrenar una SVM, especialmente con kernels no lineales en grandes conjuntos de datos, puede ser un proceso que consume tiempo y requiere recursos computacionales sustanciales. Esto las hace menos prácticas para aplicaciones de grandes volúmenes de datos en comparación con algoritmos como el aprendizaje profundo.
Otra desventaja es su sensibilidad a los datos ruidosos. Dado que las SVM dependen mucho de los vectores de soporte, los valores atípicos pueden impactar significativamente en el límite de decisión. Si el conjunto de datos contiene ruido excesivo, las SVM pueden tener dificultades para generalizar efectivamente.
Finalmente, seleccionar la función de kernel correcta puede ser un desafío. Aunque las SVM ofrecen varias opciones de kernels, elegir la mejor para un conjunto de datos dado requiere ensayo y error. Una elección de kernel inadecuada puede llevar a resultados subóptimos, requiriendo experiencia en el dominio para ajustar el modelo de manera efectiva.
Conclusión
Las Máquinas de Vectores de Soporte siguen siendo un pilar del aprendizaje automático debido a su precisión excepcional, versatilidad y capacidad para manejar conjuntos de datos complejos. Ya sea clasificando imágenes, reconociendo texto, detectando fraudes o prediciendo enfermedades, las SVM han demostrado su fiabilidad en diversas aplicaciones. Su fortaleza radica en crear límites de decisión óptimos, especialmente en espacios de alta dimensionalidad. A pesar de los desafíos computacionales, las SVM continúan siendo una herramienta preferida para muchas tareas del mundo real, particularmente cuando los datos son limitados o se requiere alta precisión. A medida que el aprendizaje automático evoluciona, las SVM siguen siendo altamente relevantes, sirviendo como una poderosa alternativa a los métodos de aprendizaje profundo para numerosos problemas de clasificación y regresión.
Artículos relacionados
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
El Papel de la IA en el Mantenimiento Predictivo para Reducir Tiempos de Inactividad y Costos
El Impacto de la IA en la Evaluación de Crédito: Préstamos Más Justos y Rápidos
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Aprendizaje Automático: Modelos Listos para Usar o Personalizados - Pros y Contras
Explorando Cómo la IA Está Transformando el Trabajo de los Equipos Financieros Modernos
Herramientas de Aprendizaje Automático
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Redes Neuronales vs. Aprendizaje Profundo: Cómo Moldean la IA
Cómo Convertirse en Ingeniero de Machine Learning en 2025
Entrenadores de IA: El Puente Entre los Datos y la Inteligencia
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
