
Diferencias Clave entre Sesgo y Varianza en el Aprendizaje Automático
En esta página
Los modelos de aprendizaje automático dependen en gran medida de los datos, pero su éxito no se limita únicamente a ingresar más información. Un desafío importante en el entrenamiento de estos modelos es lograr el equilibrio adecuado entre sesgo y varianza. Un sesgo excesivo da como resultado un modelo demasiado simplificado incapaz de capturar patrones esenciales, mientras que una varianza alta hace que un modelo sea demasiado sensible a las fluctuaciones de los datos, lo que lleva a predicciones inexactas.
Este compromiso afecta significativamente la capacidad de un modelo para generalizar con nuevos datos no vistos. Lograr el equilibrio adecuado entre sesgo y varianza es crucial para desarrollar modelos que no sean ni demasiado rígidos ni demasiado erráticos. Comprender estos conceptos es vital para optimizar los algoritmos de aprendizaje automático y evitar trampas comunes como el sobreajuste y el subajuste.
Comprendiendo el Sesgo en el Aprendizaje Automático
El sesgo se refiere a la tendencia de un modelo a simplificar demasiado los problemas. Un modelo con alto sesgo asume reglas generales amplias sobre los datos, a menudo pasando por alto detalles importantes. Esto conduce al subajuste, donde el modelo no logra reconocer patrones relevantes, lo que resulta en malas predicciones tanto en los datos de entrenamiento como en los de prueba.
Un ejemplo típico de alto sesgo es aplicar regresión lineal a un conjunto de datos no lineal. Si la relación subyacente entre las variables es compleja pero el modelo asume que es lineal, no capturará la estructura real, resultando en errores significativos. De manera similar, los árboles de decisión con poda severa o redes neuronales poco profundas también pueden sufrir problemas de sesgo.
El sesgo a menudo surge de elegir un modelo demasiado simplificado o usar características limitadas. Por ejemplo, entrenar un clasificador de spam basado únicamente en la frecuencia de palabras podría no capturar efectivamente patrones sutiles del lenguaje. El objetivo es mantener cierto grado de sesgo para la generalización mientras se evita un modelo demasiado simplista.
La Varianza y su Impacto en los Modelos de Aprendizaje Automático
La varianza es lo opuesto al sesgo e indica la sensibilidad de un modelo a las variaciones en los datos de entrenamiento. Un modelo con alta varianza captura incluso las fluctuaciones menores, a menudo acomodando ruido en lugar de patrones reales. Esto lleva al sobreajuste, donde un modelo funciona excepcionalmente bien en los datos de entrenamiento pero mal en datos nuevos.
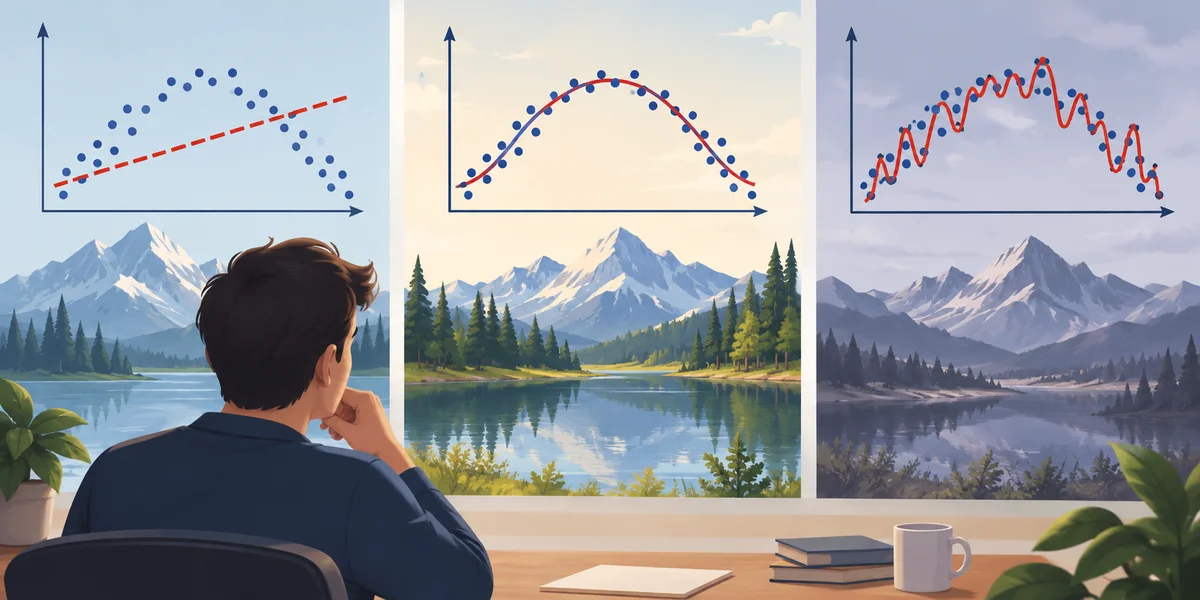
Considere entrenar una red neuronal profunda en un conjunto de datos pequeño. Si el modelo tiene demasiadas capas y parámetros, puede memorizar puntos de datos específicos en lugar de generalizar patrones. En consecuencia, puede fallar al hacer predicciones precisas cuando se prueba con nuevos ejemplos. Los árboles de decisión con divisiones profundas o los modelos de regresión polinómica con términos excesivos también experimentan alta varianza.
Un signo notable de problemas de varianza es una diferencia significativa entre el rendimiento de entrenamiento y prueba. Un modelo con precisión casi perfecta en los datos de entrenamiento pero malos resultados de prueba probablemente esté sobreajustado. Técnicas como la validación cruzada ayudan a detectar estas discrepancias y proporcionan formas de ajustar el modelo en consecuencia.
El Compromiso entre Sesgo y Varianza y la Generalización
Encontrar el equilibrio adecuado entre sesgo y varianza es crítico para desarrollar modelos de aprendizaje automático que funcionen bien en nuevos datos.
El Equilibrio entre Sesgo y Varianza
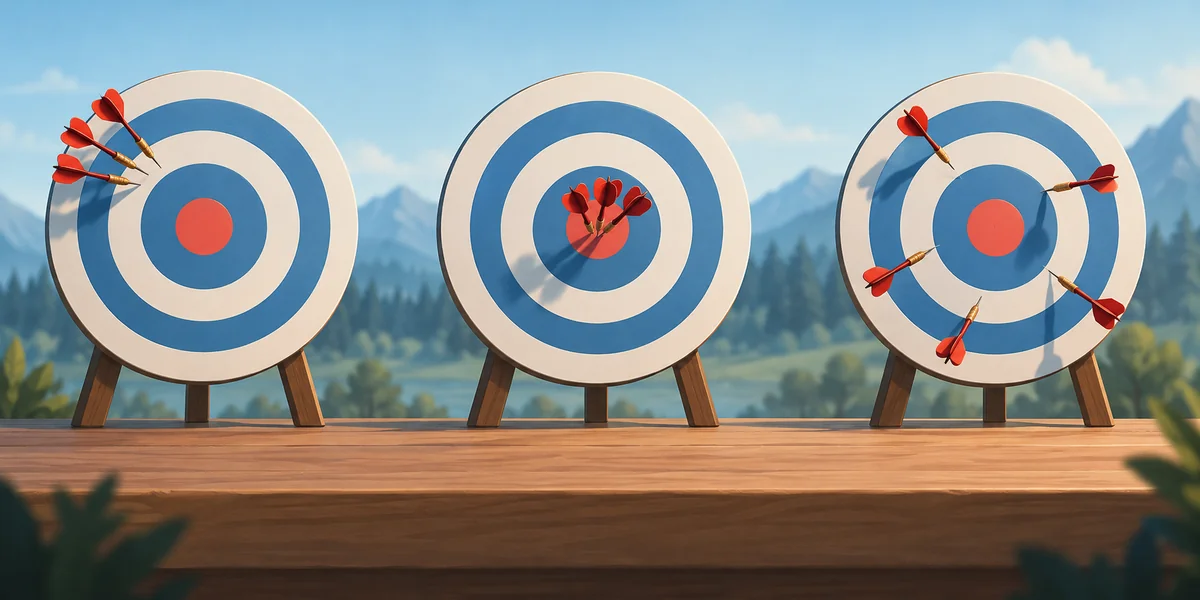
La relación entre sesgo y varianza crea un compromiso inevitable en el aprendizaje automático. Si un modelo es demasiado simple (alto sesgo), no aprenderá lo suficiente de los datos. Si es demasiado complejo (alta varianza), aprende demasiado, incluyendo ruido irrelevante. El modelo ideal encuentra un punto medio, equilibrando sesgo y varianza para lograr una generalización óptima.
Comprendiendo el Error de Generalización
El error de generalización, que comprende el error de sesgo, el error de varianza y el error irreducible, ayuda a visualizar este compromiso. Mientras que el error irreducible es el ruido inherente en los datos que ningún modelo puede eliminar, el objetivo es minimizar tanto el sesgo como la varianza.
Estrategias para Lograr el Equilibrio
Lograr este equilibrio implica varias estrategias. Las técnicas de regularización como las penalizaciones L1 (Lasso) y L2 (Ridge) reducen la varianza al restringir la complejidad del modelo. Los métodos de ensamblado, como el bagging y el boosting, combinan múltiples modelos débiles para mejorar la robustez. La selección de características garantiza que solo las entradas relevantes contribuyan al aprendizaje, evitando una complejidad innecesaria.
Ajustando los Datos de Entrenamiento y los Hiperparámetros
Otro enfoque es ajustar el volumen de datos de entrenamiento. Un modelo con alta varianza se beneficia de más datos, ya que ejemplos adicionales ayudan a suavizar las fluctuaciones. Por el contrario, un modelo con alto sesgo puede requerir características más expresivas o una arquitectura más compleja para mejorar el aprendizaje.
El ajuste fino de los hiperparámetros también desempeña un papel significativo. Para las redes neuronales, ajustar las tasas de aprendizaje, las capas de abandono o los tamaños de lote influye en cómo interactúan el sesgo y la varianza. Los árboles de decisión se benefician de establecer restricciones en la profundidad, mientras que las máquinas de vectores soporte requieren una cuidadosa selección de kernel para evitar el sobreajuste.
Estrategias para Reducir Sesgo y Varianza
Reducir el sesgo y la varianza requiere estrategias específicas adaptadas al problema en cuestión. Para la reducción de sesgo, aumentar la complejidad del modelo ayuda a capturar más patrones en los datos. Cambiar de regresión lineal a árboles de decisión o modelos de aprendizaje profundo puede mejorar el rendimiento cuando los modelos simples subajustan. Además, incorporar más características relevantes asegura que el modelo tenga suficiente información para aprender efectivamente.
Para la reducción de varianza, las técnicas de regularización evitan que los modelos memoricen el ruido. La regularización L1 y L2 penaliza los coeficientes grandes, asegurando modelos más simples y generalizables. La ampliación de datos y los métodos de abandono en el aprendizaje profundo ayudan a reducir el sobreajuste al exponer los modelos a más variaciones. La validación cruzada es una salvaguarda crucial, permitiendo la evaluación del rendimiento en diferentes subconjuntos de datos para detectar el sobreajuste temprano.
En última instancia, el equilibrio adecuado depende del problema, el tamaño del conjunto de datos y el tipo de modelo. La experimentación y el ajuste iterativo son esenciales para lograr un compromiso óptimo entre sesgo y varianza, lo que lleva a modelos de aprendizaje automático más precisos y generalizables.
Conclusión
Equilibrar el sesgo y la varianza es fundamental para crear modelos de aprendizaje automático que generalicen bien. Demasiado sesgo resulta en subajuste, donde el modelo simplifica demasiado los patrones, mientras que una varianza excesiva conduce al sobreajuste, haciendo que el modelo sea demasiado sensible a los datos de entrenamiento. La clave para resolver este desafío radica en ajustar la complejidad del modelo, regularizar parámetros y asegurar una calidad de datos adecuada. El compromiso es inevitable, pero con un ajuste cuidadoso, los modelos de aprendizaje automático pueden lograr alta precisión sin sacrificar la generalización. Comprender y gestionar este equilibrio asegura modelos robustos capaces de hacer predicciones confiables en aplicaciones del mundo real.
Artículos relacionados
La Verdad sobre Analítica Predictiva vs. Aprendizaje Automático: Cómo se Diferencian
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
Curva ROC en Aprendizaje Automático: Comprendiendo el Rendimiento del Modelo
Redes Neuronales vs. Aprendizaje Profundo: Cómo Moldean la IA
Explorando el Papel de la IA en Redes Inteligentes para una Gestión Eficiente de la Energía
El Papel de la IA en la Analítica Deportiva: Transformando Datos en Perspectivas Revolucionarias
Equilibrando Modelos de IA: Comprendiendo el Sobreajuste y el Subajuste en el Aprendizaje Automático
5 Maneras en que la Inteligencia Artificial está Transformando el E-Learning
Construyendo Mejores Modelos: La Batalla Entre el Sobreajuste y el Subajuste
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos
Una Guía para Bloquear Celdas en Excel Fácilmente y Proteger tus Datos Efectivamente
6 Robots Enfermeros con IA que Están Transformando el Cuidado de la Salud
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
