
Construyendo Mejores Modelos: La Batalla Entre el Sobreajuste y el Subajuste
En esta página
Los modelos de aprendizaje automático buscan realizar predicciones precisas reconociendo patrones en los datos. Sin embargo, lograr el equilibrio adecuado entre la complejidad del modelo y la generalización es esencial. El sobreajuste ocurre cuando un modelo se vuelve demasiado complejo, memorizando los datos de entrenamiento pero fallando en generalizar a nuevos datos.
Por el contrario, el subajuste resulta de un modelo débil que carece de patrones críticos y presenta un rendimiento pobre tanto en los datos de entrenamiento como en los de prueba. Comprender las diferencias entre el subajuste y el sobreajuste y cómo abordarlos es crucial para desarrollar modelos de aprendizaje automático estables que funcionen bien en aplicaciones del mundo real.
Sobreajuste: Cuando un Modelo Memoriza en Lugar de Aprender
El sobreajuste ocurre cuando un modelo de aprendizaje automático aprende el ruido y los detalles de los datos de entrenamiento de manera excesiva. En lugar de identificar los patrones subyacentes, memoriza los puntos de datos y se vuelve muy preciso con los datos de entrenamiento, pero poco confiable con datos nuevos e invisibles. Esto ocurre cuando un modelo es demasiado complejo en proporción al conjunto de datos, generalmente con demasiadas características o parámetros.
Piensa en estudiar para un examen memorizando todas las preguntas de un test de práctica en lugar de aprender los conceptos que representan. Puedes sobresalir en el test de práctica pero hacerlo mal en nuevas preguntas durante el examen real. Esto es precisamente lo que hace un modelo sobreajustado. Funciona increíblemente bien con los datos de entrenamiento pero no puede generalizar cuando se le presentan nuevos datos.
Un indicador importante de sobreajuste es una gran diferencia entre la precisión de entrenamiento y la de prueba. Cuando un modelo funciona bien en el conjunto de datos de entrenamiento pero rinde mal en los conjuntos de validación o prueba, está sobreajustando. Este problema es común al tratar con modelos de aprendizaje profundo, árboles de decisión o regresión polinómica de alto orden.
Existen varias estrategias para mitigar el sobreajuste. Simplificar el modelo reduciendo el número de características o parámetros lo hace menos complejo y, por lo tanto, menos propenso a ajustarse a todos los detalles idiosincráticos. Los métodos de regularización como la regresión L1 (lasso) y L2 (ridge) incluyen penalizaciones para modelos más complejos para que seleccionen solo patrones importantes. Aumentar el tamaño del conjunto de datos de entrenamiento también ayuda, ya que más datos proporcionan una representación más amplia de escenarios del mundo real, reduciendo la probabilidad de memorización. Además, técnicas como el dropout en redes neuronales desactivan aleatoriamente algunas neuronas durante el entrenamiento, evitando que el modelo dependa excesivamente de patrones específicos.
Subajuste: Cuando un Modelo No Aprende lo Suficiente
El subajuste es el problema opuesto. Ocurre cuando un modelo es demasiado simple para capturar los patrones subyacentes en los datos, lo que lleva a un rendimiento pobre tanto en los conjuntos de datos de entrenamiento como de prueba. Un modelo subajustado tiene un sesgo alto, lo que significa que hace suposiciones fuertes sobre los datos, a menudo resultando en predicciones demasiado simplistas.
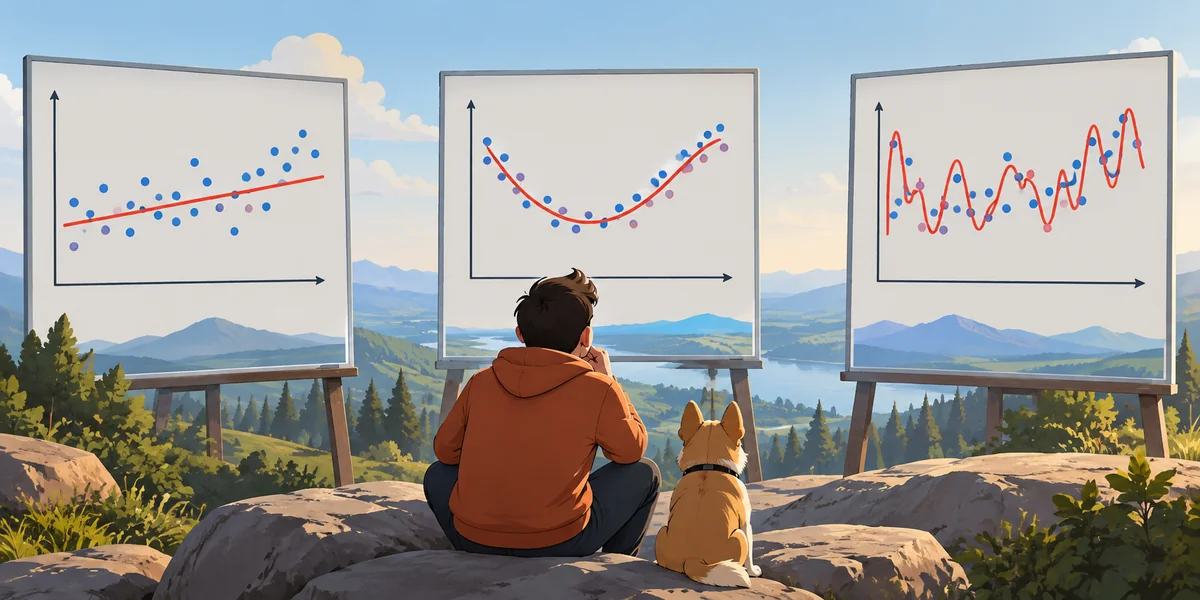
Piensa en tratar de reconocer escritura a mano pero solo prestando atención a la forma general de las palabras sin considerar las letras individuales. Si alguien escribe en un estilo ligeramente diferente, podrías tener dificultades para leerlo. Así es como se comporta un modelo subajustado: generaliza tanto que pierde detalles esenciales necesarios para predicciones precisas.
El subajuste es común al usar algoritmos demasiado simples, como la regresión lineal, para un conjunto de datos que requiere un enfoque más complejo. También puede ocurrir si un modelo se entrena durante muy pocas iteraciones, impidiendo que aprenda las relaciones más profundas en los datos.
Abordar el subajuste requiere aumentar la complejidad del modelo. Usar algoritmos más avanzados, como el aprendizaje profundo en lugar de una regresión simple, puede ayudar al modelo a aprender patrones intrincados. Agregar más características relevantes al conjunto de datos proporciona al modelo información adicional, permitiéndole hacer mejores predicciones. Aumentar el tiempo de entrenamiento y ajustar los hiperparámetros, como las tasas de aprendizaje y los tamaños de lote, también puede mejorar el rendimiento.
Encontrando el Equilibrio Adecuado
El desafío clave en el aprendizaje automático es encontrar el equilibrio adecuado entre el sobreajuste y el subajuste. Un buen modelo no debe ser ni demasiado simple ni demasiado complejo. Lograr este equilibrio requiere una cuidadosa selección de modelos, ingeniería de características y ajuste.
La validación cruzada es una de las técnicas más efectivas para asegurar que un modelo generalice bien. Al dividir el conjunto de datos en múltiples subconjuntos y entrenar el modelo en diferentes combinaciones, la validación cruzada proporciona una evaluación más precisa del rendimiento. Otro enfoque útil es la detención temprana, donde el entrenamiento se detiene cuando el rendimiento del modelo en los datos de validación deja de mejorar, previniendo el aprendizaje excesivo de los datos de entrenamiento.
El preprocesamiento de datos también juega un papel importante en la prevención tanto del sobreajuste como del subajuste. Normalizar valores numéricos, manejar datos faltantes y seleccionar características significativas puede mejorar significativamente el rendimiento del modelo. Asegurar un conjunto de datos diverso con varios escenarios del mundo real reduce el riesgo de que un modelo dependa demasiado de patrones específicos.
Los modelos de aprendizaje automático requieren refinamiento continuo. Probar diferentes algoritmos, ajustar hiperparámetros e incorporar nuevos datos puede mejorar su rendimiento con el tiempo. Al monitorear cuidadosamente las métricas de entrenamiento y validación, se vuelve más fácil detectar cuándo un modelo se está inclinando hacia el sobreajuste o el subajuste y tomar medidas correctivas.
Evaluando el Rendimiento del Modelo: Cómo Detectar el Sobreajuste y el Subajuste
Monitorear tanto el rendimiento de entrenamiento como el de validación es esencial para detectar el sobreajuste o el subajuste. El sobreajuste a menudo resulta en una brecha significativa entre una alta precisión de entrenamiento y un mal rendimiento de validación. Si el modelo se destaca en los datos de entrenamiento pero falla en los nuevos datos, probablemente esté sobreajustando. En contraste, el subajuste se manifiesta como un mal rendimiento tanto en los conjuntos de entrenamiento como de validación, lo que indica que el modelo no ha aprendido lo suficiente de los datos.
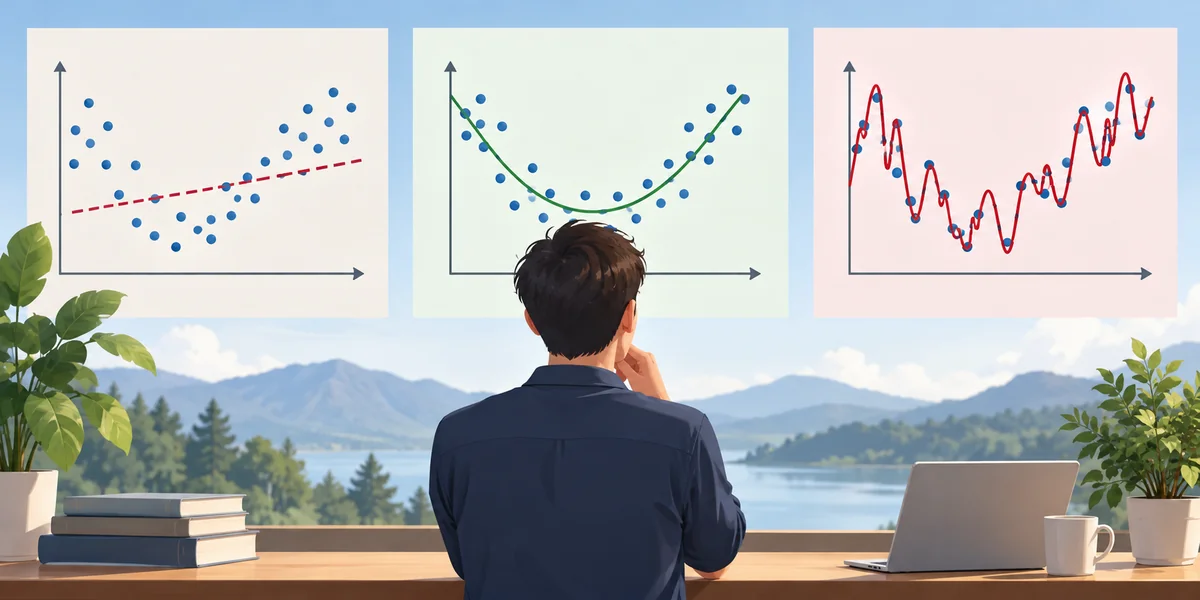
Técnicas como la validación cruzada, donde el conjunto de datos se divide en múltiples subconjuntos para entrenar y validar el modelo repetidamente, proporcionan una imagen más clara del rendimiento. La evaluación regular utilizando funciones de pérdida y métricas de precisión en datos no vistos ayuda a identificar cuándo son necesarias las ajustes para mejorar la generalización y prevenir el sobreajuste o el subajuste.
Conclusión
El sobreajuste ocurre cuando un modelo es demasiado complejo y memoriza los datos de entrenamiento, mientras que el subajuste sucede cuando un modelo es demasiado simple para capturar patrones significativos. Ambos resultan en un mal rendimiento. El objetivo es equilibrar estos extremos, creando modelos que generalicen bien. Técnicas como la validación cruzada, la regularización y la ingeniería de características ayudan a lograr este equilibrio. El refinamiento y la supervisión continuos permiten el desarrollo de modelos que funcionan de manera confiable en escenarios del mundo real, mejorando la precisión y eficiencia con el tiempo.
Artículos relacionados

11 Libros Que Todo Científico de Datos Debe Leer en 2025

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
Modelos de IA Descubiertos: La Tecnología Detrás de los Sistemas Inteligentes
Uso de NotebookLM de Google para Ciencia de Datos: Una Guía Completa
Aprendizaje Automático: Modelos Listos para Usar o Personalizados - Pros y Contras
Por qué el Deep Learning Puede No Ser la Solución Adecuada para Su Negocio
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas

Desempaquetando Hadoop vs. Spark: Perspectivas sobre el Procesamiento de Datos
Herramientas de Aprendizaje Automático
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
