
Desempaquetando Hadoop vs. Spark: Perspectivas sobre el Procesamiento de Datos
En esta página
En el mundo actual del big data, las empresas necesitan formas rápidas y fiables de procesar grandes cantidades de información. Hadoop y Spark son dos de los marcos más populares para gestionar estas tareas, pero cada uno tiene sus fortalezas. Mientras que Hadoop es conocido por su capacidad para almacenar y procesar conjuntos de datos masivos en múltiples máquinas, Spark va un paso más allá al ofrecer un procesamiento más rápido en memoria.
Ya sea que estés manejando procesamiento por lotes o datos en tiempo real, comprender las diferencias clave entre estas dos tecnologías es esencial para elegir la herramienta adecuada que impulse tus decisiones basadas en datos.
Entendiendo Hadoop
Hadoop fue una de las primeras innovaciones en el procesamiento de big data. Creado por la Apache Software Foundation, introdujo un método para almacenar y analizar grandes volúmenes de datos en varias máquinas. El marco se basa en el Hadoop Distributed File System (HDFS), que divide archivos grandes en piezas más pequeñas y las almacena en varios nodos de un clúster. Esto hace posible que Hadoop procese petabytes de datos de manera eficiente, convirtiéndose en la herramienta preferida para el procesamiento por lotes.
La esencia de Hadoop es su modelo de programación MapReduce. MapReduce descompone las tareas en sub-tareas más pequeñas, las procesa en paralelo y luego agrega los resultados. Aunque este proceso es lo suficientemente poderoso para el gran procesamiento, no es perfecto. La mayor crítica es la velocidad. Debido a que Hadoop lee y escribe en el disco en cada paso del procesamiento, se añade latencia, lo que descalifica a Hadoop para manejar sistemas en tiempo real. A pesar de esto, Hadoop sigue siendo un fuerte contendiente para almacenar y gestionar conjuntos de datos masivos, particularmente cuando la rentabilidad y la fiabilidad son las principales prioridades.
El Auge de Spark
Apache Spark surgió como una reacción a las limitaciones de Hadoop, específicamente la velocidad. Fue diseñado para manejar datos en memoria de modo que las lecturas y escrituras en disco no sean tan comunes. Este cambio en la arquitectura hace que Spark sea mucho más rápido que el MapReduce de Hadoop. Los benchmarks han demostrado que Spark es hasta 100 veces más rápido para algunas cargas de trabajo. A diferencia de Hadoop, que está orientado a lotes, Spark puede manejar varias cargas de trabajo, como flujos de datos en tiempo real, consultas interactivas y aprendizaje automático.
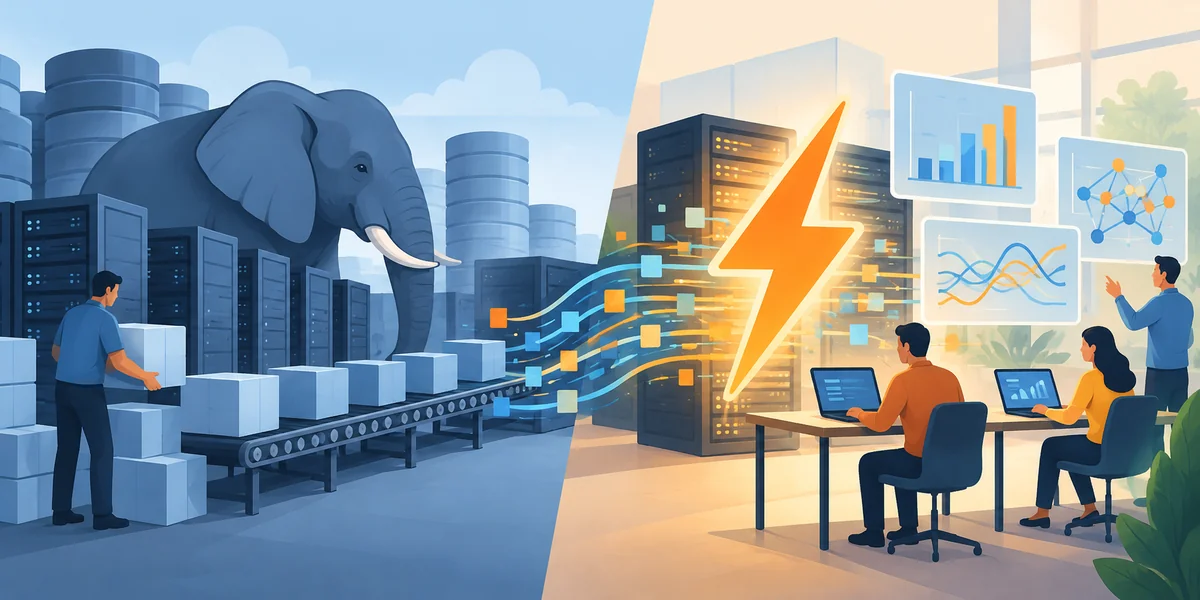
La potencia de Spark proviene de su abstracción Resilient Distributed Dataset (RDD). Los RDD permiten a Spark distribuir datos en un clúster manteniendo la tolerancia a fallos. Si un nodo falla, Spark puede recomputar los datos perdidos sin reiniciar todo el proceso. Esta característica lo hace más flexible y eficiente que el procesamiento por lotes tradicional basado en Hadoop. Además, Spark se integra con bibliotecas de aprendizaje automático, procesamiento de gráficos y consultas basadas en SQL, ampliando sus casos de uso más allá del simple almacenamiento y recuperación de datos.
Diferencias Clave y Casos de Uso
La principal distinción entre Hadoop y Spark radica en su diseño y en cómo manejan los datos. Ambos marcos tienen sus fortalezas, pero atienden a diferentes casos de uso y requisitos.
Velocidad de Procesamiento de Datos
Hadoop procesa datos en lotes y los escribe en disco después de cada operación, lo que lleva a una latencia. Esto puede ser más lento para trabajos complejos. Por otro lado, Spark realiza computación en memoria, manteniendo los datos en RAM durante el procesamiento. Esto se traduce en un análisis de datos más rápido, a menudo hasta 100 veces más rápido que Hadoop para ciertas tareas. La velocidad de Spark lo hace ideal para análisis en tiempo real, modelos de aprendizaje automático y aplicaciones donde las percepciones inmediatas son esenciales, mientras que el ritmo más lento de Hadoop se adapta a trabajos de procesamiento por lotes.
Almacenamiento y Escalabilidad
El HDFS (Hadoop Distributed File System) de Hadoop está diseñado para almacenamiento a gran escala, capaz de manejar petabytes de datos en varios nodos. Almacena eficientemente tanto datos estructurados como no estructurados, lo que lo hace ideal para necesidades de almacenamiento masivo y a largo plazo. Spark, en contraste, no tiene un sistema de almacenamiento y depende de sistemas externos como HDFS o S3 para el almacenamiento de datos. Mientras que Spark es escalable, Hadoop sigue siendo la solución más confiable para organizaciones que necesitan almacenar grandes conjuntos de datos a lo largo del tiempo, asegurando una recuperación y procesamiento fáciles.
Casos de Uso para Hadoop
Hadoop es excelente para casos de uso que involucran grandes conjuntos de datos, especialmente cuando los resultados en tiempo real no son críticos. Es ideal para el procesamiento de logs, donde analizar registros de servidores o aplicaciones se puede hacer en lotes sin demora. Hadoop también sobresale en almacenamiento de datos al gestionar y procesar enormes volúmenes de datos históricos. Las tuberías ETL (Extracción, Transformación, Carga) son otro caso de uso común de Hadoop, ya que pueden extraer datos, transformarlos y cargarlos en bases de datos para un análisis posterior sin restricciones de tiempo real.
Casos de Uso para Spark
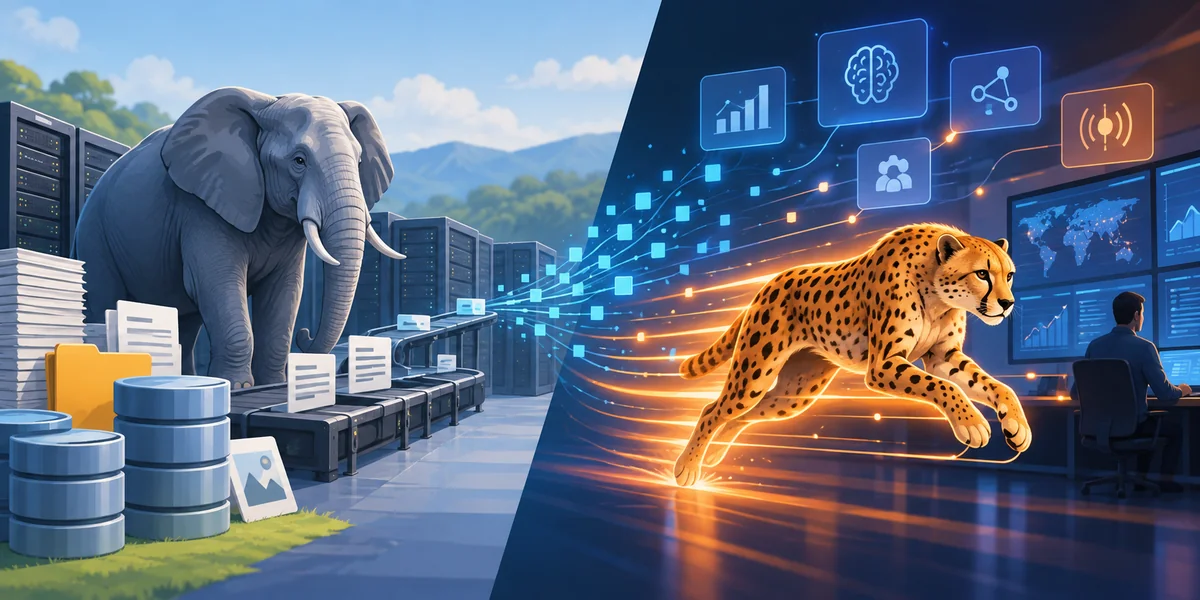
Spark es ideal para el procesamiento en tiempo real y obtener conocimientos rápidos. Se utiliza a menudo para análisis en tiempo real, como sistemas de detección de fraude o motores de recomendación, donde la velocidad es crucial. El aprendizaje automático se beneficia del MLlib incorporado de Spark, lo que permite un análisis de datos escalable y desarrollo de modelos. Además, el procesamiento de datos en streaming con Spark Streaming lo hace perfecto para analizar datos en vivo de fuentes como redes sociales, sensores y dispositivos IoT. La flexibilidad y velocidad de Spark le permiten manejar aplicaciones que necesitan resultados inmediatos y procesamiento de datos iterativo.
Integración y Ecosistema
El ecosistema de Hadoop incluye herramientas como Hive para consultas, Pig para scripting y HBase para almacenamiento NoSQL. Estas se integran sin problemas para el procesamiento por lotes a gran escala y la gestión de datos. Spark, aunque no es una solución de almacenamiento, es altamente adaptable y puede integrarse con el ecosistema de Hadoop. El soporte flexible de API de Spark para Java, Python, Scala y R permite a los desarrolladores trabajar con el marco en el lenguaje de su elección. La capacidad de usar tanto Hadoop como Spark juntos permite a las empresas aprovechar el almacenamiento de Hadoop y la velocidad de Spark para flujos de trabajo de datos más dinámicos y poderosos.
Conclusión
La elección entre Hadoop y Spark depende de las necesidades de una organización. Hadoop ofrece una solución rentable para almacenamiento y procesamiento por lotes, lo que lo hace ideal para la gestión de datos a largo plazo. Spark, con su procesamiento en memoria, proporciona análisis más rápidos, por lo que es más adecuado para aplicaciones en tiempo real. Aunque Spark supera a Hadoop en velocidad y flexibilidad, sus mayores demandas de hardware pueden ser una limitación. A menudo, la mejor estrategia es usar ambos juntos, aprovechando las capacidades de almacenamiento de Hadoop con el poder analítico de Spark. En última instancia, la decisión depende de la escala, la velocidad y las consideraciones presupuestarias de las tareas impulsadas por datos en cuestión.
Artículos relacionados

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Microsoft Drasi: Herramienta de Código Abierto para la Gestión de Cambios en Tiempo Real
Uso de NotebookLM de Google para Ciencia de Datos: Una Guía Completa
La Gran Divisoria de la IA: IA Simbólica vs. IA Subsimbólica—¿Cuál es la Diferencia?
Estadísticas Prácticas: 10 Repositorios de GitHub que te Ayudan a Aprender
La IA en la Verificación de Identidad: Prevención de Fraude y Seguridad de Datos
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
