
Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
En esta página
Los sistemas de IA tienen éxito al utilizar datos de alta calidad durante el entrenamiento. Los datos de calidad conducen a pronósticos confiables, perspectivas fidedignas y decisiones acertadas, mientras que la información mal mantenida resulta en resultados defectuosos y modelos sesgados, potencialmente dañando reputaciones. Las organizaciones que aprovechan la IA para la innovación deben comprender y abordar los problemas fundamentales de calidad de datos, ya que su éxito depende de ello. Este artículo explora nueve problemas cruciales de calidad de datos en sistemas de IA y ofrece soluciones metódicas para ayudar a los usuarios a lograr resultados óptimos.
Por Qué la Calidad de Datos Importa en la IA
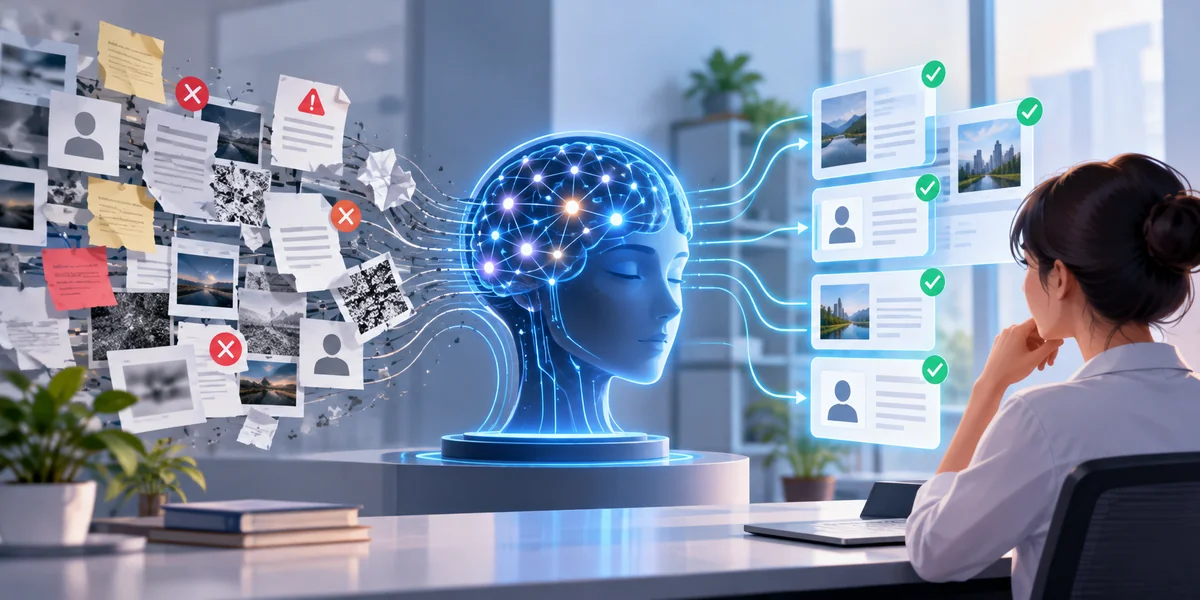 La fiabilidad de la IA depende totalmente de la calidad de los datos utilizados para construir los sistemas de IA. Los modelos de IA funcionan mal cuando procesan datos de baja calidad debido a información faltante, detalles incorrectos, elementos sesgados o características obsoletas. Estos problemas ilustran la importancia de mantener datos de alta calidad a lo largo del proceso de desarrollo de IA.
Las organizaciones deben abordar los desafíos comunes de calidad de datos para optimizar eficazmente los sistemas de IA y reducir los riesgos operativos.
9 Problemas Comunes de Calidad de Datos en IA
1. Datos Incompletos
El entrenamiento preciso del modelo requiere toda la información esencial dentro de los conjuntos de datos. Los valores de datos faltantes crean brechas que conducen a predicciones inexactas, reduciendo la fiabilidad del modelo. Por ejemplo, un sistema de IA en salud necesita información demográfica de los pacientes para evitar generar diagnósticos incorrectos.
Para garantizar conjuntos de datos completos, establezca métodos robustos de recolección de datos. Las técnicas de imputación pueden llenar brechas sin distorsionar los resultados.
2. Datos Inexactos
Los datos inexactos surgen de errores durante el proceso de recolección e inexactitudes de medición, lo que lleva a resultados inválidos en los modelos de IA. Esto puede resultar en problemas graves como errores financieros y diagnósticos médicos incorrectos.
Emplee tanto auditorías automatizadas como manuales para detectar y corregir errores en los conjuntos de datos antes de las sesiones de entrenamiento.
3. Datos Obsoletos
Los datos se vuelven obsoletos cuando ya no reflejan las realidades actuales, llevando a los tomadores de decisiones a basar sus elecciones en información irrelevante. Usar tendencias de mercado obsoletas en análisis predictivos puede resultar en malas decisiones empresariales.
Programe actualizaciones regulares para los conjuntos de datos para mantener su relevancia. Utilice sistemas automáticos de flujos de datos cuando sea posible.
4. Datos Irrelevantes o Redundantes
Puntos de datos sin significado o información redundante pueden confundir a los sistemas de aprendizaje, degradando la precisión debido a elementos especulativos. La retroalimentación de clientes no relacionada en el análisis de sentimientos puede disminuir las perspectivas valiosas.
Utilice métodos de selección de características para identificar variables innecesarias, seguido de la consolidación de información para crear formatos de datos útiles.
5. Datos Mal Etiquetados
El aprendizaje supervisado depende en gran medida de conjuntos de datos con etiquetas específicas. Los errores de etiquetado conducen a asignaciones de clase incorrectas, haciendo que los algoritmos desarrollen patrones defectuosos.
Implemente equipos de anotadores profesionales y herramientas automatizadas con marcos de aprendizaje activo para lograr datos etiquetados de alta calidad.
6. Datos Sesgados
El sesgo de datos resulta de distribuciones de grupos desequilibradas en los conjuntos de datos, llevando a patrones de procesamiento discriminatorios. Los sistemas de reconocimiento facial, por ejemplo, pueden no identificar a individuos de piel más oscura debido a sesgos raciales en los datos de entrenamiento.
Recoja datos de entrenamiento de poblaciones diversas utilizando múltiples fuentes demográficas. Las auditorías regulares de sesgo son cruciales para descubrir posibles fuentes de sesgo.
7. Envenenamiento de Datos
El envenenamiento de datos involucra actividad maliciosa donde atacantes introducen datos defectuosos en bases de datos, resultando en resultados de entrenamiento sesgados.
Protéjase contra el envenenamiento con sistemas de detección de anomalías para monitorear patrones inusuales en los conjuntos de datos durante la preparación. Las auditorías regulares de la integridad de los datos de entrenamiento son esenciales.
8. Bucles de Retroalimentación de Datos Sintéticos
Los datos sintéticos se utilizan cada vez más para la expansión de conjuntos de datos, pero la dependencia excesiva puede crear bucles de retroalimentación, desconectando modelos de condiciones del mundo real.
Utilice datos sintéticos junto con datos reales y valide los resultados sintéticos contra observaciones del mundo real.
9. Falta de Marcos de Gobernanza
La calidad de datos inconsistente a menudo resulta de la ausencia de marcos de gobernanza adecuados, lo que lleva a problemas de separación de datos y errores de integración.
Desarrolle políticas de gobernanza comprensivas para unificar sistemas operativos a través de departamentos y asegurar el cumplimiento con los estándares GDPR y HIPAA.
Consecuencias de la Mala Calidad de Datos
- La mala calidad de datos puede dañar el software, perjudicar reputaciones y erosionar la confianza, causando pérdidas financieras.
- Los datos de entrada defectuosos en modelos de entrenamiento resultan en resultados impredecibles, impactando la toma de decisiones organizacionales.
- El comportamiento de IA que ofende o muestra sesgo puede provocar indignación pública, socavando la posición de mercado de una empresa.
- El incumplimiento de estándares legales debido a una mala gobernanza puede llevar a sanciones regulatorias.
Las organizaciones deben implementar medidas preventivas a lo largo del ciclo de vida de la IA, desde la recolección de datos hasta el monitoreo posterior al despliegue.
Mejores Prácticas para Asegurar Datos de Alta Calidad en IA
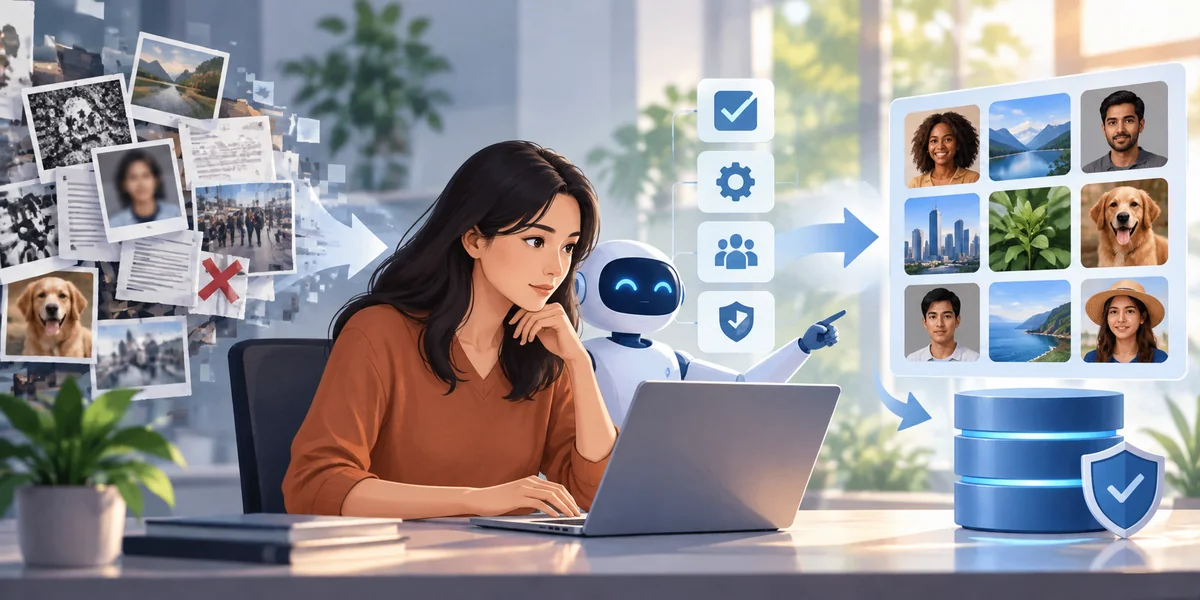 Para abordar los problemas comunes relacionados con la calidad de datos deficiente, las organizaciones deben seguir estas mejores prácticas:
1. Establecer Estándares Claros
Establezca directrices basadas en proyectos para determinar niveles de datos de alta calidad definiendo objetivos de precisión y parámetros de representatividad.
2. Automatizar Controles de Calidad
Habilite mecanismos de detección automatizada y scripts de validación para identificar errores sin intervención humana.
3. Invertir en Diversidad
Entrene modelos de datos con conjuntos de datos de grupos de población diversos y situaciones de la vida real para reducir sesgos y mejorar la aplicabilidad universal.
4. Implementar Políticas de Gobernanza
Establezca procesos estandarizados que aseguren la adherencia a los estándares GDPR y HIPAA a través de marcos estructurados.
5. Monitorear Continuamente
Incluya evaluaciones de rendimiento regulares y retroalimentación de usuarios en evaluaciones posteriores al despliegue para ajustar las entradas del sistema basadas en los resultados del análisis.
6. Usar Datos Sintéticos de Manera Responsable
Utilice datos sintéticos con cautela para mejorar los conjuntos de datos de entrenamiento, validando nuevos puntos de datos contra observaciones del mundo real antes del despliegue.
Conclusión
La calidad de datos es crucial para desarrollar sistemas de IA exitosos. Las empresas en sectores como la salud y las finanzas deben priorizar la calidad de datos para asegurar el logro técnico, el comportamiento ético y resultados sostenibles. La alta calidad de datos es esencial para las organizaciones que buscan crear sistemas de IA confiables con innovación responsable.
Artículos relacionados
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Reutilización de Contenidos con IA: 5 Formas de Reutilizar tu Contenido para un Impacto Máximo
Cómo la Representación del Conocimiento en la IA Construye Sistemas más Inteligentes
Medir la Adopción e Impacto de la IA
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles
IA Tradicional vs IA Generativa
Más de 20 Prompts de Imágenes AI que Realmente Funcionan para Campañas de Marketing
Construyendo un Chatbot de IA: Una Guía Paso a Paso

IA en el Cuidado de la Salud: Avances Actuales y Oportunidades Futuras
La Gran Divisoria de la IA: IA Simbólica vs. IA Subsimbólica—¿Cuál es la Diferencia?
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
