
Pérdida Hinge en Aprendizaje Automático: Perspectivas Clave y Aplicaciones
En esta página
En el mundo del aprendizaje automático, entrenar un modelo para hacer predicciones precisas implica elegir la función de pérdida adecuada. Una función de pérdida es una forma matemática de medir qué tan bien se alinean las predicciones de un modelo con los resultados reales. Una función de pérdida popular, especialmente en tareas de clasificación, es la pérdida hinge.
Algunos métodos poderosos utilizados para clasificación y regresión son las Máquinas de Vectores de Soporte (SVMs) y la pérdida hinge. El objetivo principal de la pérdida hinge es localizar un límite de decisión que asigne correctamente los puntos de datos a las clases mientras deja suficiente espacio entre las clases. En la clasificación binaria, ayuda a hacer un modelo de aprendizaje automático más preciso. La publicación de hoy hablará sobre la idea de la pérdida hinge, cómo funciona, sus beneficios y su papel en el aprendizaje automático.
¿Qué es la Pérdida Hinge?
La pérdida hinge, también conocida como pérdida de margen máximo, es una función de pérdida utilizada principalmente para tareas de clasificación binaria. Anima al modelo a clasificar correctamente los puntos de datos mientras mantiene un margen de separación entre las clases. Este margen es crucial ya que ayuda a que el modelo sea más robusto ante ligeras variaciones en los datos de entrada.
Matemáticamente, la pérdida hinge se puede definir como:
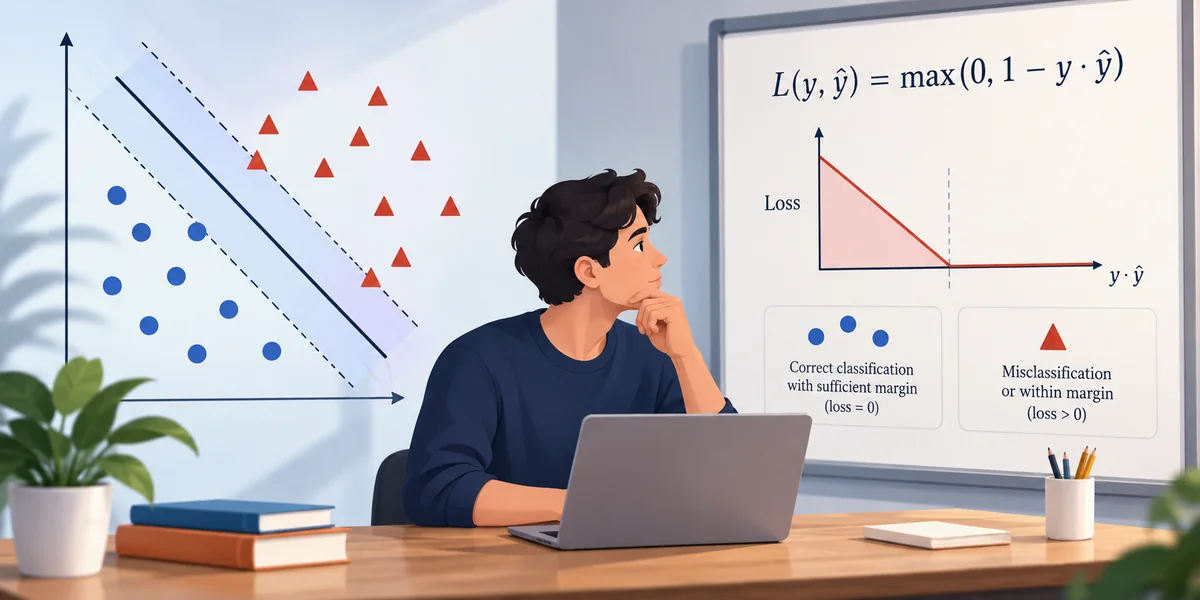
L(y, \(\hat{y}\)) = \(\max(0, 1 - y \cdot \hat{y})\)
Dónde:
- \(y\) es la etiqueta real del punto de datos (ya sea +1 o -1 para clasificación binaria).
- \(\hat{y}\) es la puntuación predicha por el modelo (no la clasificación final, sino una puntuación en bruto que se puede comparar con el umbral de decisión).
- El término \(1 - y \cdot \hat{y}\) mide qué tan lejos está la predicción de la clasificación correcta.
No hay pérdida hinge si la predicción es correcta y segura (es decir, el margen es mayor o igual a 1). Sin embargo, la pérdida es mayor si la estimación es incorrecta o insegura.
¿Por Qué es Importante la Pérdida Hinge en Aprendizaje Automático?
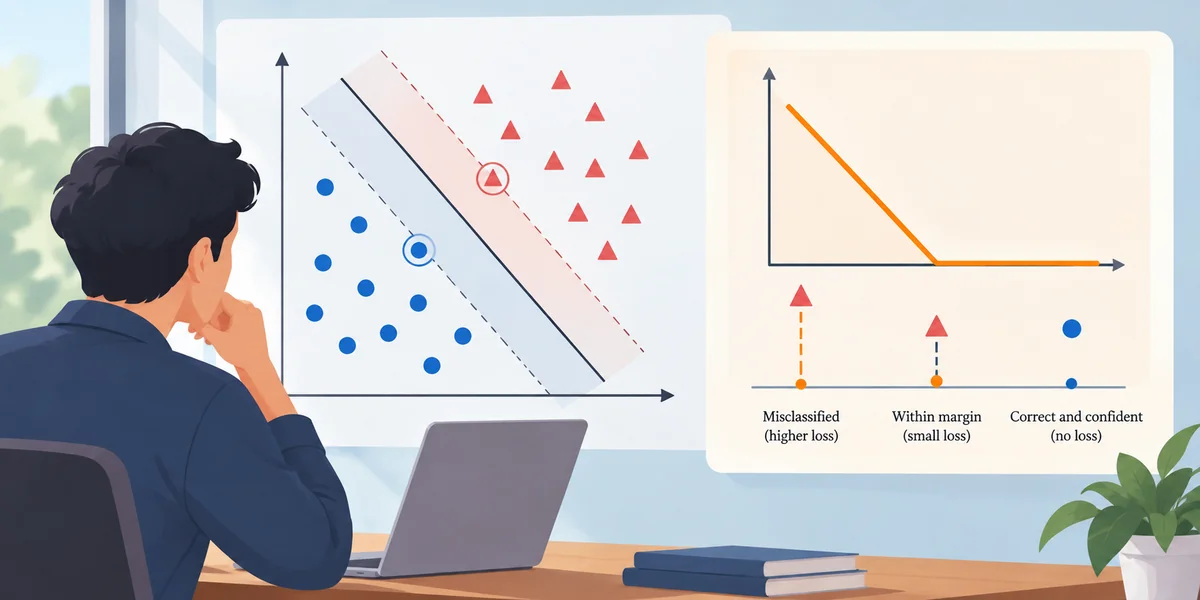
La importancia de la pérdida hinge radica en su capacidad para optimizar el margen entre las clases. Cuando el modelo hace una predicción, el objetivo no solo es clasificar correctamente sino asegurar que la clasificación sea confiada y con un margen de separación. Este concepto es central en el algoritmo de Máquina de Vectores de Soporte (SVM), que se centra en maximizar el margen entre el límite de decisión y los puntos de datos más cercanos de cada clase.
Algunas razones clave por las que la pérdida hinge es esencial en el aprendizaje automático incluyen:
- Mejor Generalización: Al maximizar el margen entre clases, el modelo puede generalizar mejor a datos no vistos.
- Manejo de Violaciones de Margen: La pérdida hinge penaliza las predicciones que no son lo suficientemente seguras, obligando al modelo a centrarse en puntos clasificados con confianza.
- Simplicidad: La pérdida hinge es relativamente simple de calcular e implementar, lo que la convierte en una opción ampliamente utilizada para problemas de clasificación.
Pérdida Hinge en Máquinas de Vectores de Soporte (SVMs)
Las Máquinas de Vectores de Soporte (SVMs) son uno de los algoritmos de aprendizaje automático más populares que utilizan la pérdida hinge. Las SVMs funcionan encontrando el hiperplano óptimo (un límite de decisión) que separa las clases mientras maximiza el margen entre ellas. El margen es la distancia entre el límite de decisión y los puntos de datos más cercanos de cada clase, conocidos como vectores de soporte.
En el contexto de las SVMs, la pérdida hinge juega un papel significativo en determinar qué tan bien está colocado el límite de decisión. La SVM intenta mantener la pérdida hinge lo más baja posible mientras aumenta el margen. Esto proporciona la mejor generalización en datos que no se han visto aún.
Aspectos clave de cómo funciona la pérdida hinge en las SVMs:
- Si un punto de datos está en el lado correcto del límite de decisión y tiene un margen mayor a 1, la pérdida hinge es cero.
- Si un punto de datos está mal clasificado o cae dentro del margen (es decir, no es lo suficientemente seguro), la pérdida hinge aumenta.
- El objetivo es encontrar un equilibrio entre minimizar la pérdida hinge y maximizar el margen.
Cómo Funciona la Pérdida Hinge: Paso a Paso
Desglosemos los pasos involucrados en la pérdida hinge:
- Predicción: El modelo predice calculando una puntuación (\(\hat{y}\)) basada en los datos de entrada.
- Decisión de Clasificación: Si la puntuación \(\hat{y}\) es mayor que 0, el modelo predice la clase positiva (+1), y si es menor que 0, se predice la clase negativa (-1).
- Cálculo de la Pérdida: La función de pérdida hinge compara la puntuación predicha con la etiqueta real \(y\). Si la predicción es correcta y tiene un margen de al menos 1, la pérdida es cero. De lo contrario, aumenta dependiendo de qué tan lejos esté la predicción de la etiqueta correcta.
Ejemplos de Pérdida Hinge
Tomemos un par de ejemplos para entender mejor cómo funciona la pérdida hinge:
Ejemplo 1: Predicción Correcta y Segura
- Etiqueta real \(y = 1\) (clase positiva)
- Puntuación predicha \(\hat{y} = 2\)
Dado que la predicción es correcta y segura (es decir, \(\hat{y} > 1\)), la pérdida hinge es:
L(y, \(\hat{y}\)) = \(\max(0, 1 - 1 \cdot 2) = 0\)
Ejemplo 2: Clasificación Incorrecta
- Etiqueta real \(y = 1\) (clase positiva)
- Puntuación predicha \(\hat{y} = -1\)
La predicción es incorrecta (es decir, \(\hat{y} < 0\)), por lo que la pérdida hinge será:
L(y, \(\hat{y}\)) = \(\max(0, 1 - 1 \cdot (-1)) = 2\)
La pérdida hinge es 2 porque la predicción fue completamente incorrecta y no segura.
Ventajas de la Pérdida Hinge
La pérdida hinge tiene varias ventajas que la hacen particularmente útil para ciertos tipos de problemas de clasificación:
- Robustez ante Valores Atípicos: Dado que la pérdida hinge se centra en el margen en lugar de predicciones exactas, es menos sensible a valores atípicos.
- Claro Margen de Separación: Intenta explícitamente maximizar el margen entre clases, lo cual es una buena estrategia para asegurar límites de clase claros.
- Efectividad para Conjuntos de Datos Grandes: La pérdida hinge funciona bien para conjuntos de datos a gran escala, haciéndola adecuada para una variedad de aplicaciones del mundo real, como la clasificación de texto y el reconocimiento de imágenes.
Conclusión
La pérdida hinge es un componente crítico del aprendizaje automático, particularmente en el entrenamiento de modelos como las Máquinas de Vectores de Soporte (SVMs) que se centran en tareas de clasificación. Su principal fortaleza radica en maximizar el margen entre clases, al tiempo que penaliza las predicciones incorrectas. Asegura que el modelo pueda generalizar bien a datos no vistos y hacer predicciones confiadas y precisas. Ya sea que estés trabajando con clasificación binaria o construyendo un modelo robusto para una tarea más compleja, entender la pérdida hinge puede ayudarte a tomar mejores decisiones sobre funciones de pérdida y optimización de modelos.
Artículos relacionados
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
6 Robots Enfermeros con IA que Están Transformando el Cuidado de la Salud
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
Herramientas de Aprendizaje Automático
Medir la Adopción e Impacto de la IA
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información

IA en el Cuidado de la Salud: Avances Actuales y Oportunidades Futuras
Visualizando Patrones: 2 Métodos para Crear un Mapa de Calor en Power BI

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Herramientas de IA para Profesores: Identificando Brechas de Aprendizaje con Precisión
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
