
Comprendiendo la Matriz de Confusión: Una Herramienta Clave en el Aprendizaje Automático
En esta página
Una matriz de confusión es una tabla utilizada en el aprendizaje automático para medir el rendimiento de un modelo de clasificación. Contrasta los resultados reales con los predichos, dividiéndolos en cuatro clases: Verdaderos Positivos (TP), Verdaderos Negativos (TN), Falsos Positivos (FP) y Falsos Negativos (FN). Esta herramienta proporciona más información que la simple precisión porque indica dónde fallan las predicciones.
Analizar estas categorías revela las fortalezas y debilidades de un modelo, facilitando mejoras. La matriz de confusión juega un papel crucial en la optimización de modelos de aprendizaje automático para predecir con mayor precisión, especialmente en tareas críticas como diagnósticos médicos o detección de fraudes.
Desglosando la Matriz de Confusión
Una matriz de confusión desglosa las predicciones en cuatro categorías clave, ayudando a revelar qué tan bien está funcionando un modelo:
- Verdaderos Positivos (TP): El modelo predice correctamente un resultado positivo, y el resultado real es efectivamente positivo.
- Verdaderos Negativos (TN): El modelo predice con precisión un resultado negativo, y el resultado real también es negativo.
- Falsos Positivos (FP): El modelo predice incorrectamente un resultado positivo para una instancia realmente negativa, lo que lleva a un error de Tipo I.
- Falsos Negativos (FN): El modelo clasifica incorrectamente un caso positivo como negativo, perdiendo un verdadero positivo, lo que resulta en un error de Tipo II.
Comprender estos elementos es crucial porque indican dónde se equivoca el modelo. Por ejemplo, demasiados falsos positivos podrían significar que el modelo es demasiado ansioso por predecir resultados positivos, mientras que demasiados falsos negativos podrían indicar que está pasando por alto casos importantes. El impacto de estos errores depende del contexto.
Consideremos un modelo de diagnóstico médico, por ejemplo. Si produce demasiados falsos positivos, los pacientes pueden recibir tratamiento innecesario. Por el contrario, una abundancia de falsos negativos podría significar pasar por alto verdaderos casos de una enfermedad, poniendo en peligro la salud del paciente. Una matriz de confusión nos permite identificar estos problemas y realizar los ajustes necesarios, mejorando la precisión y el rendimiento del modelo.
Evaluación del Rendimiento del Modelo Usando una Matriz de Confusión
Una de las principales razones para emplear una matriz de confusión es que proporciona más que solo precisión. Aunque la precisión cuantifica el número total de predicciones correctas, no necesariamente revela el panorama completo. Un modelo puede parecer preciso y aún así carecer de aspectos importantes, especialmente cuando se trata de conjuntos de datos desequilibrados donde una clase supera con creces a la otra.
Varios métricas derivadas de la matriz de confusión proporcionan una visión más clara del rendimiento:
Precisión—Esta métrica se centra en cuántos de los casos positivos predichos fueron realmente correctos. Se calcula como TP / (TP + FP). Una alta precisión significa menos falsos positivos, lo cual es crucial en áreas como la detección de spam.
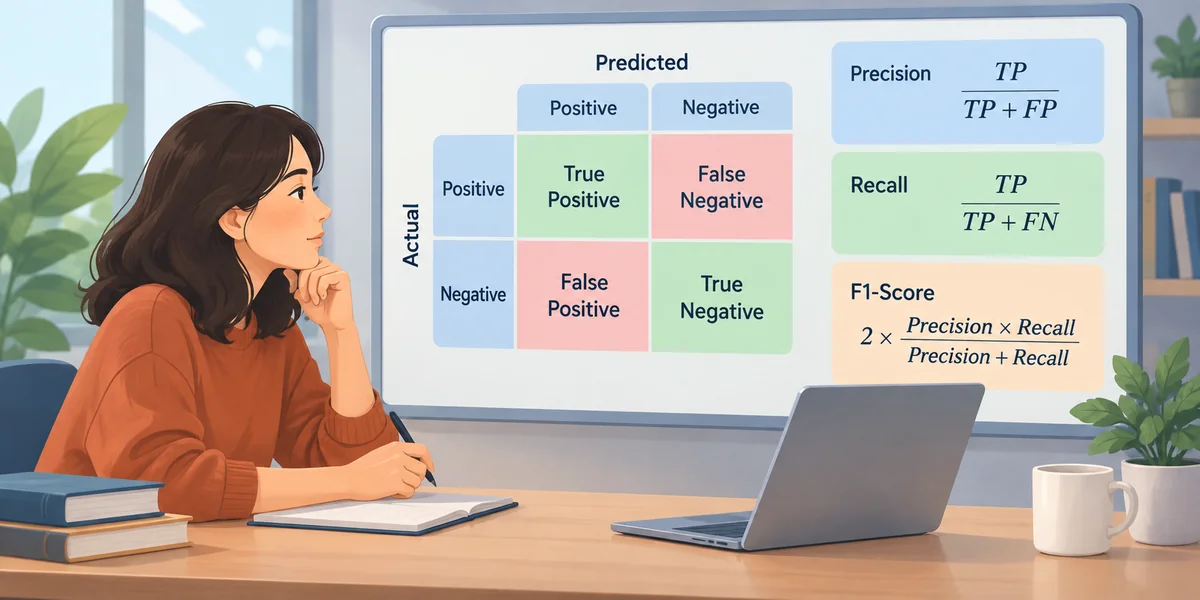
Recuperación (Sensibilidad) – Esto mide cuántos casos positivos reales el modelo identificó con éxito. Se calcula como TP / (TP + FN). Una alta recuperación asegura menos falsos negativos, lo cual es crucial en escenarios como exámenes médicos.
Puntuación F1 – Esto combina precisión y recuperación en un solo número. Se calcula como 2 × (Precisión × Recuperación) / (Precisión + Recuperación). La puntuación F1 es particularmente útil cuando se necesita equilibrar precisión y recuperación.
Al analizar estas métricas, podemos entender mejor las fortalezas y debilidades de un modelo. Por ejemplo, en la detección de fraudes, a menudo se prefiere una alta recuperación porque pasar por alto transacciones fraudulentas puede ser costoso. Sin embargo, en el filtrado de spam, una alta precisión es esencial para evitar clasificar erróneamente correos importantes como spam.
Más allá de las métricas individuales, visualizar una matriz de confusión puede ayudar a detectar tendencias. Un modelo que funcione bien tendrá altos valores a lo largo de la diagonal, donde residen los verdaderos positivos y los verdaderos negativos, y valores más bajos en las áreas fuera de la diagonal, donde ocurren los errores. Ajustes como modificar los umbrales de decisión o utilizar mejores datos de entrenamiento pueden ayudar a cambiar estos números en una dirección favorable.
Aplicaciones Prácticas de una Matriz de Confusión
La matriz de confusión se utiliza ampliamente en diversos dominios, particularmente en modelos de aprendizaje automático diseñados para tareas de clasificación. Algunas de las aplicaciones más comunes incluyen:
Diagnósticos Médicos:
La matriz de confusión ayuda a evaluar la precisión de los modelos que predicen si un paciente tiene una determinada condición. Identifica diagnósticos correctos y resalta clasificaciones erróneas críticas, mejorando la precisión del modelo para evitar errores críticos en entornos de atención médica.
Detección de Spam:
Los filtros de correo electrónico se basan en la matriz de confusión para identificar si los mensajes son spam o no. Al analizar falsos positivos (correos importantes marcados como spam) y falsos negativos (correos spam que escapan al filtro), la matriz ayuda a refinar el filtro para evitar errores y mejorar la precisión.
Detección de Fraude:
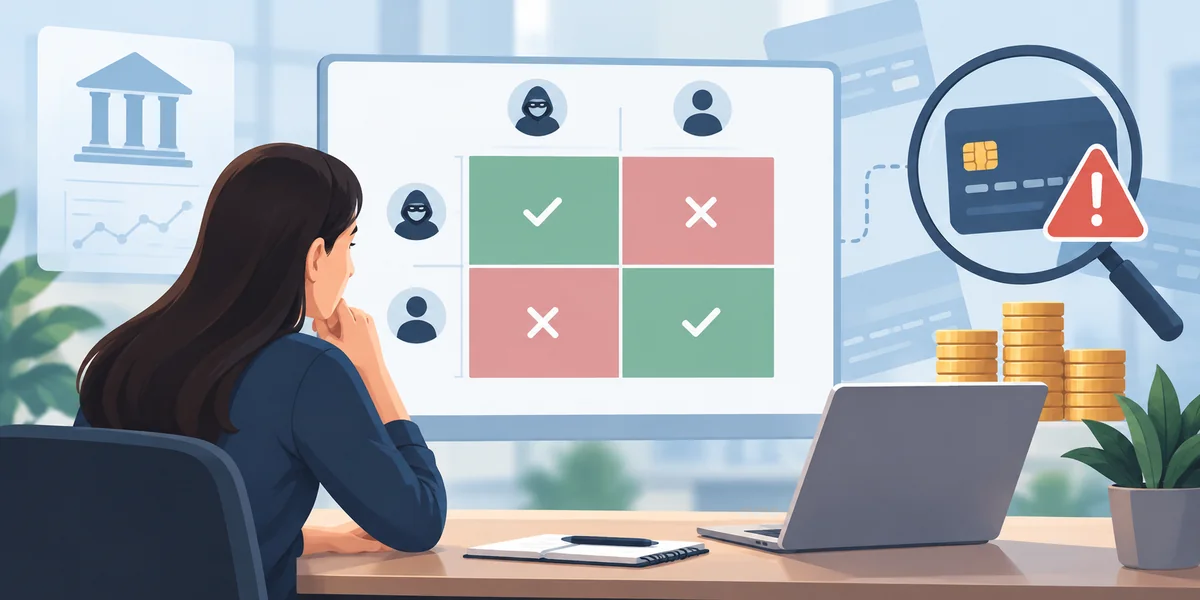
En los sistemas de detección de fraudes, los bancos e instituciones financieras utilizan la matriz de confusión para analizar si las transacciones sospechosas se identifican correctamente. Al examinar falsos positivos y negativos, los modelos pueden ajustarse para detectar fraudes con precisión mientras se minimizan alertas innecesarias y interrupciones.
Análisis de Sentimientos:
Las empresas utilizan modelos de aprendizaje automático para clasificar reseñas de clientes en categorías positivas, negativas o neutrales. La matriz de confusión ayuda a evaluar con qué frecuencia el modelo clasifica erróneamente las reseñas, proporcionando información sobre dónde se necesitan mejoras para una mejor comprensión del sentimiento del cliente y estrategias de marketing.
La importancia de esta herramienta se extiende más allá de verificar el rendimiento de un modelo. Proporciona una forma de refinar los algoritmos de aprendizaje automático para minimizar errores costosos. Al ajustar los parámetros del modelo, afinar los datos o incluso elegir diferentes algoritmos, los resultados pueden mejorarse significativamente.
Conclusión
La matriz de confusión es una herramienta esencial para evaluar modelos de aprendizaje automático, proporcionando una vista detallada y completa de la precisión de las predicciones. Desglosar las predicciones en verdaderos positivos, verdaderos negativos, falsos positivos y falsos negativos ayuda a identificar dónde un modelo sobresale y dónde necesita mejoras. Más allá de la simple precisión, la matriz de confusión permite una comprensión más profunda de las fortalezas y debilidades de un modelo, guiando los ajustes para mejorar el rendimiento. Ya sea en el sector de la salud, las finanzas u otras industrias, el uso de esta herramienta asegura una mejor toma de decisiones y resultados más confiables, impulsando en última instancia el desarrollo de sistemas de IA más precisos y efectivos.
Artículos relacionados
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
