
Validación Cruzada en Aprendizaje Automático: Cómo Mejora la Precisión del Modelo
En esta página
Construir un modelo de aprendizaje automático confiable no se trata solo de alimentarlo con datos, sino de asegurarse de que realmente aprenda. Un modelo puede funcionar bien durante el entrenamiento pero fallar estrepitosamente cuando se enfrenta a nueva información. Este fallo a menudo ocurre cuando el modelo memoriza patrones en lugar de entenderlos. La validación cruzada es una técnica poderosa para prevenir este problema.
La validación cruzada implica varias divisiones de datos para verificar que el modelo pueda manejar aplicaciones del mundo real. Sin ella, las predicciones pueden ser engañosas, y el sobreajuste se convierte en un problema significativo. No es simplemente un paso en el entrenamiento del modelo, sino una salvaguarda contra modelos que parecen perfectos en teoría pero no pueden rendir en la práctica.
El Propósito de la Validación Cruzada
Al crear un modelo de aprendizaje automático, es crucial que funcione bien en datos fuera del conjunto de entrenamiento. Si no se prueba, el modelo puede sobresalir durante el entrenamiento pero flaquear cuando se expone a nuevos datos. Esto ocurre porque el modelo podría memorizar los patrones de entrenamiento en lugar de aprenderlos realmente.
La validación cruzada actúa como un punto de control. Divide sistemáticamente los datos en múltiples conjuntos de entrenamiento y prueba para evaluar qué tan bien generaliza el modelo. Al repetir este proceso en varias divisiones, obtenemos una estimación de rendimiento más precisa. El tipo más común, la validación cruzada k-fold, divide el conjunto de datos en k partes del mismo tamaño y utiliza cada parte como un conjunto de prueba mientras entrena en las otras k-1 partes. Esto se repite k veces, y el resultado se promedia para obtener una medida de rendimiento final.
Una gran ventaja de la validación cruzada es su utilidad en la optimización de hiperparámetros. Muchos modelos de aprendizaje automático tienen parámetros, conocidos como hiperparámetros, que influyen en su comportamiento. En lugar de adivinar las configuraciones óptimas, la validación cruzada nos permite probar varias configuraciones y elegir la que funciona bien en diferentes divisiones de datos.
Diferentes Tipos de Validación Cruzada
La validación cruzada viene en varias formas, cada una adecuada para distintos tipos de conjuntos de datos y problemas. Aunque la validación cruzada k-fold es la más utilizada, otros métodos ofrecen beneficios especializados en diferentes circunstancias.
Validación Cruzada K-Fold
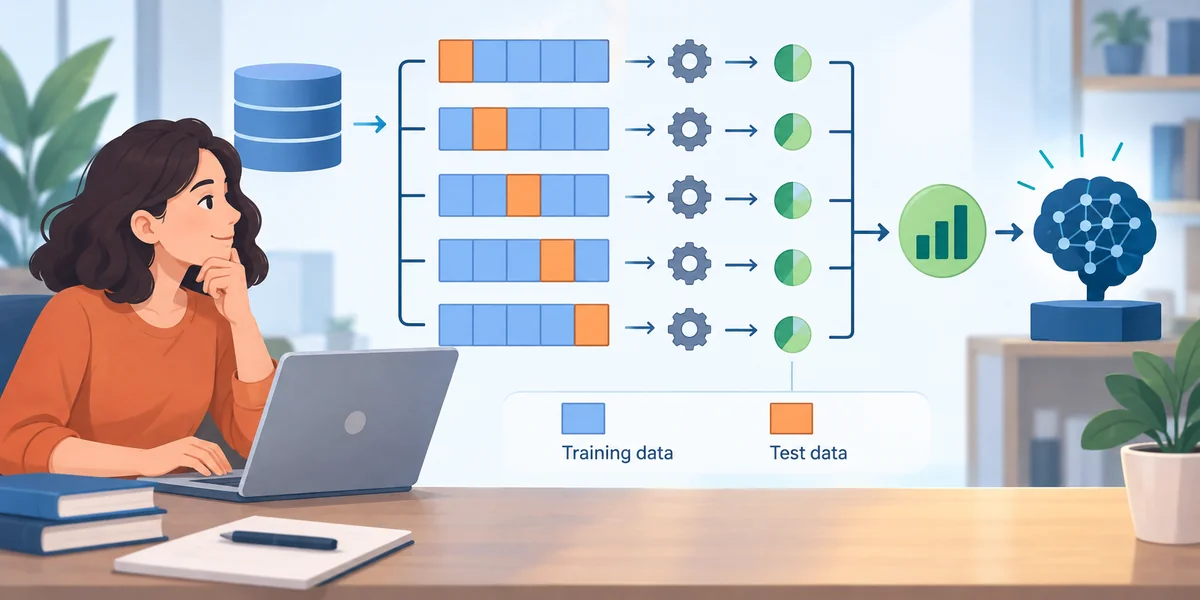
Esta es la técnica más popular, donde el conjunto de datos se divide en k subconjuntos o “pliegues”. El modelo se entrena en k-1 pliegues mientras que el pliegue restante se utiliza para pruebas. Este proceso se repite k veces, asegurando que cada pliegue se use como conjunto de prueba una vez. La precisión final se calcula como el promedio de las k ejecuciones. Una elección común para k es 5 o 10, pero se puede ajustar según el tamaño del conjunto de datos.
Validación Cruzada K-Fold Estratificada
La validación cruzada k-fold estratificada mejora la k-fold al asegurar que cada pliegue mantenga la misma distribución de clases que el conjunto de datos original. Esto es crucial para datos desbalanceados, donde una división k-fold estándar podría crear pliegues con muy pocas muestras de la clase minoritaria, conduciendo a resultados poco fiables. Al preservar las proporciones de clase, la k-fold estratificada proporciona una evaluación del modelo más precisa.
Validación Cruzada Leave-One-Out (LOOCV)
Como sugiere el nombre, este método entrena el modelo en todo el conjunto de datos excepto por una instancia, que se utiliza para pruebas. Este proceso se repite para cada punto de datos en el conjunto de datos. Aunque la LOOCV proporciona una evaluación extremadamente exhaustiva, puede ser computacionalmente costosa para conjuntos de datos grandes, ya que requiere entrenar el modelo múltiples veces.
Validación Cruzada Leave-P-Out
Esta es una extensión de la LOOCV donde, en lugar de dejar fuera solo un punto de datos, se excluyen p puntos de datos en cada iteración. Esto proporciona más flexibilidad pero es aún más exigente computacionalmente, ya que el número de combinaciones posibles de entrenamiento-prueba crece significativamente con conjuntos de datos más grandes.
Validación Cruzada para Series Temporales
La validación cruzada estándar no es adecuada para datos dependientes del tiempo, como las tendencias del mercado de valores o las previsiones meteorológicas. La validación cruzada para series temporales entrena con datos pasados y prueba con datos futuros, preservando el orden natural. Esto evita evaluaciones poco realistas donde un modelo aprende de datos futuros que no habrían estado disponibles durante las predicciones en tiempo real, asegurando una evaluación más precisa.
Beneficios y Desafíos de la Validación Cruzada
La validación cruzada proporciona una estimación más confiable del rendimiento de un modelo en datos no vistos. A diferencia de una sola división de entrenamiento-prueba, asegura que cada punto de datos se use tanto para entrenamiento como para pruebas, reduciendo el sesgo y mejorando la confiabilidad del modelo. Evaluar el rendimiento en múltiples divisiones ayuda a prevenir el sobreajuste, asegurando que los modelos generalicen bien a datos del mundo real. Además, la validación cruzada es útil para seleccionar el mejor modelo entre múltiples candidatos, ya que identifica la opción más consistente y precisa.
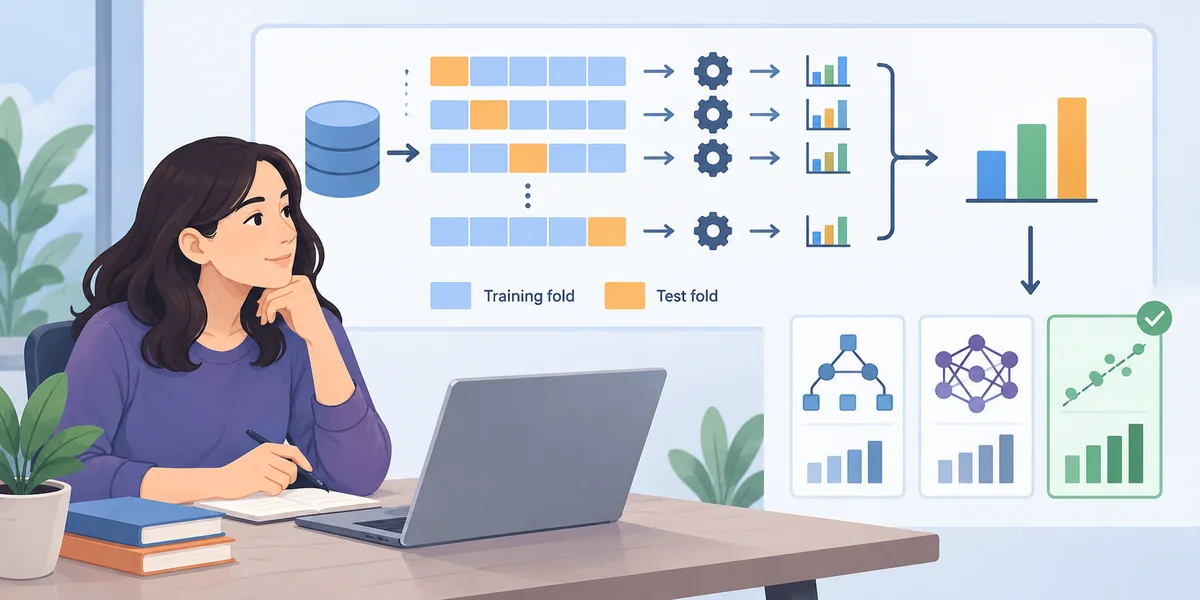
Sin embargo, la validación cruzada tiene sus desafíos. El más significativo es el costo computacional, ya que ejecutar múltiples ciclos de entrenamiento y prueba puede ser intensivo en recursos, especialmente para conjuntos de datos grandes y modelos de aprendizaje profundo. Esto lo hace poco práctico en algunos casos donde la potencia computacional es limitada. Otro problema es la fuga de datos, que ocurre si la información del conjunto de prueba influye en el entrenamiento, llevando a estimaciones de rendimiento demasiado optimistas. Esto a menudo sucede cuando el preprocesamiento de datos, como la normalización o la selección de características, se realiza antes de dividir los datos. Para asegurar resultados precisos, la validación cruzada debe implementarse cuidadosamente, manteniendo una estricta separación entre las etapas de entrenamiento y prueba.
Cuándo Usar la Validación Cruzada
La validación cruzada no siempre es necesaria, pero es crucial en casos donde se dispone de datos limitados. Si un conjunto de datos es pequeño, una sola división de entrenamiento-prueba podría no proporcionar suficiente información para evaluar el modelo con precisión. En tales casos, la validación cruzada maximiza el uso de los datos disponibles al asegurar múltiples evaluaciones.
También es esencial al probar múltiples modelos o ajustar hiperparámetros. Dado que diferentes configuraciones pueden desempeñarse de manera diferente dependiendo de cómo se dividan los datos, la validación cruzada ayuda a identificar el enfoque más estable.
Sin embargo, para conjuntos de datos extremadamente grandes, una simple división de entrenamiento-prueba puede ser suficiente. Cuando hay millones de puntos de datos disponibles, dividir una porción para validación proporciona una estimación razonable del rendimiento del modelo sin la carga computacional adicional de la validación cruzada.
Conclusión
La validación cruzada es una técnica crucial en el aprendizaje automático que garantiza que los modelos generalicen bien a datos no vistos. La división sistemática de datos en conjuntos de entrenamiento y prueba previene el sobreajuste y proporciona una estimación de rendimiento confiable. Diferentes métodos, como la validación cruzada k-fold y la estratificada, se adaptan a diversas necesidades. Aunque es intensiva computacionalmente, sus beneficios superan los desafíos, especialmente para conjuntos de datos pequeños. Una implementación adecuada conduce a predicciones más confiables, haciendo de la validación cruzada un paso esencial para construir modelos de aprendizaje automático robustos y efectivos.
Artículos relacionados
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Pérdida Hinge en Aprendizaje Automático: Perspectivas Clave y Aplicaciones

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
6 Robots Enfermeros con IA que Están Transformando el Cuidado de la Salud
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
Medir la Adopción e Impacto de la IA

IA en el Cuidado de la Salud: Avances Actuales y Oportunidades Futuras
Visualizando Patrones: 2 Métodos para Crear un Mapa de Calor en Power BI
Modelos de IA Descubiertos: La Tecnología Detrás de los Sistemas Inteligentes
Análisis Conductual en Centros de Contacto: La Ventaja de la IA
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
