
Una Guía Completa sobre Aprendizaje Supervisado vs. No Supervisado: Ventajas, Desventajas y Aplicaciones
En esta página
El aprendizaje automático es la fuerza impulsora detrás de tecnologías como los asistentes de voz y los sistemas de detección de fraudes. Pero, ¿cómo aprenden estos sistemas? En el corazón del desarrollo de la IA se encuentran dos técnicas principales: el aprendizaje supervisado y el no supervisado. El primero utiliza un enfoque estructurado, aprendiendo de ejemplos etiquetados, mientras que el segundo explora datos sin procesar para descubrir patrones ocultos.
Elegir entre estos métodos es más que una decisión técnica: afecta la precisión, eficiencia y resultados empresariales. Ya sea que estés entrenando una IA para detectar enfermedades o personalizar recomendaciones, comprender estos métodos es crucial. Este artículo explora sus fortalezas y debilidades y te guía sobre cuándo usar cada uno para maximizar los resultados de aprendizaje automático.
¿Qué es el Aprendizaje Supervisado?
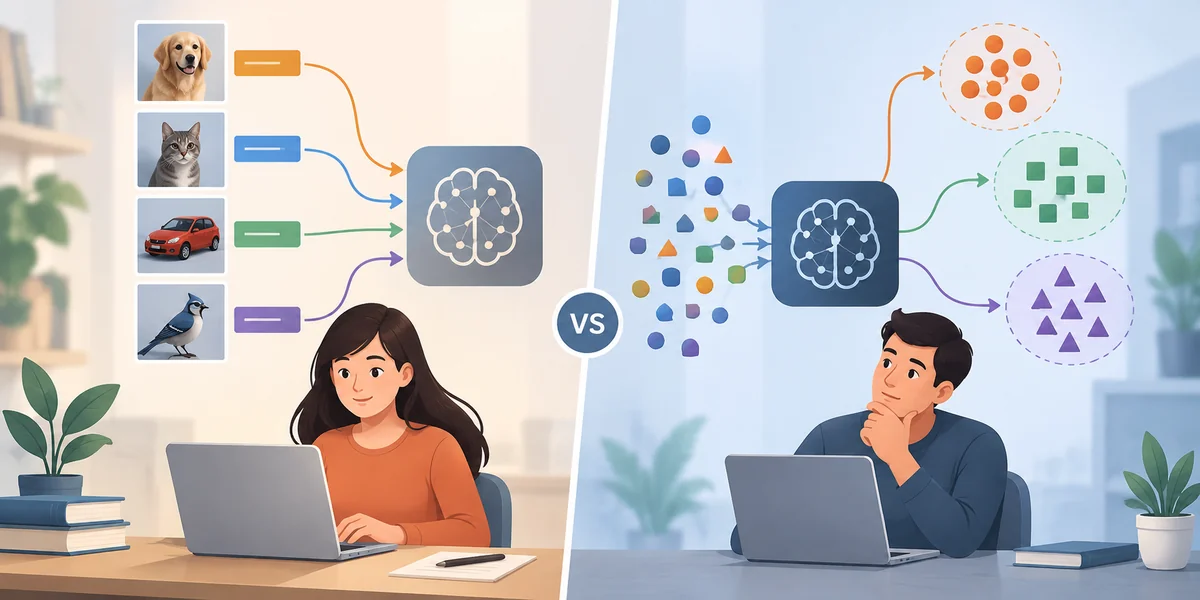
El aprendizaje supervisado entrena modelos de IA utilizando conjuntos de datos etiquetados. Cada entrada tiene una salida correcta correspondiente, lo que ayuda al modelo a aprender relaciones y patrones. Con el tiempo, el sistema mejora comparando sus predicciones con resultados reales y realizando ajustes.
Este método es prevalente en aplicaciones que requieren clasificación o regresión. En tareas de clasificación, los datos se dividen en categorías, como separar correos electrónicos de spam de los no spam. Para tareas de regresión, el aprendizaje supervisado predice valores numéricos, como precios de acciones o temperaturas meteorológicas. Algoritmos como árboles de decisión, máquinas de vectores de soporte y redes neuronales son comúnmente utilizados en el aprendizaje supervisado.
El aprendizaje supervisado es especialmente efectivo en escenarios que demandan precisión y fiabilidad. Sin embargo, requiere grandes cantidades de datos etiquetados, lo cual puede ser costoso y llevar tiempo recolectar.
Ventajas del Aprendizaje Supervisado
Una de las mayores fortalezas del aprendizaje supervisado es su precisión. Los modelos entrenados con respuestas predefinidas ofrecen resultados precisos, cruciales para aplicaciones como la detección de fraudes, el reconocimiento de voz y el diagnóstico de enfermedades, donde los errores pueden ser catastróficos.
Otra ventaja es la interpretabilidad. El entrenamiento con datos estructurados hace que el proceso de toma de decisiones sea transparente, esencial en campos como las finanzas y la medicina. Los modelos de aprendizaje supervisado también pueden actualizarse con nuevos datos, mejorando la precisión y adaptándose a las tendencias en evolución.
Desventajas del Aprendizaje Supervisado
A pesar de su precisión, el aprendizaje supervisado tiene desventajas. Recolectar conjuntos de datos grandes y etiquetados es un desafío significativo, especialmente en campos como la medicina y el análisis legal.
El sobreajuste es otro problema, donde un modelo memoriza demasiado bien los datos de entrenamiento pero tiene dificultades con datos nuevos, reduciendo su aplicabilidad en el mundo real. Técnicas como la validación cruzada ayudan pero requieren ajustes cuidadosos.
Además, el aprendizaje supervisado carece de flexibilidad para descubrir patrones desconocidos, ya que depende de datos etiquetados por humanos en lugar de explorar estructuras ocultas de manera independiente.
¿Qué es el Aprendizaje No Supervisado?
El aprendizaje no supervisado adopta un enfoque diferente, trabajando sin datos etiquetados. En lugar de ser dirigido sobre qué buscar, el modelo identifica autónomamente patrones y relaciones, siendo ideal para explorar conjuntos de datos complejos sin categorías predefinidas.
Las principales aplicaciones del aprendizaje no supervisado incluyen la agrupación en clústeres y la detección de anomalías. La agrupación reúne puntos de datos similares, como segmentar clientes según hábitos de compra, mientras que la detección de anomalías identifica patrones inusuales, útil para detectar transacciones fraudulentas o amenazas de ciberseguridad.
Algoritmos comunes de aprendizaje no supervisado incluyen la agrupación K-means, la agrupación jerárquica y el análisis de componentes principales (PCA). A diferencia del aprendizaje supervisado, el aprendizaje no supervisado puede manejar datos sin procesar y desorganizados, haciéndolo adecuado para análisis de datos a gran escala.
Ventajas del Aprendizaje No Supervisado
La mayor ventaja del aprendizaje no supervisado es su capacidad para descubrir patrones ocultos en los datos. Sin la necesidad de datos etiquetados, identifica tendencias que pueden no ser inmediatamente evidentes, valiosas en genética, análisis de comportamiento del cliente e investigación financiera.
La escalabilidad es otro beneficio. El aprendizaje no supervisado maneja eficientemente conjuntos de datos masivos sin etiquetado manual, haciéndolo rentable para aplicaciones a gran escala como sistemas de recomendación en comercio electrónico y plataformas de streaming. También se adapta a nuevos datos sin necesidad de reentrenamiento, beneficioso para la ciberseguridad y la evaluación de riesgos.
Desventajas del Aprendizaje No Supervisado
A pesar de su flexibilidad, el aprendizaje no supervisado tiene limitaciones. Un problema importante es la imprevisibilidad: sin datos etiquetados, las salidas pueden ser ambiguas o engañosas, complicando la evaluación de precisión.
La clasificación incorrecta es otro riesgo. Sin categorías predefinidas, el modelo podría agrupar incorrectamente los datos, llevando a ideas poco fiables que afectan negativamente las estrategias de marketing o la segmentación de clientes.
Ajustar modelos no supervisados es un desafío. Sin un punto de referencia claro de rendimiento, evaluar los resultados requiere un extenso ensayo y error, haciendo el proceso largo y complejo.
Diferencias Clave: Aprendizaje Supervisado vs. No Supervisado
La distinción fundamental entre estos dos métodos es el etiquetado de datos. El aprendizaje supervisado requiere conjuntos de datos estructurados y etiquetados, ideal para tareas predictivas. En contraste, el aprendizaje no supervisado identifica patrones en datos sin procesar sin etiquetas predefinidas.
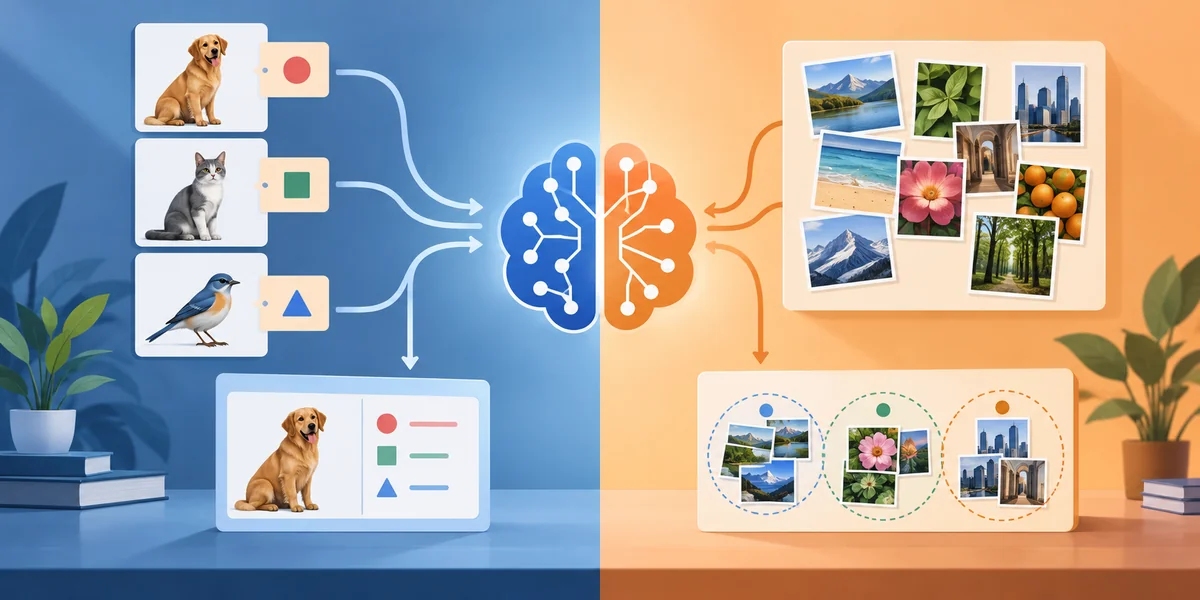
La precisión y la interpretabilidad también difieren. El aprendizaje supervisado ofrece resultados precisos y explicables, preferidos para aplicaciones que necesitan transparencia. El aprendizaje no supervisado sobresale en encontrar patrones desconocidos pero a menudo requiere interpretación adicional.
La escalabilidad es otra diferencia importante. Mientras que el aprendizaje supervisado necesita datos etiquetados extensos, el aprendizaje no supervisado analiza conjuntos de datos masivos con mínima intervención humana, haciéndolo práctico para aplicaciones de big data.
Cuándo Elegir
La elección entre aprendizaje supervisado y no supervisado depende del problema específico. Si la precisión y el poder predictivo son prioridades, el aprendizaje supervisado es ideal, especialmente para detección de fraudes, diagnósticos médicos y traducciones automáticas. Sin embargo, requiere datos etiquetados de alta calidad, que pueden no estar siempre disponibles.
El aprendizaje no supervisado es mejor para análisis exploratorios, descubriendo patrones ocultos. Es ampliamente utilizado en investigación de mercado, segmentación de clientes y ciberseguridad. Aunque no ofrece el mismo nivel de precisión que el aprendizaje supervisado, proporciona valiosas ideas a partir de datos sin procesar.
Conclusión
Tanto el aprendizaje supervisado como el no supervisado son esenciales en el desarrollo de IA, atendiendo diferentes casos de uso. El aprendizaje supervisado es mejor para aplicaciones que necesitan precisión y toma de decisiones estructurada, mientras que el aprendizaje no supervisado es ideal para descubrir patrones en conjuntos de datos complejos. La elección correcta depende de las necesidades del proyecto, la disponibilidad de datos etiquetados y la interpretabilidad deseada. Al comprender estas diferencias, las empresas e investigadores pueden tomar decisiones informadas sobre cómo aprovechar eficazmente los modelos de aprendizaje automático.
Artículos relacionados
Redes Neuronales vs. Aprendizaje Profundo: Cómo Moldean la IA
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
CNNs vs. Transformadores: ¿Qué Modelo de IA Funciona Mejor para tu Tarea?
El Impacto de la IA en la Evaluación de Crédito: Préstamos Más Justos y Rápidos
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
Cómo las Comunidades de IA de Código Abierto Están Cambiando el Futuro de la Tecnología
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
TensorFlow: El Marco de IA que Impulsa Innovaciones en el Aprendizaje Automático
Máquinas de Vectores de Soporte (SVM): Cómo Impulsan los Modelos de Aprendizaje Automático
Diferencias Clave entre Sesgo y Varianza en el Aprendizaje Automático
La Verdad sobre Analítica Predictiva vs. Aprendizaje Automático: Cómo se Diferencian
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
