
CNNs vs. Transformadores: ¿Qué Modelo de IA Funciona Mejor para tu Tarea?
En esta página
El aprendizaje profundo ha revolucionado la forma en que las máquinas procesan la información, pero no todos los modelos funcionan de la misma manera. Dos gigantes en el campo, los Transformadores y las Redes Neuronales Convolucionales (CNNs), abordan los problemas de manera diferente y son fundamentales para dar forma al futuro de la inteligencia artificial (IA). Las CNNs, inspiradas en la visión humana, sobresalen en el reconocimiento de imágenes, mientras que los Transformadores, diseñados para el procesamiento del lenguaje, están redefiniendo la capacidad de la IA para entender el contexto.
Su influencia se está expandiendo más allá de sus dominios originales, provocando debates sobre cuál modelo es superior. La respuesta no es sencilla. Comprender sus diferencias no es solo para investigadores; es clave para desbloquear todo el potencial de la IA. Desglosaremos lo que los distingue y dónde destacan.
Comprendiendo la Arquitectura Básica
Las CNNs han estado a la vanguardia de la visión por computadora durante años, inspirándose en cómo el cerebro humano procesa la información visual. Las capas convolucionales se utilizan para extraer características de las imágenes, identificando bordes, formas y texturas de manera jerárquica. Las capas de pooling reducen la dimensionalidad mientras preservan las características esenciales, mejorando la eficiencia computacional. Las capas totalmente conectadas finales reconocen objetos basados en patrones extraídos. Este diseño hace que las CNNs sean poderosas en tareas espacialmente conscientes como la imagen médica y el reconocimiento facial.
Por otro lado, los Transformadores fueron inicialmente diseñados para datos secuenciales, pero han demostrado ser extremadamente adaptables. Su innovación central es el mecanismo de auto-atención, que les permite asignar pesos a la importancia de varios elementos dentro de una secuencia. A diferencia de las CNNs que funcionan basadas en jerarquías espaciales, los Transformadores pueden procesar todos los datos de entrada simultáneamente, capturando dependencias de largo alcance de manera eficiente. Esta capacidad es particularmente útil en el procesamiento del lenguaje, donde el contexto es crucial. A diferencia de las redes recurrentes más antiguas, los Transformadores pueden procesar secuencias completas en paralelo, acelerando significativamente los tiempos de entrenamiento. Su escalabilidad les ha permitido superar a modelos más antiguos en tareas que van desde la traducción automática hasta la generación de texto. Aunque inicialmente desarrollados para el procesamiento del lenguaje natural, los Transformadores se han aplicado desde entonces a dominios como las predicciones de plegamiento de proteínas y el reconocimiento de imágenes a través de Transformadores de Visión (ViTs).
Fortalezas y Limitaciones
Las CNNs son excelentes en reconocer patrones visuales, lo que las hace indispensables para la clasificación de imágenes, la detección de objetos y el reconocimiento facial. Su capacidad para descomponer imágenes en patrones más pequeños y procesarlos jerárquicamente permite una clasificación precisa y eficiente. Las CNNs también son computacionalmente eficientes con datos estructurados, lo que las hace ideales para aplicaciones en tiempo real como autos autónomos y sistemas de vigilancia. Sin embargo, las CNNs tienen dificultades para entender relaciones secuenciales en los datos. Su dependencia de filtros de tamaño fijo dificulta la captura de dependencias a larga distancia, limitando su efectividad en tareas como el modelado del lenguaje.
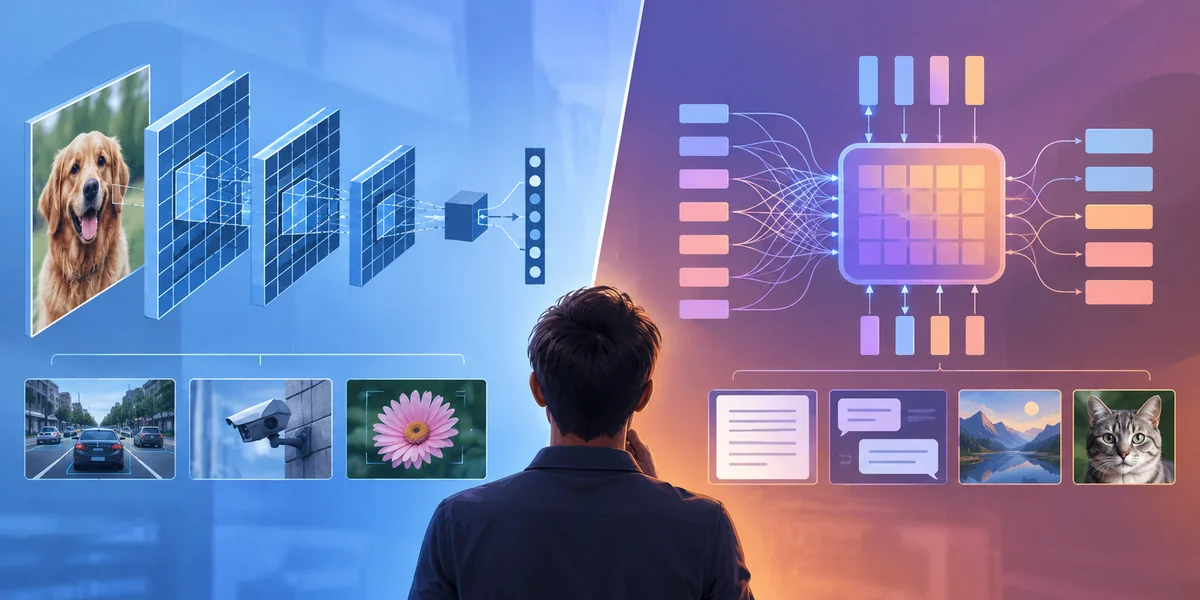
Los Transformadores sobresalen en tareas que requieren conciencia del contexto. Su mecanismo de auto-atención les permite entender las relaciones entre palabras en una oración, revolucionando el procesamiento del lenguaje natural. También han comenzado a desafiar a las CNNs en el reconocimiento de imágenes, con los Transformadores de Visión superando a modelos tradicionales en algunos casos. Sin embargo, su mayor desventaja es su costo computacional. Entrenar modelos de Transformadores a gran escala requiere vastas cantidades de datos y poder de procesamiento, lo que los hace intensivos en recursos. Además, su proceso de toma de decisiones a menudo es difícil de interpretar, planteando desafíos en aplicaciones donde la transparencia es crucial. A pesar de estas limitaciones, los Transformadores han ampliado las capacidades de la IA, abriendo nuevas posibilidades más allá del procesamiento de texto.
Aplicaciones del Mundo Real
Las CNNs continúan dominando el campo de la visión por computadora, con aplicaciones en salud, seguridad y sistemas autónomos. Se utilizan ampliamente en la imagen médica para detectar anomalías en radiografías y resonancias magnéticas. Los autos autónomos dependen de las CNNs para la detección de objetos y la comprensión de escenas, asegurando una navegación segura. Los sistemas de reconocimiento facial, las herramientas de detección de fraudes y la transferencia de estilo artístico también dependen en gran medida de arquitecturas basadas en CNNs. A pesar de la creciente competencia de los Transformadores, las CNNs siguen siendo la opción preferida para tareas de procesamiento visual que requieren eficiencia y alta precisión.
Los Transformadores han transformado el procesamiento del lenguaje natural. Impulsan chatbots avanzados, herramientas de traducción de idiomas en tiempo real y contenido generado por IA. Modelos como GPT han revolucionado la creación de contenido, permitiendo a la IA escribir texto similar al humano con una coherencia notable. Más allá del lenguaje, los Transformadores impactan áreas como el descubrimiento de fármacos y la previsión financiera. Su capacidad para analizar patrones en grandes conjuntos de datos los hace útiles para predecir tendencias del mercado y optimizar la logística. Los Transformadores de Visión también están desafiando el dominio de las CNNs en el reconocimiento de imágenes, con algunos modelos logrando un rendimiento de vanguardia en tareas de clasificación. A medida que la investigación continúa, se espera que el papel de los Transformadores en la IA se expanda aún más, convirtiéndolos en un componente crítico de futuros avances tecnológicos.
Tendencias Evolutivas en la IA: El Futuro de los Transformadores y las CNNs
El aprendizaje profundo avanza rápidamente, con las CNNs y los Transformadores evolucionando para enfrentar nuevos desafíos. Los investigadores están desarrollando modelos híbridos que combinan la extracción de características de las CNNs con los mecanismos de atención de los Transformadores, mejorando el reconocimiento de imágenes y la eficiencia. Los Transformadores de Visión (ViTs) ya están compitiendo con las CNNs en la visión por computadora, indicando un posible cambio en el dominio de los modelos de IA. Mientras tanto, las mejoras en el hardware, como los aceleradores de IA, están ayudando a mitigar las altas demandas computacionales de los Transformadores, haciéndolos más accesibles.
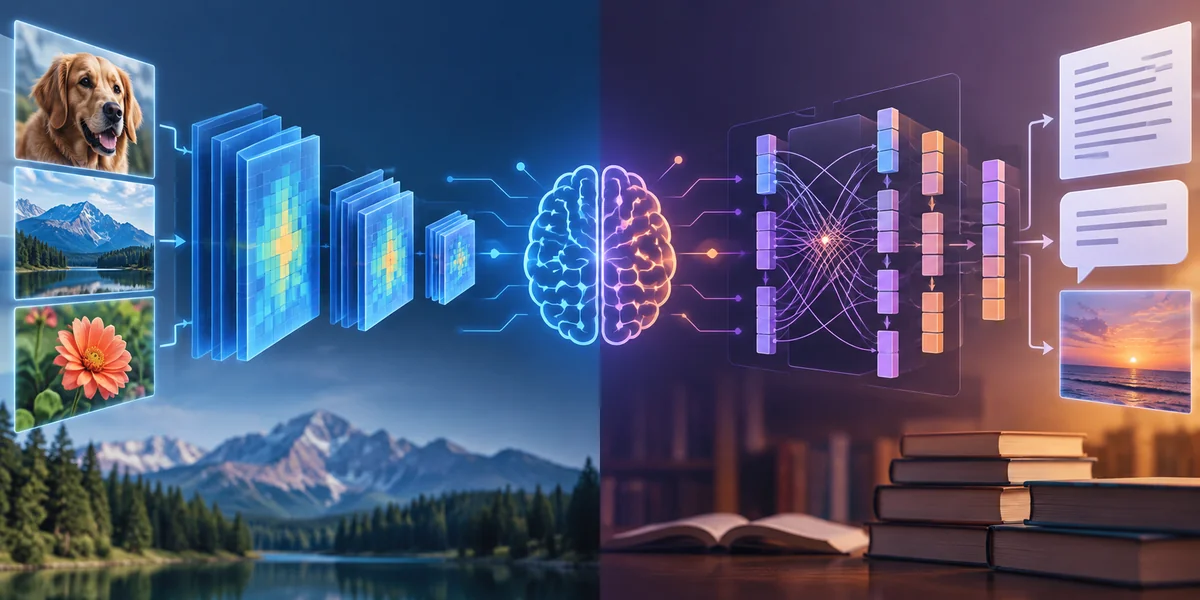
Las CNNs siguen siendo indispensables para tareas que requieren velocidad y conciencia espacial, mientras que los Transformadores continúan redefiniendo el PLN y el procesamiento de datos secuenciales. A medida que las aplicaciones de IA se expanden, probablemente ambas arquitecturas coexistirán, optimizando cada una el rendimiento en su dominio especializado. El futuro verá una mayor integración de estos modelos, con sistemas de IA aprovechando sus fortalezas para lograr una precisión y eficiencia sin precedentes. La evolución continua del aprendizaje profundo asegura un paisaje de IA dinámico y competitivo.
Conclusión
Tanto los Transformadores como las Redes Neuronales Convolucionales son revolucionarios en su propio derecho, cada uno sobresaliendo en diferentes dominios. Las CNNs siguen siendo el estándar de oro para tareas relacionadas con imágenes, aprovechando su estructura jerárquica para extraer características de manera eficiente. Mientras tanto, los Transformadores han cambiado el panorama del PLN y ahora se están expandiendo a nuevas áreas, ofreciendo una escalabilidad y flexibilidad inigualables. La elección entre ambos depende del problema en cuestión: CNNs para datos de imágenes estructuradas y Transformadores para dependencias complejas en texto y más allá. A medida que la IA avanza, la interacción entre estos modelos probablemente dará forma al futuro del aprendizaje profundo.
Artículos relacionados
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Nuevas técnicas de aprendizaje profundo toman protagonismo
Por qué el Deep Learning Puede No Ser la Solución Adecuada para Su Negocio
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
El Impacto de la IA en la Evaluación de Crédito: Préstamos Más Justos y Rápidos
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
Cómo las Comunidades de IA de Código Abierto Están Cambiando el Futuro de la Tecnología
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Construyendo Mejores Modelos: La Batalla Entre el Sobreajuste y el Subajuste
Por qué los Modelos de Lenguaje Pequeños Están en Auge
Una Guía sobre Redes Neuronales Recurrentes (RNNs) para Datos Secuenciales
Cómo Crear Datos Sintéticos para Entrenar Algoritmos de Aprendizaje Profundo
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
