
Cómo Crear Datos Sintéticos para Entrenar Algoritmos de Aprendizaje Profundo
En esta página
Los modelos de aprendizaje profundo requieren una gran cantidad de datos para su entrenamiento. Sin embargo, obtener datos reales puede ser difícil o estar restringido debido a preocupaciones de privacidad o altos costos. Aquí es donde los datos sintéticos se convierten en una solución inteligente y práctica. Generados a través de herramientas, simulaciones o algoritmos, los datos sintéticos imitan los datos reales, permitiendo entrenar, probar y mejorar eficientemente los modelos de aprendizaje automático.
Los datos sintéticos ahorran tiempo, dinero y esfuerzo, siendo un excelente recurso tanto para profesionales en inteligencia artificial como para estudiantes y principiantes. Permiten explorar conceptos que podrían no estar respaldados por evidencia del mundo real. En esta guía, te guiaremos paso a paso en el proceso de crear datos sintéticos, proporcionándote técnicas poderosas para iniciar tu viaje en el aprendizaje profundo hoy mismo.
¿Qué Son los Datos Sintéticos?
Los datos sintéticos se generan a través de simulaciones y algoritmos informáticos, no por personas reales, sensores o dispositivos. El objetivo es replicar de manera segura los patrones y comportamientos de datos del mundo real. Estos datos pueden tomar la forma de texto, imágenes, videos o valores numéricos para análisis. Los datos sintéticos son particularmente útiles cuando los datos genuinos son difíciles de recopilar o cuando los problemas de privacidad impiden el uso de datos reales.
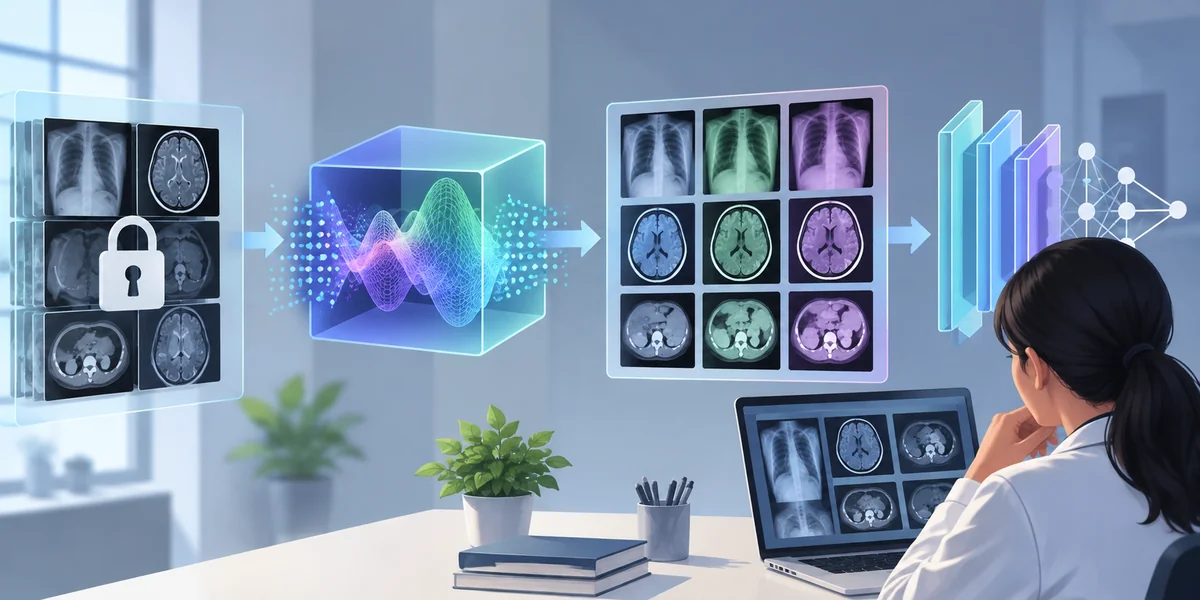
Por ejemplo, en la industria de la salud, la información de los pacientes es confidencial y sensible. Los datos sintéticos ofrecen una manera segura de entrenar modelos sin compartir datos reales. También son fáciles de etiquetar, ya que se crean con etiquetas existentes, lo que los hace ideales para el aprendizaje automático, especialmente para tareas de aprendizaje supervisado. Esto ahorra tiempo y dinero al eliminar la necesidad de etiquetado humano.
¿Por Qué Usar Datos Sintéticos para el Aprendizaje Profundo?
Los modelos de aprendizaje profundo necesitan una gran cantidad de datos para funcionar efectivamente, pero obtener datos reales puede ser costoso y desafiante. Muchos campos enfrentan una escasez de datos reales, y las preocupaciones de privacidad añaden otra capa de complejidad, dado que los datos genuinos pueden contener información sensible. El proceso de recopilación y etiquetado de datos reales es a menudo costoso y requiere mucho tiempo.
Los datos sintéticos abordan estos problemas permitiendo generar tantos datos como sea necesario, con control sobre su equilibrio y calidad. Esto ayuda a reducir el sesgo del modelo. Si tu modelo requiere eventos raros, los datos sintéticos permiten la fácil replicación de tales escenarios. También permiten probar modelos bajo diversas condiciones. Al cerrar brechas de datos, los datos sintéticos mejoran la precisión y fortalecen tu modelo de aprendizaje profundo.
Pasos para Crear Datos Sintéticos
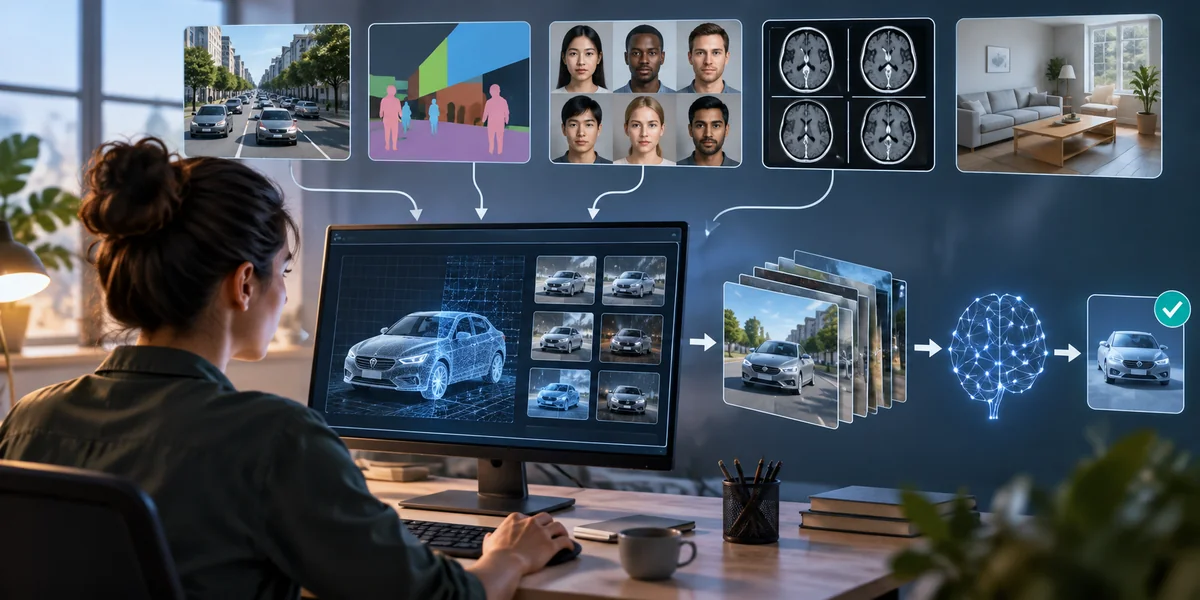
Vamos a profundizar en los pasos necesarios para crear datos sintéticos. Sigue estas sencillas pautas:
Define Tu Objetivo
Comienza definiendo claramente tu objetivo. ¿Cómo se utilizarán los datos sintéticos en tu proyecto? ¿Estás analizando el comportamiento del cliente, probando software o entrenando un modelo? Comprender tu propósito ayuda en la planificación y dicta el tipo, estructura y calidad de los datos necesarios.
Elige un Tipo de Datos
Selecciona el tipo de datos adecuado para tu proyecto. ¿Necesitas imágenes, texto, audio, video o datos tabulares? Cada tipo de datos sirve un propósito específico e implica diferentes herramientas. Por ejemplo, la generación de imágenes a menudo involucra redes GAN, mientras que los datos de texto pueden requerir modelos lingüísticos. Elegir el tipo correcto asegura que aproveches al máximo las mejores herramientas para producir datos sintéticos valiosos.
Elige una Herramienta o Método
Puedes producir datos sintéticos usando varios métodos. Algunas técnicas comúnmente utilizadas incluyen:
- Sistemas Basados en Reglas: Ideales para generar conjuntos de datos simples y estructurados aplicando reglas o lógica específicas.
- Modelos de Simulación: Estos modelos simulan sistemas del mundo real, como tráfico, clima, o procesos de manufactura, para crear datos basados en comportamientos reales.
- GANs (Redes Generativas Antagónicas): Perfectas para crear contenido visual, las GANs son modelos de aprendizaje profundo que generan imágenes, caras o patrones complejos altamente realistas aprendiendo de datos reales.
- Autoencoders Variacionales (VAEs): Los VAEs usan aprendizaje profundo para producir nuevas muestras de imágenes o texto aprendiendo de distribuciones de datos, permitiendo datos sintéticos realistas.
- Augmentación de Datos: Esta técnica genera nuevas muestras de entrenamiento modificando ligeramente los datos del mundo real, como rotar, voltear o agregar ruido, para mejorar la resiliencia del modelo.
Establece Parámetros y Características
Determina los atributos que deben tener tus datos sintéticos. Estos elementos deben alinearse con el formato de entrada de tu modelo. Para datos tabulares, define categorías, rangos de valores y distribuciones. Para datos de imágenes, selecciona colores, formas y patrones de fondo. Para datos de texto, elige el tono, los temas, el idioma y las frases.
Genera los Datos
Usa tu herramienta o script elegido para generar los datos sintéticos. Dependiendo de la naturaleza y escala de los datos, este proceso puede tomar desde segundos hasta varias horas. Por ejemplo, generar 10,000 imágenes sintéticas en una máquina decente podría tomar varios minutos. Asegúrate de que los resultados se parezcan a las muestras reales y mantengan la calidad a lo largo del proceso de generación. Las herramientas consistentes producen mejores resultados.
Valida y Limpia los Datos
Después de generar los datos, evalúa cuidadosamente su calidad. Asegúrate de que cumplan con estándares o patrones razonables. Usa gráficos, comparaciones o estadísticas para identificar errores o anomalías. Elimina muestras rotas, extrañas o inutilizables del conjunto de datos. Los datos limpios facilitan un entrenamiento efectivo y sencillo. Organízalos en formatos apropiados como JPG, MP4 o CSV. Los datos bien etiquetados y sin errores mejoran el rendimiento del modelo.
Úsalo para el Entrenamiento
Ahora que tienes datos sintéticos limpios, úsalos para entrenar tu modelo de aprendizaje profundo, asegurándote de que se alineen con los requisitos de entrada de tu modelo. Si es necesario, combínalos con datos reales para mejorar el rendimiento y equilibrar el conjunto de datos. Un enfoque combinado a menudo produce mejores resultados que depender únicamente de datos sintéticos o reales. Entrena, prueba y ajusta tu modelo usando este nuevo conjunto de datos. Monitorea el rendimiento y vuelve a entrenar si es necesario. Los datos sintéticos aumentan la precisión y llenan las brechas de datos.
Conclusión:
Los datos sintéticos son una herramienta poderosa para superar los desafíos asociados con los datos reales. Son especialmente útiles cuando los datos son escasos, costosos o sensibles. Técnicas como GANs, VAEs y augmentación de datos permiten la creación de conjuntos de datos de aprendizaje profundo de alta calidad. Este enfoque ahorra tiempo y dinero, mejora la precisión del modelo y apoya el desarrollo. Independientemente de tu nivel de experiencia, los datos sintéticos ofrecen nuevas oportunidades para mejorar el rendimiento del modelo. Con la validación adecuada y el uso de herramientas, los datos sintéticos se convierten en un recurso crucial en el aprendizaje profundo, facilitando el entrenamiento de modelos efectivos de manera segura y rentable.
Artículos relacionados
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
Arquitectura de Hadoop: Comprendiendo sus Componentes Clave y Funcionalidad
Pérdida Hinge en Aprendizaje Automático: Perspectivas Clave y Aplicaciones
Uso de NotebookLM de Google para Ciencia de Datos: Una Guía Completa
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Términos Clave de la IA Generativa Explicados
Los 10 Mejores Canales de YouTube para Dominar SQL a Tu Propio Ritmo

La Verdadera Manera de Hacer que el Contenido se Vuelva Viral con ChatGPT
Herramientas de IA para Profesores: Identificando Brechas de Aprendizaje con Precisión
Construyendo un Chatbot de IA: Una Guía Paso a Paso
Herramientas de Aprendizaje Automático
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
