
Arquitectura de Hadoop: Comprendiendo sus Componentes Clave y Funcionalidad
En esta página
La explosión de datos en el mundo digital ha transformado la manera en que las organizaciones almacenan y procesan información. Las bases de datos tradicionales tienen dificultades para manejar grandes cantidades de datos de manera eficiente, y es aquí donde entra en juego Hadoop. Este marco de trabajo de código abierto permite el almacenamiento distribuido y el procesamiento paralelo de grandes conjuntos de datos a través de clústeres de computadoras.
Comprender la arquitectura de Hadoop es crucial para cualquiera que busque aprovechar las tecnologías de big data. El marco de trabajo está construido sobre un diseño simple pero poderoso que permite a las organizaciones almacenar, procesar y analizar grandes conjuntos de datos de manera rentable. Pero, ¿qué hace que la arquitectura de Hadoop sea tan efectiva?
Componentes Clave de Hadoop
Hadoop opera en un sistema distribuido que descompone grandes tareas de datos en piezas más pequeñas y las distribuye a través de múltiples máquinas para su procesamiento. La arquitectura consta principalmente de tres componentes clave: el Sistema de Archivos Distribuidos de Hadoop (HDFS), YARN (Yet Another Resource Negotiator) y el modelo de programación MapReduce. Estos elementos trabajan juntos para garantizar alta disponibilidad, tolerancia a fallos y procesamiento eficiente.
HDFS es el núcleo de Hadoop, ofreciendo un sistema de almacenamiento escalable y tolerante a fallos donde grandes conjuntos de datos pueden dividirse en varias máquinas. A diferencia de los sistemas de almacenamiento convencionales, HDFS está optimizado para manejar datos no estructurados al dividir grandes archivos en bloques más pequeños, que luego se distribuyen a través de varios nodos dentro de un clúster. Cada bloque se replica varias veces para evitar la pérdida de datos debido a fallos de hardware. Esta redundancia mantiene la integridad de los datos incluso cuando los nodos se vuelven inaccesibles.
YARN sirve como el gestor de recursos dentro del marco de Hadoop. Administra los recursos de cómputo de manera dinámica según los requisitos de varias tareas de procesamiento. Antes de YARN, Hadoop dependía únicamente de MapReduce para procesar y gestionar recursos, lo que lo hacía menos flexible. YARN distingue estas dos funciones para que varios modelos de procesamiento de datos puedan coexistir dentro del marco de Hadoop. Aplicaciones distintas a MapReduce, incluidas Apache Spark y Tez, pueden ejecutarse en clústeres de Hadoop de manera eficiente.
MapReduce es el modelo de programación que permite el procesamiento paralelo de datos a través de clústeres. Divide las tareas en dos fases principales: Map y Reduce. La fase Map procesa los datos de entrada convirtiéndolos en pares clave-valor, mientras que la fase Reduce agrega y resume la información procesada. Este enfoque permite a Hadoop procesar enormes cantidades de datos de manera distribuida, haciéndolo adecuado para analizar datos estructurados, semiestructurados y no estructurados. Sin embargo, debido a limitaciones de rendimiento, muchas organizaciones ahora complementan o reemplazan MapReduce con motores de procesamiento más rápidos como Apache Spark.
Cómo Hadoop Garantiza la Tolerancia a Fallos y la Escalabilidad
Una de las fortalezas más significativas de la arquitectura de Hadoop es su capacidad para manejar fallos sin interrumpir el procesamiento de datos. En un sistema tradicional, el fallo de una sola máquina podría significar la pérdida de datos o la interrupción del proceso. Sin embargo, Hadoop está construido con la tolerancia a fallos en mente. Logra esto mediante la replicación de datos y la reasignación automática de tareas. Cuando un nodo en el clúster falla, Hadoop redirige automáticamente las tareas a otros nodos saludables, asegurando operaciones fluidas sin intervención manual.
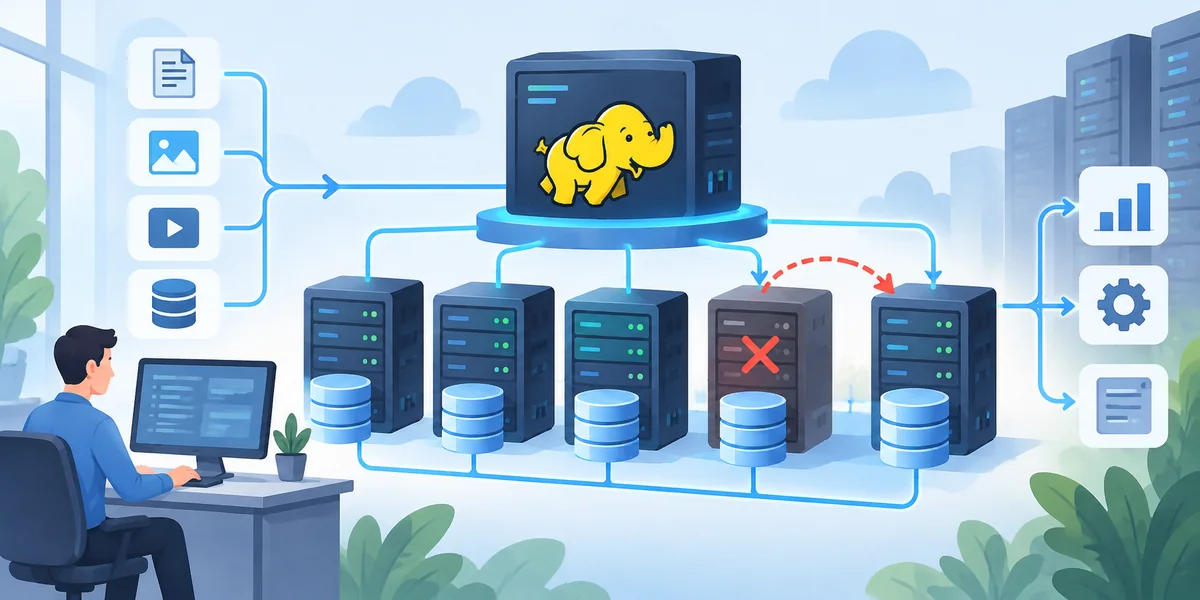
La escalabilidad es otra ventaja central de Hadoop. A diferencia de las bases de datos tradicionales que requieren costosas actualizaciones de hardware para escalar, Hadoop permite la escalabilidad horizontal. Esto significa que las organizaciones pueden expandir sus capacidades de almacenamiento y procesamiento simplemente añadiendo más máquinas de bajo costo al clúster. Ya sea que se trate de terabytes o petabytes de datos, Hadoop se adapta a las crecientes necesidades de almacenamiento y computación sin cambios arquitectónicos significativos.
Además, el diseño de Hadoop lo hace bien adaptado para manejar varios formatos de datos, incluidos datos relacionales estructurados, registros semiestructurados y contenido completamente no estructurado como imágenes y videos. Esta flexibilidad permite a las empresas obtener información de diferentes fuentes de datos sin las restricciones de las bases de datos tradicionales.
Casos de Uso Reales de Hadoop
Muchas industrias dependen de Hadoop para procesar grandes cantidades de datos de manera rápida y eficiente. En el sector salud, por ejemplo, hospitales e instituciones de investigación utilizan Hadoop para analizar registros de pacientes, datos genómicos y resultados de ensayos clínicos. La capacidad de procesar grandes conjuntos de datos en paralelo ayuda a identificar patrones y predecir brotes de enfermedades con mayor precisión.
En el sector financiero, bancos y firmas de inversión aprovechan Hadoop para detectar fraudes, analizar el comportamiento del cliente y evaluar riesgos. La capacidad de procesar registros de transacciones en tiempo real permite a las instituciones identificar actividades sospechosas antes de que causen daños financieros significativos.
Las empresas de retail y comercio electrónico también se benefician de las capacidades de procesamiento de datos de Hadoop. Al analizar las preferencias de los clientes, el historial de compras y las tendencias del mercado, las empresas pueden personalizar recomendaciones y optimizar la gestión de inventario. Esto mejora la satisfacción del cliente mientras minimiza los costos operativos.
Hadoop también es ampliamente utilizado en motores de búsqueda y plataformas de redes sociales. Empresas como Facebook, Twitter y Google dependen de Hadoop para procesar grandes volúmenes de contenido generado por los usuarios. Esto les permite indexar información, entregar resultados de búsqueda más rápido y mejorar las recomendaciones de contenido basadas en el comportamiento del usuario.
El Futuro de Hadoop y su Relevancia Hoy
A pesar del surgimiento de nuevos marcos de procesamiento de datos, Hadoop sigue siendo una tecnología central en el big data. Continúa integrándose con herramientas modernas como Apache Spark, Kubernetes y soluciones de almacenamiento en la nube. Aunque la relevancia de MapReduce ha disminuido debido a su menor rendimiento en comparación con los motores en memoria, HDFS y YARN de Hadoop siguen siendo esenciales para la gestión de datos a gran escala.
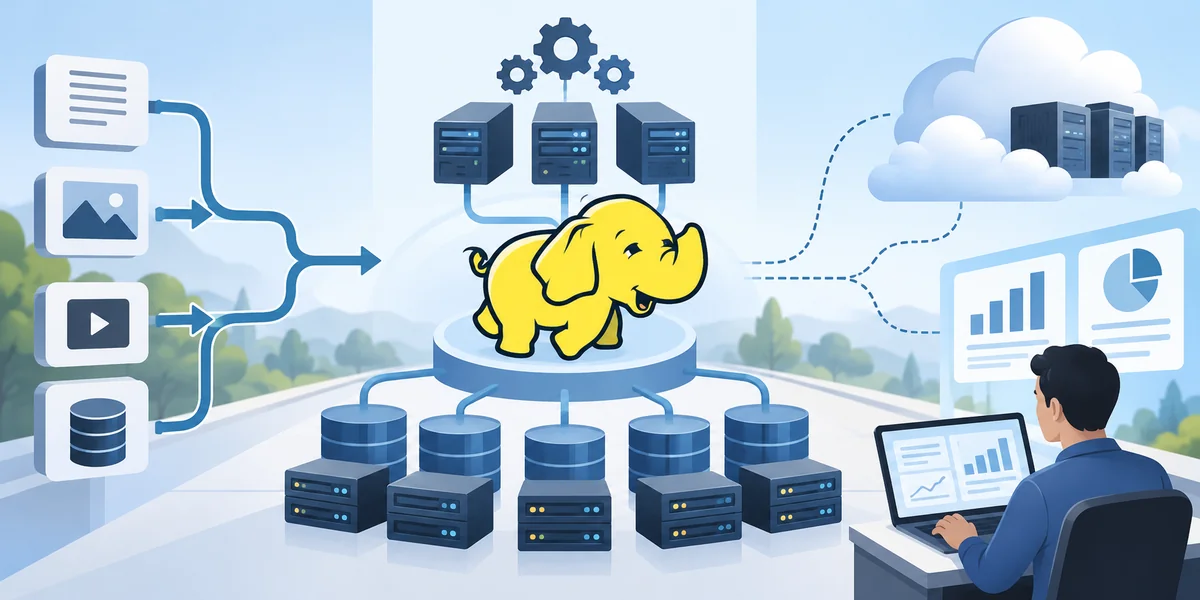
El cambio hacia la computación en la nube ha acelerado la evolución de Hadoop. Muchas organizaciones ahora utilizan plataformas en la nube como AWS, Google Cloud y Microsoft Azure para gestionar clústeres de Hadoop. Este enfoque híbrido aprovecha la escalabilidad de los servicios en la nube mientras mantiene la robusta arquitectura de Hadoop.
Hadoop sigue siendo un marco poderoso para procesar grandes conjuntos de datos, ofreciendo almacenamiento distribuido, tolerancia a fallos y flexibilidad en varios tipos de datos. A medida que la necesidad de soluciones de big data continúa creciendo, la arquitectura de Hadoop asegura que las empresas puedan almacenar, procesar y analizar datos de manera eficiente a una escala nunca antes posible.
Conclusión
La relevancia continua de Hadoop, a pesar del surgimiento de nuevas tecnologías, destaca su fortaleza y adaptabilidad. A medida que la computación en la nube y las herramientas modernas de procesamiento de datos evolucionan, la arquitectura de Hadoop asegura que siga siendo una solución poderosa para gestionar y analizar conjuntos de datos a gran escala. Ya sea integrada con servicios en la nube o utilizada en un entorno híbrido, su tolerancia a fallos, escalabilidad y flexibilidad la hacen indispensable en las operaciones de big data. A medida que la demanda de soluciones de big data crece, los principios de Hadoop continuarán moldeando el panorama de la gestión y el procesamiento de datos.
Artículos relacionados

Modelado de Datos Conceptual: Estructurando Datos para Claridad y Eficiencia

Cómo la IA Generativa Puede Ayudarte a Mejorar tus Gráficas de Visualización de Datos

Desempaquetando Hadoop vs. Spark: Perspectivas sobre el Procesamiento de Datos
El Poder del Procesamiento de Imágenes: Cómo Transforma los Datos Digitales
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
