
Análisis de Clúster en R: Descubriendo Estructuras de Datos Ocultas
En esta página
El análisis de clúster es una técnica fundamental en la ciencia de datos, crucial para descubrir patrones y relaciones dentro de los conjuntos de datos. Juega un papel significativo en áreas como la segmentación de mercado, la detección de anomalías y la genética. R, un potente lenguaje de computación estadística, ofrece herramientas robustas para un agrupamiento eficiente. Al agrupar puntos de datos similares, el agrupamiento mejora la toma de decisiones en diversos campos, incluida la analítica de clientes y la investigación médica.
Ya sea examinando tendencias sociales o métricas empresariales, implementar análisis de clúster en R proporciona valiosos conocimientos. Al utilizar técnicas como k-means o agrupamiento jerárquico, los datos en bruto pueden transformarse en patrones accionables, conduciendo a estrategias más inteligentes y perspectivas más profundas.
Entendiendo el Análisis de Clúster
El análisis de clúster implica clasificar puntos de datos similares basándose en características específicas. A diferencia de la clasificación, que aplica etiquetas preexistentes, el agrupamiento es un método no supervisado que identifica agrupaciones naturales en los datos. Esta técnica es especialmente beneficiosa para descubrir estructuras subyacentes sin conocimiento previo de categorías existentes.
Las técnicas de agrupamiento más comunes incluyen el agrupamiento jerárquico, el agrupamiento k-means y el agrupamiento basado en densidad. Cada método sobresale bajo ciertas condiciones y se selecciona según el tipo de datos y el objetivo del análisis. Por ejemplo, el agrupamiento k-means es efectivo cuando se conoce el número de clústeres, mientras que el agrupamiento jerárquico ofrece más flexibilidad para descubrir relaciones entre grupos. Las técnicas basadas en densidad como DBSCAN son excelentes para detectar clústeres de formas y tamaños variables.
El éxito del análisis de clúster requiere elegir medidas de similitud apropiadas. Métricas como la distancia euclidiana, la distancia de Manhattan o la similitud del coseno determinan cómo se agrupan los puntos de datos. La calidad del agrupamiento depende significativamente de la selección del métrico correcto. El preprocesamiento de datos, incluida la normalización y el escalado, asegura un agrupamiento imparcial a pesar de las escalas diferentes de características numéricas.
Preparación de Datos para el Análisis de Clúster
Preparar el conjunto de datos es esencial antes de realizar el análisis de clúster en R. Los datos en bruto a menudo contienen ruido, valores perdidos o características en escalas variables, lo que puede sesgar los resultados de agrupamiento. R ofrece varios paquetes como dplyr, tidyverse y cluster para limpiar y preprocesar datos de manera efectiva.
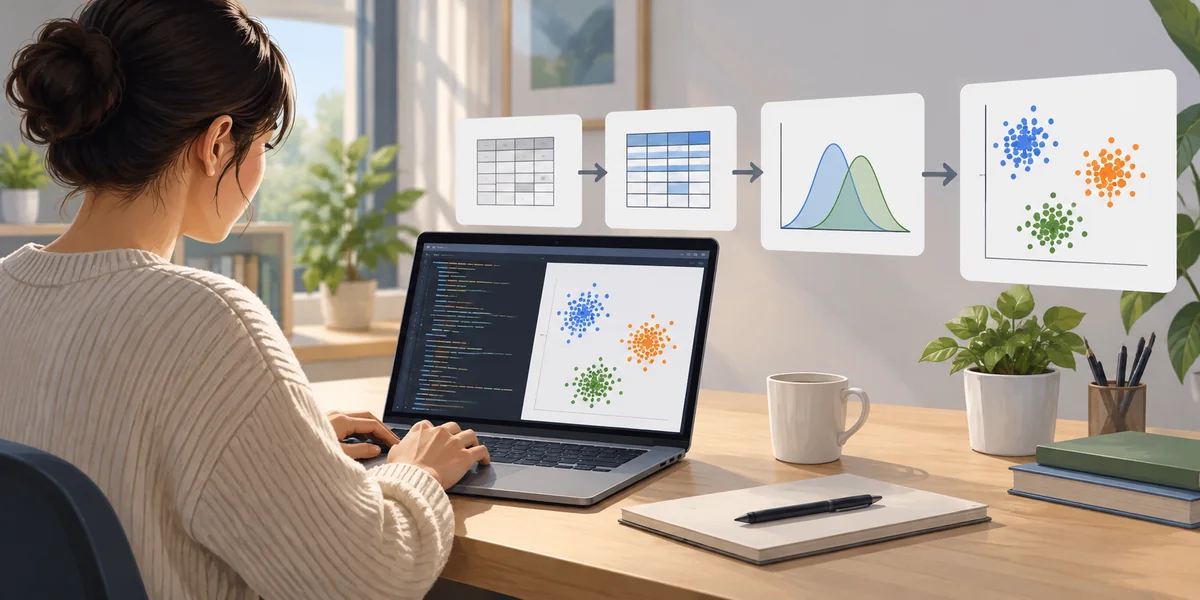
El primer paso implica cargar un conjunto de datos, que puede importarse a R usando la función read.csv(). Manejar los valores perdidos implica estrategias como la imputación de la media o eliminar filas con datos perdidos excesivos. Después de limpiar el conjunto de datos, la estandarización asegura que las variables con rangos numéricos mayores no dominen el algoritmo de agrupamiento, a menudo logrado usando la función scale() en R.
El Análisis de Componentes Principales (PCA) también puede utilizarse para reducir la dimensionalidad antes del agrupamiento, mejorando el rendimiento y la visualización. Al tratar con datos de alta dimensionalidad, el PCA extrae las características más significativas, reduciendo el tiempo de computación. La función prcomp() en R simplifica este proceso, facilitando el manejo de conjuntos de datos con numerosas variables.
Implementando el Análisis de Clúster en R
La elección del algoritmo para el análisis de clúster en R depende de la naturaleza del conjunto de datos. El agrupamiento k-means es uno de los métodos más utilizados debido a su eficiencia y simplicidad. La función kmeans() en R divide los datos en un número específico de clústeres. Elegir el número correcto de clústeres es crucial y a menudo se determina usando el método del codo, que implica graficar la variación total dentro del clúster contra el número de clústeres y seleccionar el punto donde la reducción de la variación se desacelera. La función fviz_nbclust() del paquete factoextra proporciona una forma visual de encontrar el número óptimo de clústeres.
Otro enfoque popular es el agrupamiento jerárquico, que no requiere especificar el número de clústeres de antemano. En su lugar, construye una estructura similar a un árbol conocida como dendrograma para representar las relaciones entre los puntos de datos. La función hclust() en R se usa para el agrupamiento jerárquico, y los diferentes métodos de enlace, como el completo, simple y promedio, influyen en la estructura final del clúster. Una vez completado el agrupamiento, se usa cutree() para extraer el número deseado de clústeres.
DBSCAN es preferido para conjuntos de datos con ruido o densidades variables. A diferencia de k-means o el agrupamiento jerárquico, DBSCAN no requiere especificar el número de clústeres de antemano. Utiliza un enfoque basado en densidad para identificar clústeres. La función dbscan() del paquete dbscan en R se utiliza para este método. DBSCAN identifica eficazmente clústeres de diferentes formas, pero requiere una selección cuidadosa de parámetros como eps, que controla el tamaño del vecindario.
Después del agrupamiento, evaluar la calidad del clúster es esencial. El análisis de silueta mide qué tan bien los puntos de datos se ajustan a sus clústeres asignados. La función silhouette() en R ayuda a evaluar la efectividad del agrupamiento. Una puntuación de silueta más alta indica clústeres bien definidos, mientras que puntuaciones más bajas sugieren grupos superpuestos o mal separados.
Interpretando y Visualizando Clústeres
Después de realizar el agrupamiento, entender los resultados a través de la visualización es crucial. R proporciona varias herramientas para visualizar clústeres. Los gráficos de dispersión utilizando ggplot2 pueden mostrar datos agrupados en un espacio bidimensional. Para conjuntos de datos con más de dos variables, factoextra y ggplot2 ayudan a crear visualizaciones basadas en PCA para interpretar mejor las estructuras de clúster.
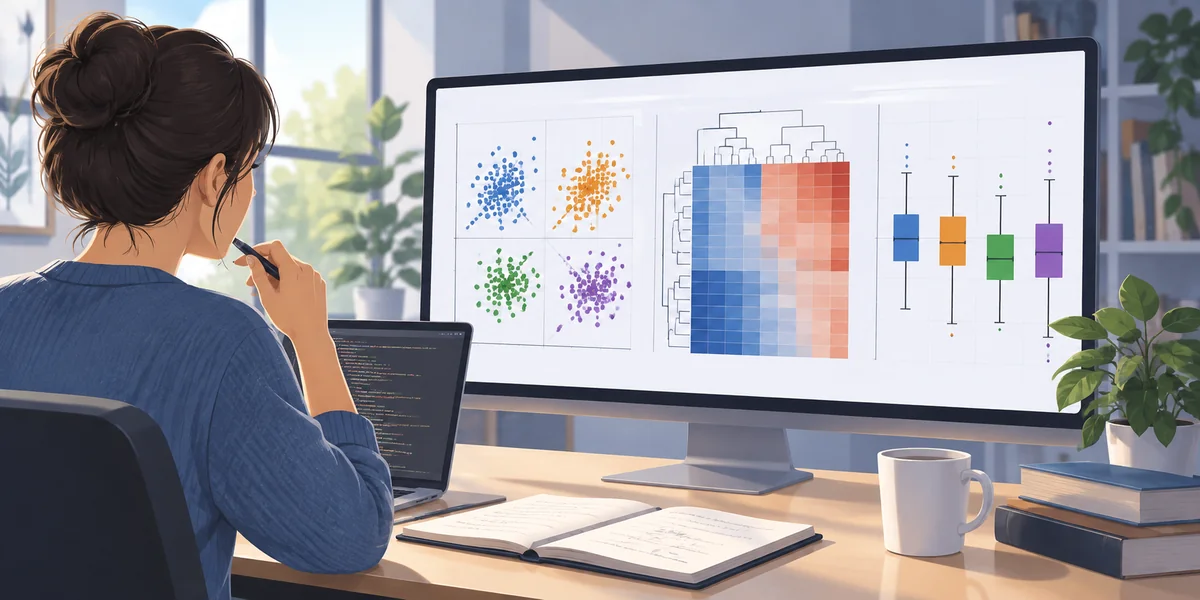
Los mapas de calor ofrecen otra manera de observar los resultados de agrupamiento, particularmente para el agrupamiento jerárquico. La función heatmap() en R proporciona una representación intuitiva de cómo los puntos de datos se relacionan dentro de los clústeres. Los centros de clúster y las distribuciones también pueden analizarse usando gráficos de caja para entender las variaciones dentro de cada grupo.
Para aplicaciones empresariales o de investigación, interpretar clústeres implica identificar características comunes entre los puntos de datos agrupados. En la segmentación de clientes, por ejemplo, los clústeres pueden revelar comportamientos o preferencias de compra. En el cuidado de la salud, el agrupamiento puede ayudar a identificar grupos de pacientes con condiciones médicas similares, ayudando en tratamientos dirigidos.
Conclusión
Dar sentido a datos complejos es un desafío, pero el análisis de clúster en R simplifica el proceso al identificar agrupaciones naturales. Ya sea utilizando k-means para una segmentación rápida, el agrupamiento jerárquico para obtener perspectivas más profundas o DBSCAN para manejar datos ruidosos, el enfoque correcto depende de la estructura del conjunto de datos. El preprocesamiento adecuado y la evaluación cuidadosa aseguran que los clústeres sean significativos y útiles. Las técnicas de visualización como los gráficos de dispersión y los mapas de calor aportan claridad a los resultados, haciendo el análisis más intuitivo. Con las herramientas robustas de agrupamiento de R, cualquier persona que trabaje con datos, desde empresas hasta investigadores, puede extraer valiosos conocimientos, conduciendo a decisiones más inteligentes y una comprensión más clara de los patrones.
Artículos relacionados
Explorando el Papel de la IA en Redes Inteligentes para una Gestión Eficiente de la Energía
El Papel de la IA en la Analítica Deportiva: Transformando Datos en Perspectivas Revolucionarias
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos
Una Guía para Bloquear Celdas en Excel Fácilmente y Proteger tus Datos Efectivamente
6 Robots Enfermeros con IA que Están Transformando el Cuidado de la Salud
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Medir la Adopción e Impacto de la IA

IA en el Cuidado de la Salud: Avances Actuales y Oportunidades Futuras
Visualizando Patrones: 2 Métodos para Crear un Mapa de Calor en Power BI
5 Maneras en que la Inteligencia Artificial está Transformando el E-Learning
Detección de Anomalías en Aprendizaje Automático: Descubriendo Patrones Ocultos en Datos
Técnicas de Procesamiento de Lenguaje Natural: El Futuro de la Comunicación en IA
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
