
Las 5 Vs del Big Data: Comprendiendo su Papel en la Gestión de Datos
En esta página
Los datos están en todas partes, inundándonos desde teléfonos inteligentes, redes sociales, sensores y un sinfín de interacciones digitales. Sin embargo, los datos en bruto por sí solos no tienen valor. Lo que realmente importa es la capacidad de procesar, analizar y extraer insights. Aquí es donde entra el Big Data, un concepto que no solo se refiere al tamaño, sino también a la velocidad, la complejidad y la fiabilidad.
Para entender el Big Data, los expertos se refieren a las 5 Vs, cinco características fundamentales que describen cómo se comportan los datos y por qué es tan desafiante trabajar con ellos. Estos factores determinan cómo las empresas, investigadores e industrias transforman flujos de datos caóticos en insights útiles que impulsan decisiones e innovación.
Desglosando las 5 Vs del Big Data
Comprender el Big Data va más allá de apreciar su magnitud. Las 5 Vs—Volumen, Velocidad, Variedad, Veracidad y Valor—destacan las complejidades de procesar grandes cantidades de datos y derivar insights útiles de ellos.
Volumen: El Tamaño Absoluto de los Datos
La dimensión más prominente del Big Data es el volumen. Cada minuto, se generan millones de mensajes, correos electrónicos y búsquedas. Solo las redes sociales contribuyen con una cantidad asombrosa, ya que los individuos publican constantemente fotografías, videos y actualizaciones. Las empresas, gobiernos e instituciones reciben enormes cantidades de datos que deben ser almacenados, procesados y analizados.
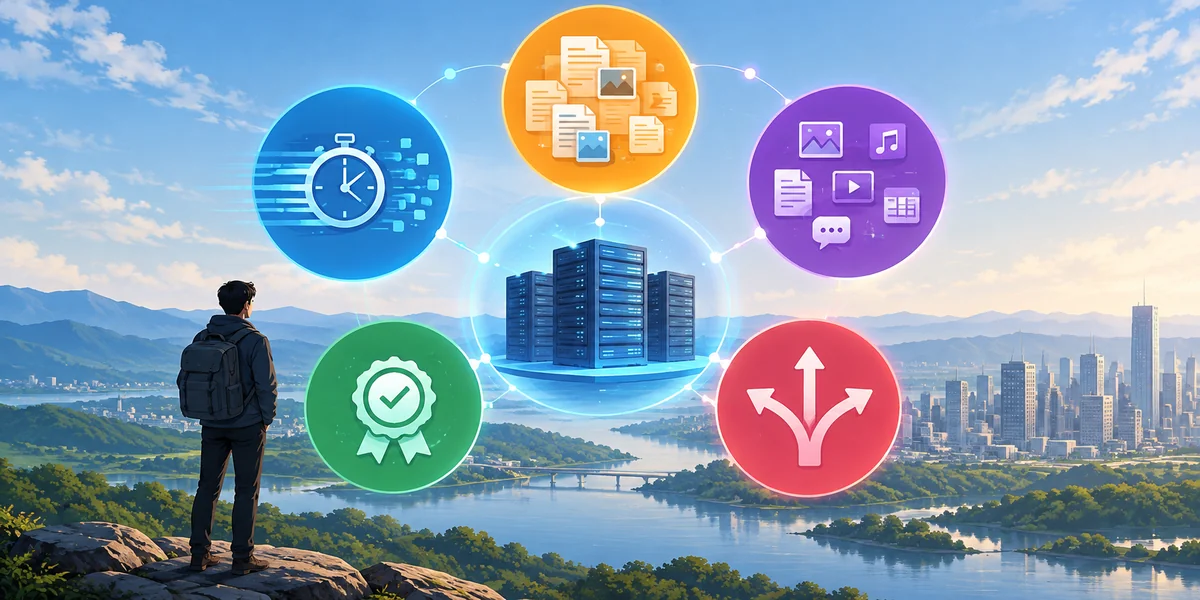
Los avances en la tecnología de almacenamiento han apoyado este crecimiento. Los sistemas de almacenamiento distribuidos, los data lakes y la computación en la nube permiten almacenar exabytes o petabytes de datos. Pero el desafío no es solo almacenar datos; es descifrarlos. Conjuntos de datos tan grandes son difíciles para las bases de datos tradicionales, lo que lleva a soluciones de almacenamiento y procesamiento más complejas como Hadoop y bases de datos NoSQL.
Para las empresas, aprovechar vastas cantidades de datos puede traducirse en mejores insights, decisiones mejoradas y la capacidad de ofrecer productos y servicios personalizados. Sin las herramientas adecuadas, el exceso de información puede convertirse en un obstáculo en lugar de un activo.
Velocidad: La Rapidez con la que se Mueven los Datos
Los datos se mueven a una velocidad vertiginosa. En el mundo actual, el procesamiento de datos en tiempo real es cada vez más importante. Ya sea transacciones del mercado de valores, actualizaciones deportivas en vivo o mensajería instantánea, la información fluye a un ritmo increíble. Las empresas deben analizar los datos a medida que llegan, en lugar de almacenarlos para revisarlos más tarde.
Los métodos tradicionales de procesamiento de datos a menudo tienen dificultades con este requerimiento. Para cuando los datos antiguos son procesados, nueva información ya ha cambiado el panorama. Los sistemas modernos de análisis utilizan tecnologías como el procesamiento de flujos y la computación en memoria para manejar datos de alta velocidad. Empresas como Amazon, Google y Netflix dependen del procesamiento rápido de datos para proporcionar recomendaciones en tiempo real, detectar fraudes y mejorar las experiencias de los usuarios.
La velocidad es crítica en industrias como la salud y las finanzas. Un retraso en la detección de un ciberataque o en el diagnóstico de una condición médica puede tener serias consecuencias. La velocidad asegura que los insights lleguen cuando se necesitan, no después de que la oportunidad haya pasado.
Variedad: Las Muchas Formas de los Datos
Los datos no vienen en un solo formato ordenado. En el pasado, la información era mayormente estructurada—piensa en hojas de cálculo, registros de clientes e informes de ventas. Hoy en día, los datos existen en innumerables formas. Publicaciones en redes sociales, videos, imágenes, correos electrónicos y lecturas de sensores contribuyen al creciente caudal de información, haciendo que los datos sean más complejos y difíciles de gestionar.
Los datos estructurados, que se encuentran en bases de datos tradicionales, son fáciles de analizar debido a su formato fijo. Sin embargo, la mayoría de los datos hoy son no estructurados o semi-estructurados, lo que significa que no encajan perfectamente en tablas. Los correos electrónicos, documentos y archivos multimedia requieren diferentes técnicas de procesamiento.
Las empresas deben adaptarse a esta complejidad utilizando herramientas que puedan manejar diversos tipos de datos. Los algoritmos impulsados por IA, el procesamiento del lenguaje natural y el reconocimiento de imágenes ayudan a las empresas a dar sentido a la información desordenada y no estructurada. Sin la capacidad de procesar diversos tipos de datos, las organizaciones corren el riesgo de perder valiosos insights ocultos dentro de sus conjuntos de datos.
Veracidad: Asegurando la Precisión y Fiabilidad de los Datos
No todos los datos son confiables. En una era de desinformación, la calidad de los datos es una preocupación importante. La información falsa, los registros duplicados y los conjuntos de datos incompletos pueden llevar a malas decisiones. La veracidad se refiere a la precisión y fiabilidad de los datos. Si las organizaciones no pueden confiar en sus datos, sus conclusiones y estrategias serán erróneas.
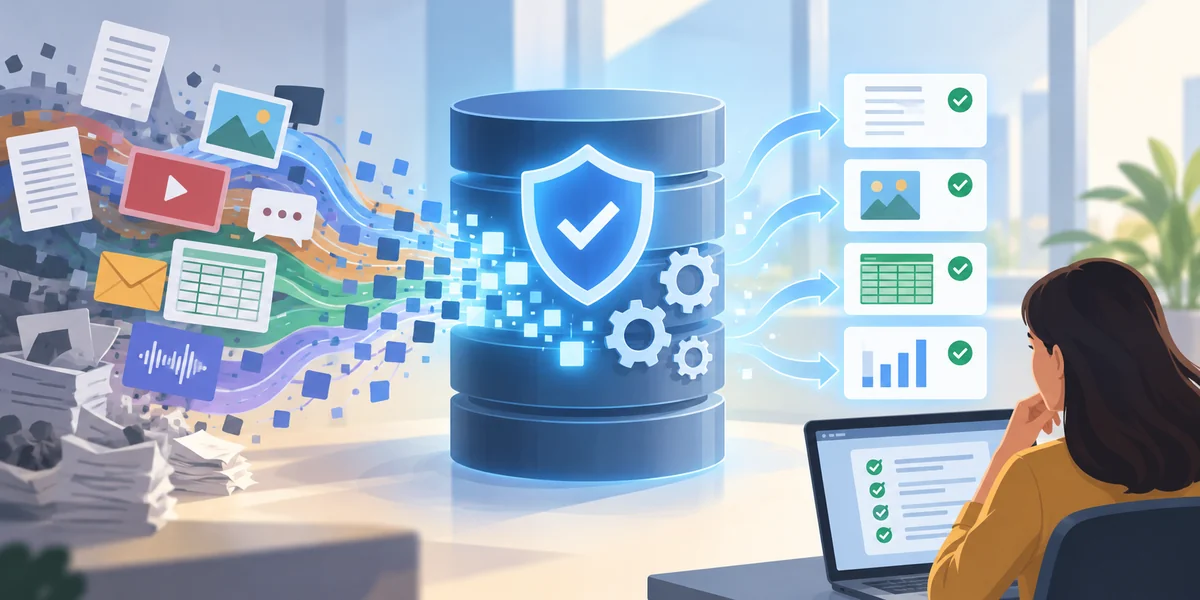
Las técnicas de limpieza y validación de datos son cruciales para garantizar la fiabilidad. Esto implica eliminar inconsistencias, completar valores faltantes y verificar fuentes. Las empresas también utilizan IA y aprendizaje automático para detectar patrones que indican fraude, errores o manipulaciones.
Los datos de mala calidad pueden ser desastrosos para industrias como la salud y las finanzas, donde la precisión es crucial. Errores en los registros de pacientes de un hospital podrían llevar a tratamientos incorrectos, mientras que datos financieros inexactos podrían causar errores costosos para las firmas de inversión. Asegurar la veracidad es esencial para mantener la confianza en las decisiones basadas en datos.
Valor: Convertir los Datos en Insights
La última y quizás más importante “V” es el valor. Recopilar y analizar datos no tiene sentido a menos que proporcione beneficios reales. El objetivo final del Big Data no es solo almacenar grandes cantidades de información, sino generar insights que impulsen el progreso, la eficiencia y la innovación.
Las empresas invierten en análisis de datos para mejorar decisiones, mejorar experiencias de cliente y aumentar la eficiencia. Los minoristas analizan tendencias de compra para gestionar inventarios, los proveedores de salud rastrean patrones de enfermedades para mejorar tratamientos, y los equipos deportivos utilizan datos para refinar estrategias, todos aprovechando los insights para obtener una ventaja competitiva.
Sin embargo, extraer valor de los datos requiere el enfoque correcto. Las empresas necesitan analistas capacitados, modelos avanzados de aprendizaje automático y poderosas herramientas de visualización para interpretar conjuntos de datos complejos. Sin un análisis adecuado, los datos siguen siendo solo una colección de números sin uso práctico.
Conclusión
Las 5 Vs del Big Data—Volumen, Velocidad, Variedad, Veracidad y Valor—definen cómo las organizaciones procesan y utilizan enormes cantidades de información. Manejar eficazmente estos factores permite a las empresas extraer insights significativos, mejorar la eficiencia y tomar decisiones basadas en datos. A medida que la tecnología avanza, la capacidad de manejar el Big Data será aún más crítica, moldeando industrias e impulsando la innovación. Las organizaciones que adopten estos principios se mantendrán a la vanguardia, convirtiendo datos en bruto en conocimiento valioso que alimenta el progreso y la ventaja competitiva en un mundo cada vez más impulsado por datos.
Artículos relacionados

Una Guía de Herramientas de Visualización de Big Data: Tipos, Beneficios y Elegir la Adecuada

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
Arquitectura de Hadoop: Comprendiendo sus Componentes Clave y Funcionalidad

El Papel de un Curador de Datos: Organizando y Gestionando Datos de Calidad
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
IA Generativa para Científicos de Datos en 2025: Más Allá de la Generación de Texto
Las Mejores Herramientas de Gestión de Proyectos con IA en 2025
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
¿Qué son las Redes Generativas Adversarias (GANs)?
Comprendiendo el Impacto de la IA en la Escritura Creativa

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
