
Biblioteca Pandas de Python: Una Guía Completa para el Análisis de Datos
En esta página
En el mundo impulsado por datos de hoy, gestionar grandes cantidades de información puede volverse rápidamente abrumador. La biblioteca Pandas de Python ofrece una solución poderosa para la gestión y análisis de datos. Ya seas un científico de datos, investigador o analista de negocios, Pandas agiliza tareas como la limpieza, transformación y análisis de datos, convirtiendo flujos de trabajo complejos en procesos sin fisuras.
Pandas proporciona una interfaz fácil de usar y capacidades robustas, convirtiéndola en una herramienta esencial para cualquiera que maneje datos estructurados. Exploremos cómo Pandas puede hacer que el manejo de datos sea más fluido y simplifique tareas complejas.
Comprendiendo Pandas y Sus Características Principales
Pandas es una biblioteca de Python de código abierto diseñada para la manipulación y análisis de datos. Construida sobre NumPy, ofrece estructuras de datos poderosas como Series y DataFrame, permitiendo a los usuarios almacenar y manipular datos de manera eficiente. A diferencia de las herramientas tradicionales de hojas de cálculo, Pandas realiza operaciones de alta eficiencia en grandes conjuntos de datos. La ventaja clave de Pandas es su procesamiento intuitivo de datos estructurados, crucial para gestionar grandes volúmenes de datos.
La estructura de datos más básica en Pandas es la Serie, un arreglo unidimensional similar a una columna de hoja de cálculo. Una Serie incluye valores y etiquetas asociadas, simplificando el acceso a elementos específicos. La segunda estructura fundamental es el DataFrame, una tabla bidimensional capaz de almacenar y manipular tipos de datos heterogéneos, similar a una hoja de Excel. Los DataFrames soportan operaciones de ordenamiento, filtrado, agrupamiento y combinación, haciéndolos invaluables para gestionar conjuntos de datos complejos.
Pandas también maneja eficientemente los datos faltantes, un problema común en los conjuntos de datos reales. Ofrece funcionalidades integradas para identificar, completar o eliminar valores faltantes con mínima intervención manual. Además, Pandas se integra sin problemas con otros paquetes de Python, incluyendo Matplotlib y Seaborn para gráficos, NumPy para cálculos numéricos y bases de datos SQL para consultas estructuradas.
¿Por Qué Pandas es Esencial para el Manejo de Datos?
El manejo eficiente de datos es crucial en diversas industrias, haciendo a Pandas indispensable para la manipulación y análisis de datos. En la ciencia de datos, los profesionales trabajan con grandes volúmenes de datos que requieren limpieza y transformación antes de que se puedan extraer conclusiones. Pandas simplifica estas tareas con funciones integradas fáciles de usar para reestructurar, agregar y analizar conjuntos de datos.
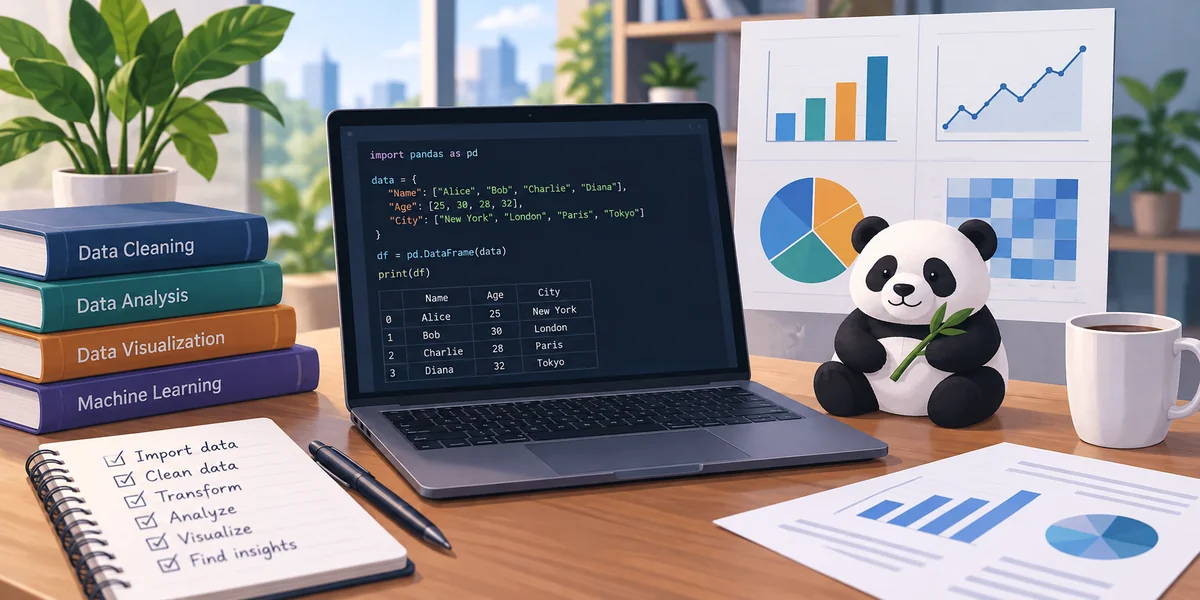
En los negocios, los equipos de marketing dependen de los datos de clientes para impulsar decisiones estratégicas. Pandas les permite filtrar transacciones, identificar tendencias y visualizar patrones, agilizando el proceso de extracción de ideas accionables. En finanzas, Pandas es esencial para gestionar datos del mercado de valores, analizar rendimiento y calcular métricas clave de riesgo. Investigadores y científicos también usan Pandas para procesar eficientemente datos experimentales, convirtiéndola en una herramienta integral para profesionales de datos en diversas áreas.
La eficiencia de Pandas es una característica destacada. A diferencia de las aplicaciones tradicionales de hojas de cálculo que tienen dificultades con grandes conjuntos de datos, Pandas opera eficazmente con millones de filas de datos. Esta capacidad permite a los usuarios abordar problemas del mundo real sin problemas de memoria o ralentizaciones. Además, Pandas puede leer y escribir múltiples formatos de archivo como CSV, Excel, JSON y SQL, asegurando un manejo de datos sin problemas en diferentes plataformas y casos de uso.
¿Cómo Transforma Pandas el Análisis de Datos?
Pandas es una herramienta poderosa que agiliza varias etapas del análisis de datos, incluyendo la recolección, limpieza, transformación y visualización de datos. Una de sus características clave es el filtrado de datos, permitiendo a los usuarios extraer subconjuntos relevantes de grandes conjuntos de datos sin esfuerzo. Los analistas pueden ordenar rápidamente grandes cantidades de datos usando comandos simples, simplificando la búsqueda de información específica.
Otra característica valiosa es el agrupamiento y agregación de datos. La función groupby() de Pandas simplifica el proceso de resumir y comparar segmentos de datos, como analizar ingresos por región o demografía de clientes. Además, sus capacidades de combinación y unión de datos permiten a los usuarios combinar múltiples conjuntos de datos sin problemas, ahorrando tiempo y reduciendo la complejidad.
La transformación de datos es una fortaleza clave de Pandas. Los datos en bruto a menudo contienen inconsistencias o duplicados. Con funciones como fillna() para manejar valores faltantes y drop_duplicates() para eliminar entradas redundantes, Pandas asegura la precisión y fiabilidad de los datos.
Pandas también se integra bien con herramientas de visualización como Matplotlib y Seaborn, permitiendo a los usuarios generar gráficos y diagramas detallados que revelan tendencias y correlaciones.
Además, Pandas juega un papel significativo en el aprendizaje automático al preparar conjuntos de datos para entrenar modelos, manejando tareas como codificación de datos categóricos, normalización de valores, manejo de valores atípicos y asegurando la correcta estructuración de datos antes de aplicar técnicas de aprendizaje automático.
El Futuro de Pandas en la Ciencia de Datos
A medida que la demanda de toma de decisiones basada en datos aumenta, Pandas continúa evolucionando para enfrentar nuevos desafíos. La biblioteca se actualiza frecuentemente con mejoras de rendimiento para mantener su eficiencia con conjuntos de datos a gran escala. Con el auge de los big data, la computación en la nube y la inteligencia artificial, Pandas está siendo optimizada para manejar tareas más complejas.
Un avance importante es el soporte mejorado para flujos de datos en tiempo real, permitiendo a las empresas en sectores como finanzas, IoT y redes sociales analizar datos en vivo sin problemas. Además, Pandas se está integrando con marcos de computación distribuida como Dask y Apache Spark, permitiendo a los usuarios escalar operaciones a través de múltiples máquinas.
Otro desarrollo emocionante es la integración de Pandas con plataformas de análisis en la nube, facilitando la manipulación y análisis de datos almacenados en la nube. A medida que la popularidad de Pandas crece, la educación y formación en Pandas se están volviendo más accesibles, con muchos recursos en línea y programas de capacitación empresarial disponibles para ayudar a los profesionales a desarrollar habilidades críticas de datos para la toma de decisiones.
Conclusión
Pandas es una biblioteca indispensable para cualquiera que trabaje con datos en Python. Simplifica tareas como la gestión, limpieza, transformación y análisis de datos, haciéndola esencial en diversas industrias. Con su integración sin problemas con otras herramientas de Python, es imprescindible para manejar datos estructurados. A medida que la tecnología evoluciona, Pandas continúa adaptándose, especialmente en big data, aprendizaje automático y computación en la nube. Aprender Pandas abre valiosas oportunidades, asegurando su lugar como una piedra angular en el ecosistema de datos de Python para los próximos años.
Artículos relacionados
Pandas en Python: La Clave para una Manipulación de Datos Sin Esfuerzo
Selenium Python: Una Guía para Automatizar Tareas Web Eficientemente

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Proyectos de IA Avanzados pero Simples, Perfectos para Principiantes
El Papel de la IA en la Analítica Deportiva: Transformando Datos en Perspectivas Revolucionarias
Análisis de Clúster en R: Descubriendo Estructuras de Datos Ocultas
Cómo Maneja Python la Memoria: Un Análisis Profundo de su Sistema de Gestión
Las 20 Herramientas de Desarrollo en Python que No Puedes Ignorar
Explorando el Papel de la IA en Redes Inteligentes para una Gestión Eficiente de la Energía
Gestión de la Privacidad de Datos con IA en la Creciente Era del Big Data
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
