
Pandas en Python: La Clave para una Manipulación de Datos Sin Esfuerzo
En esta página
Python se ha convertido en un lenguaje de programación líder, principalmente debido a su extenso ecosistema de bibliotecas. Entre ellas, Pandas destaca como una herramienta esencial para el análisis de datos. Pandas simplifica la gestión de hojas de cálculo, bases de datos y datos sin procesar al ofrecer estructuras intuitivas como DataFrames y Series para una manipulación eficiente. Optimiza tareas como el filtrado, la transformación y la realización de cálculos estadísticos, reduciendo la necesidad de codificación repetitiva.
Ideal tanto para principiantes como para profesionales, Pandas permite el procesamiento fluido de grandes conjuntos de datos. Su flexibilidad y potencia lo hacen indispensable para tareas que van desde simples transformaciones de datos hasta análisis de vanguardia, consolidando su estatus como una herramienta fundamental para cualquiera que trabaje con datos en Python.
¿Qué es Pandas?
Pandas es una biblioteca de Python de código abierto diseñada para la manipulación y análisis de datos. Proporciona estructuras de datos, principalmente Series y DataFrame, que permiten a los usuarios almacenar, acceder y procesar datos de manera eficiente. Diseñada para funcionar sin problemas con otras bibliotecas de computación científica como NumPy y Matplotlib, Pandas permite a los científicos de datos y analistas manejar grandes conjuntos de datos sin esfuerzo.
Creado por Wes McKinney en 2008 para ofrecer a los analistas financieros una herramienta simple de manipulación de datos, Pandas se ha convertido en una de las bibliotecas más populares de Python. Juega un papel vital en la ciencia de datos, el aprendizaje automático y la programación. Pandas es especialmente valorado por su capacidad para manejar datos estructurados, lo que lo hace ampliamente utilizado en campos como las finanzas, la investigación, la medicina y la inteligencia artificial.
Pandas optimiza procesos que de otro modo requerirían una extensa codificación manual. Con solo unas pocas líneas de código, los usuarios pueden limpiar, transformar y analizar conjuntos de datos, convirtiéndolo en una herramienta indispensable para cualquier programador de Python que trabaje con datos. Su sintaxis intuitiva y funciones robustas lo convierten en una opción superior para procesar conjuntos de datos de todos los tamaños, desde pequeñas colecciones hasta grandes plataformas de datos.
¿Cómo Funciona Pandas?
En su núcleo, Pandas gira en torno a dos estructuras de datos principales: la Serie y el DataFrame.
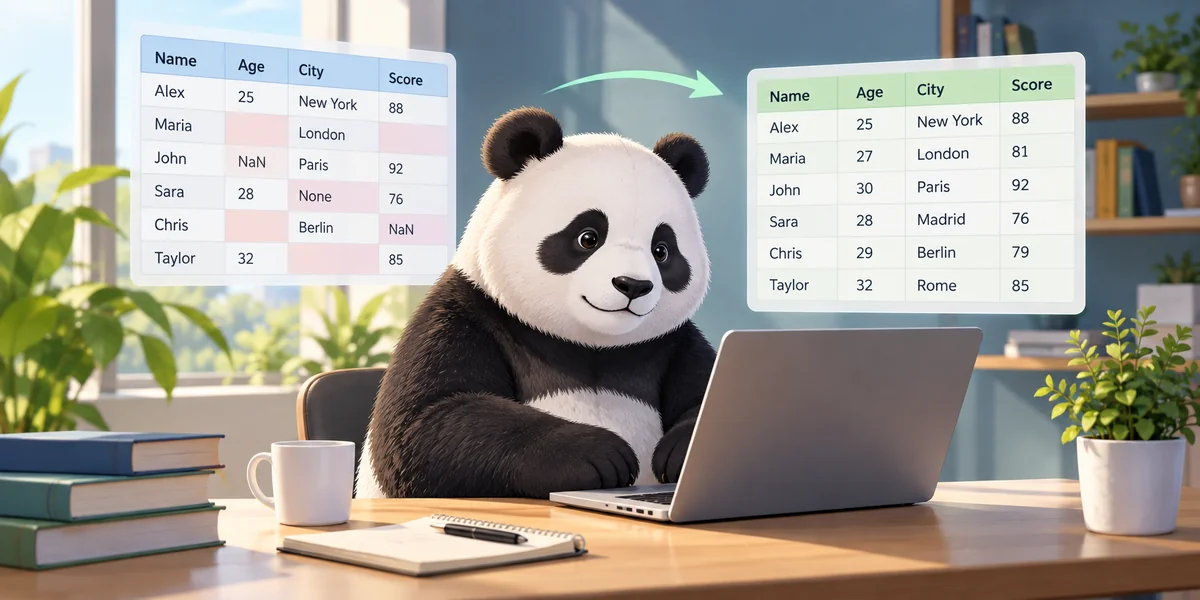
Una Serie es una estructura unidimensional similar a un array que contiene datos de cualquier tipo, como números, cadenas o incluso objetos de Python. Se asemeja a una columna en una hoja de cálculo o una lista simple de Python y es conveniente para manejar puntos de datos individuales o series temporales.
Un DataFrame, en contraste, es una estructura bidimensional que se asemeja a una tabla con filas y columnas. Esta es la estructura de datos más utilizada en Pandas, ya que facilita la organización de grandes cantidades de datos en un formato estructurado. Un DataFrame puede crearse a partir de múltiples fuentes de datos, incluidos archivos CSV, hojas de cálculo de Excel, bases de datos SQL o incluso diccionarios y listas.
Una de las características más potentes de Pandas es su capacidad para manejar datos faltantes sin problemas. A diferencia de las técnicas de programación tradicionales que requieren lógica condicional extensa para gestionar datos incompletos, Pandas ofrece funciones integradas para llenar, reemplazar o eliminar valores faltantes. Esto garantiza la integridad de los datos y ahorra tiempo al preparar conjuntos de datos para el análisis.
Además, Pandas hace que la manipulación de datos sea increíblemente sencilla. Los usuarios pueden filtrar, ordenar y agrupar datos utilizando una sintaxis simple, simplificando tareas como:
- Seleccionar columnas o filas específicas
- Aplicar operaciones matemáticas en conjuntos de datos
- Agregar datos según condiciones personalizadas
Pandas también se integra bien con bibliotecas de visualización como Matplotlib y Seaborn, permitiendo a los usuarios generar gráficos y diagramas directamente desde sus DataFrames. Esto lo convierte en una excelente herramienta para el análisis exploratorio de datos, donde se pueden identificar rápidamente patrones y tendencias.
Características Clave de Pandas
Pandas está lleno de características que hacen que la manipulación de datos sea sencilla y eficiente. Algunas características clave incluyen:
Estructuras de Datos Flexibles: Con Series y DataFrames, Pandas admite varios formatos de datos, permitiendo una manipulación, transformación y análisis sin problemas a través de diferentes aplicaciones.
Limpieza y Preparación de Datos: Pandas simplifica el manejo de valores faltantes, duplicados y datos inconsistentes, asegurando conjuntos de datos estructurados, precisos y de alta calidad para el análisis.
Integración Sin Esfuerzos: Pandas funciona con NumPy para cálculos numéricos y con Matplotlib para visualizaciones, mejorando los flujos de trabajo de análisis de datos en diferentes dominios.
Importación y Exportación de Datos Fácil: Pandas carga y guarda datos sin esfuerzo en múltiples formatos, incluidos CSV, Excel, JSON y SQL, facilitando el intercambio de datos entre varias plataformas.
¿Por Qué Pandas es Esencial para el Análisis de Datos?
Pandas se ha convertido en una herramienta fundamental para el análisis de datos porque maneja datos de manera eficiente. Los métodos tradicionales de manipulación de datos, como trabajar con listas y diccionarios en Python, pueden ser engorrosos e ineficientes. Pandas optimiza este proceso, haciendo que el procesamiento de datos sea más rápido y confiable.
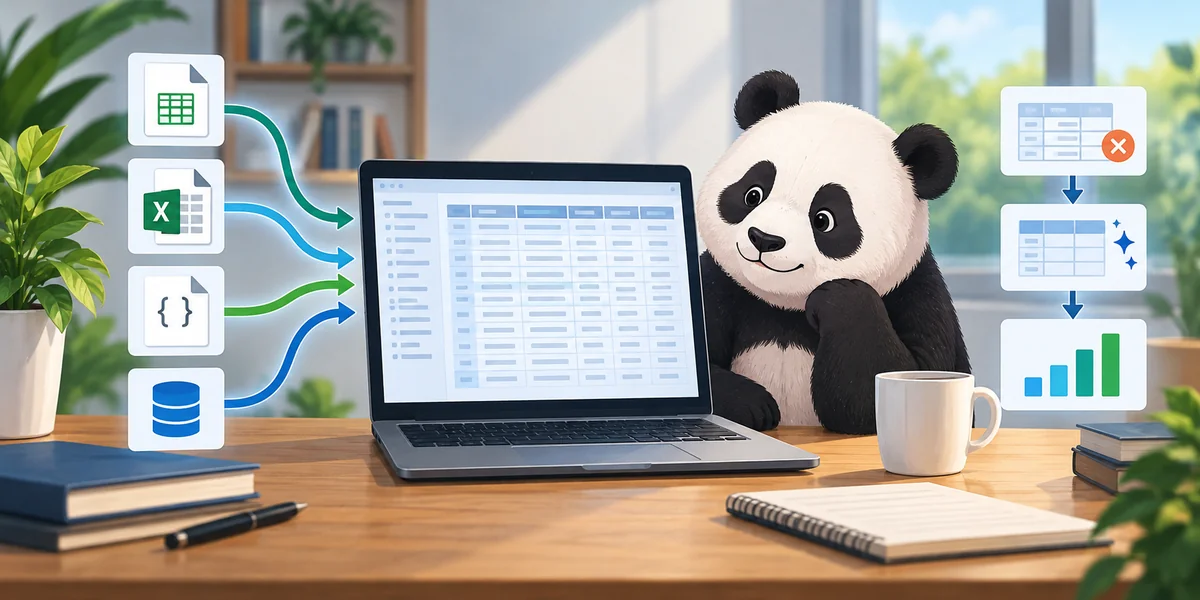
Una de las mayores ventajas de Pandas es su capacidad para procesar grandes conjuntos de datos con facilidad. A diferencia de Excel, que tiene dificultades con grandes cantidades de datos, Pandas puede manejar millones de filas sin problemas de rendimiento. Esto lo convierte en una opción ideal para industrias que manejan conjuntos de datos masivos, como finanzas, salud y comercio electrónico.
Pandas también simplifica la limpieza de datos, un paso crucial en el análisis de datos. Los conjuntos de datos rara vez son perfectos, a menudo contienen valores faltantes, duplicados o inconsistencias. Pandas proporciona funciones poderosas para limpiar y preparar datos, asegurando que los analistas trabajen con información precisa y bien estructurada.
Otra razón para la adopción generalizada de Pandas es su compatibilidad con los flujos de trabajo de aprendizaje automático e inteligencia artificial. La mayoría de los modelos de aprendizaje automático requieren datos estructurados como entrada, y Pandas facilita la preparación y el formato de los datos en consecuencia. Se integra bien con bibliotecas populares como Scikit-learn, TensorFlow y PyTorch, convirtiéndolo en una herramienta esencial en el pipeline de aprendizaje automático.
Más allá del análisis, Pandas permite a los usuarios exportar sus datos procesados en varios formatos. Ya sea guardando datos como un archivo CSV, escribiéndolos en una base de datos o convirtiéndolos en formato JSON, Pandas proporciona comandos simples para asegurar que los datos se almacenen y compartan de manera eficiente.
Conclusión
Pandas en Python es una herramienta indispensable para el análisis de datos, simplificando la manipulación de datos con sus estructuras potentes pero fáciles de usar. Su capacidad para manejar grandes conjuntos de datos, limpiar datos de manera eficiente e integrarse con otras bibliotecas lo hace esencial para analistas, desarrolladores e investigadores. Ya sea realizando transformaciones simples u operaciones estadísticas complejas, Pandas optimiza los flujos de trabajo y mejora la productividad. A medida que la toma de decisiones basada en datos se vuelve cada vez más vital, dominar Pandas equipa a los usuarios con las habilidades para gestionar, procesar y analizar datos sin esfuerzo en Python.
Artículos relacionados

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
Selenium Python: Una Guía para Automatizar Tareas Web Eficientemente
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles

11 Libros Que Todo Científico de Datos Debe Leer en 2025
IA Generativa para Científicos de Datos en 2025: Más Allá de la Generación de Texto
Python para Análisis de Series Temporales: Calculando Promedios Móviles Fácilmente

Velocidad y Sintaxis en MATLAB vs. Python: ¿Cuál Lenguaje Reinará Supremo?
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos
Una Guía para Bloquear Celdas en Excel Fácilmente y Proteger tus Datos Efectivamente
6 Robots Enfermeros con IA que Están Transformando el Cuidado de la Salud
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Medir la Adopción e Impacto de la IA
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
