
Tidyverse para Principiantes: Desbloqueando el Potencial de Ciencia de Datos de R
En esta página
La ciencia de datos ha ganado popularidad, y R se ha convertido en un lenguaje preferido para analistas, estadísticos e investigadores. Aunque R base es innegablemente poderoso, puede resultar tedioso al manejar grandes conjuntos de datos o realizar tareas repetitivas. Aquí es donde Tidyverse brilla: una colección de paquetes de R diseñada para hacer la manipulación, visualización y análisis de datos más fluida e intuitiva.
Tidyverse ofrece una forma unificada y consistente de trabajar con datos, convirtiéndolo en la opción preferida para la mayoría de los profesionales. Ya sea que desees limpiar conjuntos de datos desordenados, crear visualizaciones inteligentes o automatizar transformaciones de datos, Tidyverse simplifica estos procesos para que puedas concentrarte más en los insights que en la sintaxis.
¿Qué es Tidyverse?
Tidyverse no es solo un paquete, sino una colección de paquetes de R que comparten una filosofía similar en la estructuración y análisis de datos. Fundamentalmente, Tidyverse se basa en el principio de "datos ordenados", donde una observación se representa por fila y una variable por columna. Esta naturaleza organizada de los datos facilita su manejo y reduce la complejidad que típicamente se encuentra en los datos en bruto.
El entorno viene con paquetes esenciales como dplyr, ggplot2, tidyr, readr, purrr y tibble, todos los cuales apuntan a procesar diferentes aspectos del flujo de trabajo de la ciencia de datos. Dplyr facilita operaciones como filtrado, ordenamiento y transformación de datos, haciéndolas más comprensibles y eficientes. ggplot2 es otro paquete de visualización comúnmente usado que permite a los usuarios crear gráficos impresionantes y perspicaces con menos esfuerzo. Estos paquetes trabajan juntos sin problemas, ofreciendo un flujo de trabajo fluido desde la importación de datos hasta el análisis final.
Uno de los aspectos más importantes de Tidyverse es su aplicación del operador pipe (%>%). Esto permite a los usuarios encadenar varias operaciones en un orden conciso y legible, minimizando el uso de demasiadas variables intermedias y funciones anidadas. Al integrar Tidyverse en su flujo de trabajo, los científicos de datos pueden mejorar significativamente la productividad y la legibilidad del código.
Paquetes Clave en Tidyverse
Tidyverse incluye varios paquetes, cada uno adaptado a un aspecto específico de la ciencia de datos. Comprender cómo estos paquetes trabajan juntos proporciona una base sólida para cualquiera que busque optimizar su flujo de trabajo en R.
dplyr: Manipulación de Datos Simplificada
dplyr es uno de los paquetes más utilizados en Tidyverse para la manipulación de datos. Proporciona funciones como filter(), select(), mutate(), arrange() y summarize() que permiten a los usuarios modificar y analizar conjuntos de datos de manera eficiente. En lugar de escribir código complejo en R base, dplyr facilita la ejecución de operaciones con una sintaxis clara y legible.
ggplot2: Visualización de Datos Poderosa
ggplot2 es el paquete de referencia para la visualización de datos en R. Basado en la Gramática de los Gráficos, permite a los usuarios crear gráficos altamente personalizables y estéticamente agradables. Ya sean gráficos de dispersión, gráficos de barras o líneas, ggplot2 proporciona un enfoque estructurado para la visualización que facilita la representación de datos de manera significativa.
tidyr: Reorganización y Limpieza de Datos
tidyr ayuda a ordenar conjuntos de datos desordenados reestructurándolos en un formato más limpio. Funciones como gather() y spread() permiten a los usuarios transformar conjuntos de datos de formato ancho a largo y viceversa, haciéndolos más adecuados para el análisis.
readr: Importación Eficiente de Datos
readr está diseñado para leer datos tabulares en R de manera rápida y eficiente. Proporciona funciones como read_csv() y read_tsv(), que son mucho más rápidas y fáciles de usar en comparación con las funciones de importación de datos de R base.
purrr: Programación Funcional en R
purrr mejora la funcionalidad de R al simplificar las tareas de programación funcional. Proporciona herramientas para la iteración, permitiendo a los usuarios aplicar funciones a múltiples elementos de un conjunto de datos sin necesidad de bucles complejos.
tibble: Marcos de Datos Mejorados
tibble es una versión mejorada del marco de datos tradicional de R, diseñada para proporcionar una salida más limpia e informativa. A diferencia de los marcos de datos de R base, los tibbles imprimen automáticamente solo un número limitado de filas y columnas, facilitando su manejo, especialmente para grandes conjuntos de datos.
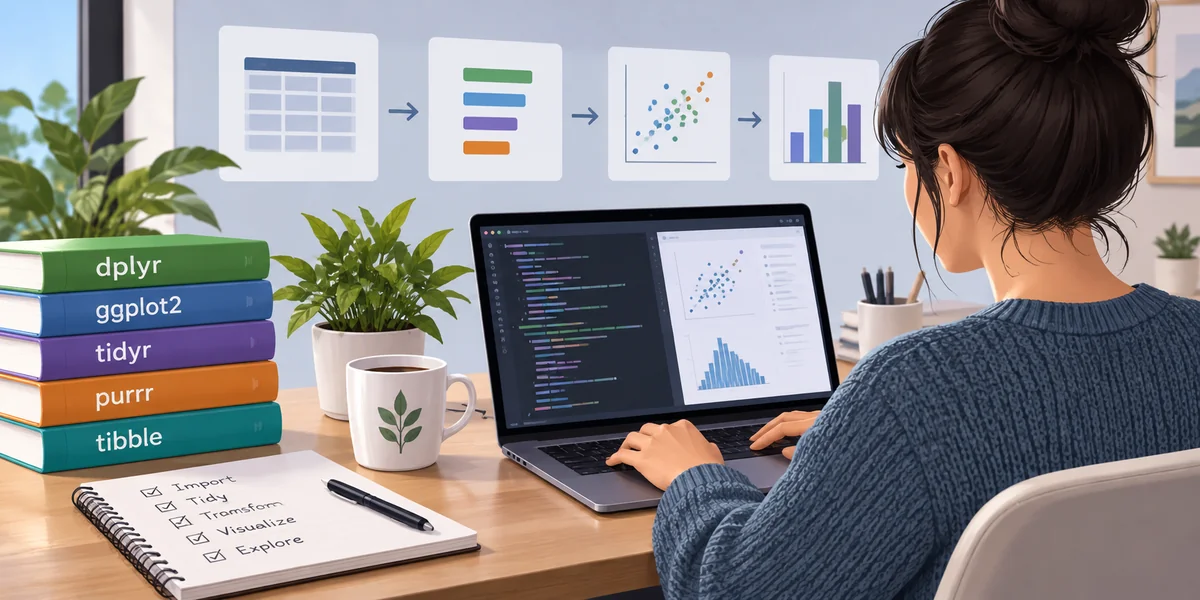
Estos paquetes forman colectivamente la columna vertebral de Tidyverse, ofreciendo una manera estructurada y eficiente de gestionar y analizar datos en R.
¿Por Qué Usar Tidyverse para la Ciencia de Datos?
La principal ventaja de Tidyverse es su capacidad para simplificar la manipulación y visualización de datos al tiempo que mantiene la consistencia entre diferentes paquetes. Las funciones tradicionales de R a veces pueden ser inconsistentes en su sintaxis, requiriendo que los usuarios recuerden diferentes maneras de realizar operaciones similares. Tidyverse resuelve este problema proporcionando un enfoque unificado para la ciencia de datos, haciéndolo más fácil tanto para principiantes como para usuarios experimentados trabajar con datos de manera efectiva.
Uno de los mayores beneficios de Tidyverse es su legibilidad. El código escrito usando Tidyverse es a menudo más conciso e intuitivo en comparación con R base, reduciendo la carga cognitiva para analistas y científicos de datos. Esto facilita la compartición de código y la colaboración con otros, ya que la sintaxis de Tidyverse está diseñada para ser autoexplicativa.
Otra ventaja clave es su eficiencia. Muchas funciones en Tidyverse están optimizadas para el rendimiento, permitiendo a los usuarios manejar grandes conjuntos de datos con facilidad. dplyr, por ejemplo, está diseñado para trabajar sin problemas con bases de datos y grandes marcos de datos, permitiendo una manipulación de datos rápida y eficiente.
Además, Tidyverse se mantiene activamente y es ampliamente utilizado en la comunidad de ciencia de datos. Sus paquetes reciben actualizaciones regulares, asegurando la compatibilidad con los últimos desarrollos en R. Esto hace que Tidyverse sea una opción confiable para proyectos de ciencia de datos a largo plazo.
Aprender Tidyverse es una inversión valiosa para cualquiera que busque mejorar sus habilidades de análisis de datos en R. Proporciona un conjunto de herramientas poderoso y flexible que puede ser utilizado en diversos dominios, desde finanzas y salud hasta ciencias sociales y análisis empresarial.
Conclusión
Tidyverse ha transformado la ciencia de datos en R, ofreciendo una manera estructurada y eficiente de manejar datos. Paquetes como dplyr para la manipulación y ggplot2 para la visualización simplifican tareas complejas y mejoran el flujo de trabajo. Su sintaxis consistente y legibilidad lo hacen ideal tanto para principiantes como para usuarios experimentados. Ya sea limpiando datos, creando gráficos o resumiendo insights, Tidyverse agiliza el proceso. Para cualquiera que trabaje con datos en R, dominar Tidyverse proporciona un conjunto de herramientas poderoso e intuitivo para el análisis y la visualización.
Artículos relacionados

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles
Aprendizaje Federado: Entrena Modelos de IA Manteniendo la Privacidad de los Datos
El Impacto de los Datos Masivos en la Inteligencia Artificial y su Rol
IA Generativa para Científicos de Datos en 2025: Más Allá de la Generación de Texto
Herramientas de Análisis de Datos Potenciadas por IA
¿Cómo se Entrenan las Herramientas de IA?

Velocidad y Sintaxis en MATLAB vs. Python: ¿Cuál Lenguaje Reinará Supremo?
Por Qué No Tienes Tantos Datos Como Crees. Y 3 Formas de Solucionarlo
Construyendo Mejores Modelos: La Batalla Entre el Sobreajuste y el Subajuste
Una Guía sobre Redes Neuronales Recurrentes (RNNs) para Datos Secuenciales
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
