
Aprendizaje Federado: Entrena Modelos de IA Manteniendo la Privacidad de los Datos
En esta página
La protección de datos es una preocupación significativa a medida que la tecnología de inteligencia artificial (IA) evoluciona rápidamente. Tradicionalmente, los modelos de IA requerían grandes cantidades de datos, a menudo incluyendo información privada o confidencial, como detalles personales o datos empresariales. Esta dependencia de los datos plantea problemas de privacidad sustanciales, especialmente cuando la información se almacena o se transmite entre dispositivos.
El aprendizaje federado ofrece una solución revolucionaria a estos desafíos al permitir que los modelos de IA se entrenen sin compartir datos crudos, salvaguardando así la privacidad y la seguridad. Este artículo explora cómo funciona el aprendizaje federado, sus beneficios y su impacto transformador en el desarrollo de IA en un mundo cada vez más consciente de la privacidad.
¿Qué es el Aprendizaje Federado?
El aprendizaje federado permite que los modelos de IA se entrenen directamente en dispositivos descentralizados, como teléfonos inteligentes, computadoras o dispositivos de Internet de las Cosas (IoT), en lugar de en plataformas centralizadas. Este enfoque asegura que la información privada permanezca en el dispositivo original y solo las actualizaciones del modelo se compartan con un servidor central para su agregación.
En términos simples, el aprendizaje federado mantiene los datos privados, compartiendo solo los conocimientos adquiridos para mejorar el modelo. Por ejemplo, cuando un modelo de IA se entrena en teléfonos inteligentes, los datos generados por el usuario (como patrones de uso de aplicaciones o datos de ubicación) permanecen en el dispositivo. El modelo en cada dispositivo se actualiza individualmente, y solo las actualizaciones del modelo se envían a un servidor central, asegurando la seguridad de los datos personales.
¿Cómo Funciona el Aprendizaje Federado?
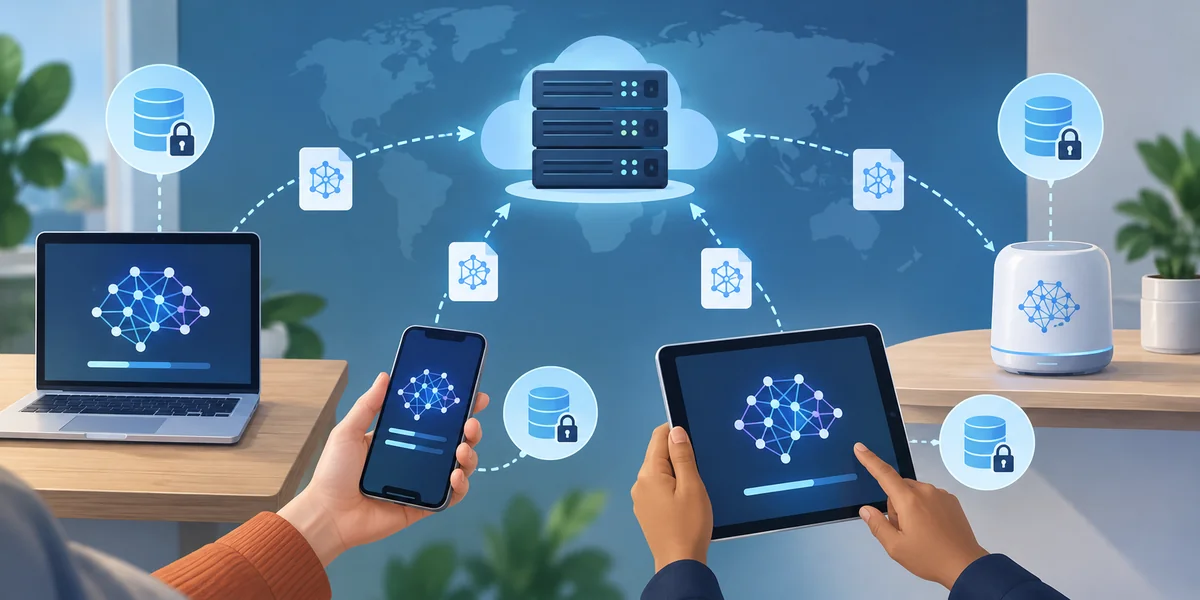
En los modelos tradicionales de aprendizaje automático, los datos crudos de numerosos usuarios o dispositivos se envían a un servidor central para su procesamiento y entrenamiento del modelo. El aprendizaje federado invierte este modelo. Aquí hay un proceso paso a paso de cómo funciona:
- Entrenamiento del Modelo Local: El modelo de IA se inicializa primero y se distribuye a una red de dispositivos descentralizados. Cada dispositivo (teléfono inteligente, computadora o dispositivo IoT) utiliza sus datos locales para entrenar el modelo.
- Actualizaciones del Modelo, No Datos: En lugar de enviar datos crudos de vuelta al servidor central, cada dispositivo envía actualizaciones (como parámetros o pesos del modelo) que reflejan lo que ha aprendido de sus datos locales.
- Agregación en el Servidor: El servidor central agrega actualizaciones de todos los dispositivos, combinándolas en un modelo global. Este modelo agregado se comparte luego de nuevo a los dispositivos para un mayor entrenamiento, continuando el ciclo.
- Sin Movimiento de Datos: La innovación clave es que los datos crudos nunca salen de su ubicación original. Solo se comparten los parámetros del modelo, asegurando que los datos sensibles permanezcan seguros.
Ventajas del Aprendizaje Federado
- Preservación de la Privacidad: El aprendizaje federado asegura la privacidad ya que los datos crudos nunca se comparten ni se suben a servidores centrales. Esto es crucial en sectores como la salud, las finanzas y las redes sociales, donde los datos procesados pueden ser altamente sensibles.
- Cumplimiento de Regulaciones: El aprendizaje federado ayuda a las organizaciones a cumplir con las regulaciones globales de protección de datos como GDPR y HIPAA, reduciendo el riesgo de violaciones de las leyes de privacidad al mantener los datos locales.
- Reducción de Costos de Ancho de Banda y Almacenamiento: Al minimizar las transferencias de datos a gran escala, el aprendizaje federado ahorra costos de ancho de banda y almacenamiento. Solo se envían al servidor pequeñas actualizaciones del modelo, lo que lo convierte en un método de entrenamiento de IA rentable y eficiente.
- Personalización Sin Compartir Datos: El aprendizaje federado permite que los modelos de IA se personalicen para los usuarios sin requerir el intercambio de datos. Por ejemplo, una aplicación de teléfono inteligente podría aprender a predecir las preferencias del usuario sin enviar datos a la nube, ofreciendo una experiencia personalizada sin comprometer la privacidad.
Casos de Uso del Aprendizaje Federado
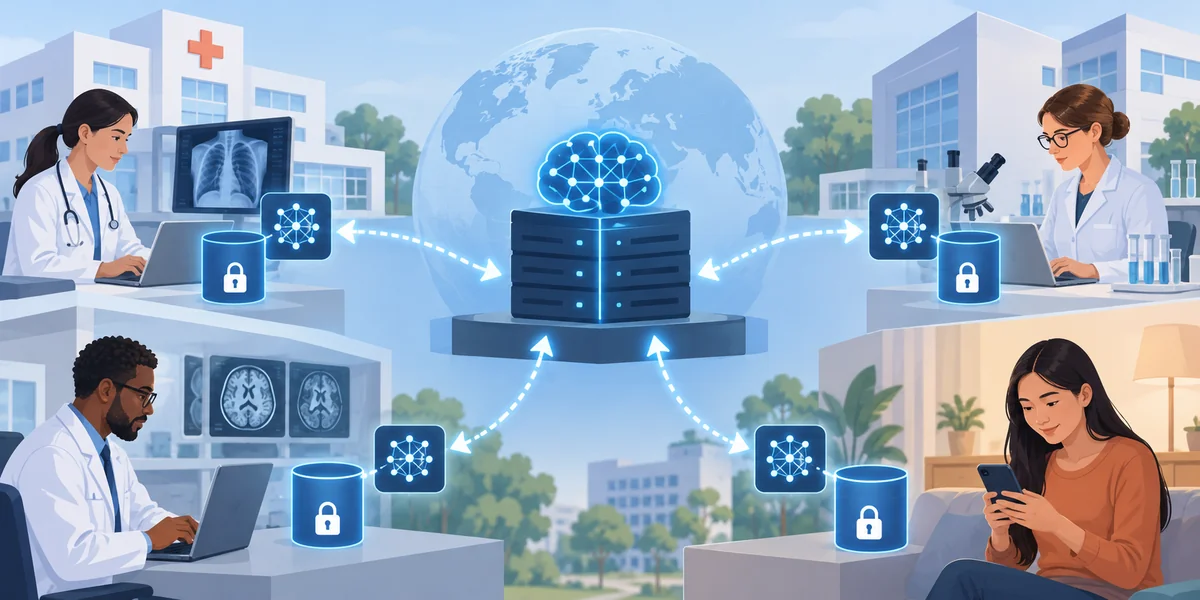
- Salud: El aprendizaje federado es altamente beneficioso en el ámbito de la salud, donde las estrictas leyes de privacidad protegen los datos de los pacientes. Los hospitales e instituciones de investigación pueden colaborar para entrenar modelos de IA que predigan enfermedades, analicen imágenes médicas o personalicen planes de tratamiento mientras mantienen los datos de los pacientes privados y locales.
Por ejemplo, varios hospitales podrían usar el aprendizaje federado para entrenar un modelo de IA para la detección de cáncer en imágenes médicas. En lugar de compartir imágenes de pacientes, cada hospital entrena su modelo y solo comparte actualizaciones, resultando en una mejor IA sin comprometer la confidencialidad del paciente.
- Teléfonos Inteligentes y Dispositivos Personales: El aprendizaje federado se utiliza ampliamente en teléfonos inteligentes. Por ejemplo, el Gboard de Google utiliza el aprendizaje federado para la predicción de texto. El teclado aprende de los patrones de escritura para predecir la siguiente palabra, pero los datos reales de escritura nunca se comparten. Solo se intercambian actualizaciones del modelo, permitiendo que el sistema mejore mientras respeta la privacidad del usuario.
Desafíos del Aprendizaje Federado
- Diversidad de Dispositivos: La diversidad de dispositivos en el aprendizaje federado plantea un desafío. Los diferentes dispositivos tienen capacidades computacionales variables, lo que impacta la eficiencia del entrenamiento del modelo. Mientras que dispositivos potentes como los servidores pueden manejar entrenamiento a gran escala, los dispositivos móviles podrían ser más lentos o tener recursos limitados, reduciendo la eficiencia.
- Precisión del Modelo y Convergencia: El aprendizaje federado puede llevar a una convergencia más lenta del modelo o a modelos menos precisos. Dado que los datos en cada dispositivo no son idénticos, los modelos locales pueden divergir, causando inconsistencias. Se necesitan estrategias cuidadosas para asegurar que el modelo global siga siendo efectivo y preciso.
Conclusión
El aprendizaje federado es un enfoque innovador que permite el entrenamiento de modelos de IA sin que los datos salgan de su entorno local. Al mantener los datos crudos privados y compartir solo actualizaciones del modelo, proporciona una solución segura y que preserva la privacidad aplicable en diversas industrias, desde la salud hasta las finanzas. Aunque existen desafíos como la heterogeneidad de dispositivos y la sobrecarga de comunicación, el aprendizaje federado tiene un gran potencial para el futuro de la IA.
Artículos relacionados
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas

11 Libros Que Todo Científico de Datos Debe Leer en 2025
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Construyendo Mejores Modelos: La Batalla Entre el Sobreajuste y el Subajuste
Por qué el Deep Learning Puede No Ser la Solución Adecuada para Su Negocio
Explorando Cómo la IA Está Transformando el Trabajo de los Equipos Financieros Modernos
Aprende a Escribir y Leer Consultas SQL Fácilmente y con Confianza
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
Búsqueda en Haz Explicada: Decodificación NLP Más Inteligente para un Mejor Resultado de Texto
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
