
Dominando 7 Algoritmos Esenciales para Estructuras de Datos en Python
En esta página
Entender cómo combinar estructuras de datos y algoritmos es esencial para la programación. No basta con simplemente almacenar o acceder a la información; necesitas hacerlo de manera eficiente. Python ofrece numerosas estructuras de datos integradas, convirtiéndolo en uno de los lenguajes más amigables para los desarrolladores. El verdadero potencial se realiza cuando los algoritmos mejoran estos sistemas, haciéndolos mejores, más rápidos y más prácticos.
Esta guía explora los 7 algoritmos principales que debes conocer al trabajar con estructuras de datos en Python. Estos algoritmos no son solo conceptos teóricos; son técnicas fundamentales que pueden hacer que tu código sea significativamente más optimizado y mantenible.
¿Por Qué Son Importantes los Algoritmos para las Estructuras de Datos en Python?
Antes de sumergirnos en la lista, comprendamos rápidamente por qué estos algoritmos son cruciales:
- Uso eficiente de la memoria y el tiempo: Los buenos algoritmos reducen la complejidad temporal (cuánto tarda un proceso) y la complejidad espacial (cuánta memoria utiliza).
- Mejor rendimiento con conjuntos de datos grandes: Las estructuras de datos por sí solas no pueden acelerar las operaciones. Necesitas un algoritmo que pueda manejar el crecimiento sin ralentizarse.
- Soporte para aplicaciones escalables: A medida que tu aplicación crece, operaciones como ordenar, buscar u organizar se vuelven más costosas. Los algoritmos evitan que ese costo se convierta en un cuello de botella.
Los 7 Mejores Algoritmos que Todo Desarrollador de Python Debería Conocer
Dominar los algoritmos básicos puede mejorar drásticamente cómo trabajas con estructuras de datos en Python. Estos algoritmos ofrecen técnicas prácticas para ordenar, buscar, recorrer y gestionar datos de manera más eficaz. A continuación, se presentan los algoritmos esenciales que debes dominar para escribir un código Python más limpio, rápido y optimizado.
1. Búsqueda Binaria
La búsqueda binaria es uno de los algoritmos más rápidos para buscar en datos ordenados. En lugar de verificar cada elemento uno por uno, elimina la mitad del conjunto de datos en cada paso.
Cómo Funciona:
- Comienza en el medio de la lista.
- Si el elemento medio es igual a tu objetivo, terminas.
- Si es mayor, busca en la mitad izquierda.
- Si es menor, busca en la mitad derecha.
- Repite hasta encontrarlo o quedarte sin elementos.
Por Qué Es Útil:
Ideal cuando tienes una lista ordenada y deseas buscar en tiempo logarítmico en lugar de lineal.
2. Merge Sort
Merge sort utiliza un enfoque de dividir y conquistar. Divide tus datos en mitades hasta que cada segmento tenga un elemento. Luego, fusiona esas piezas de nuevo en orden.
Cómo Funciona:
- Divide el array en dos mitades.
- Ordena recursivamente ambas mitades.
- Fusiona las mitades ordenadas comparando sus elementos.
Por Qué Es Útil:
Merge sort mantiene un rendimiento constante con una complejidad temporal de O(n log n). También preserva el orden de los elementos iguales, lo que se llama estabilidad, una característica necesaria en muchas tareas de ordenación.
3. Quick Sort
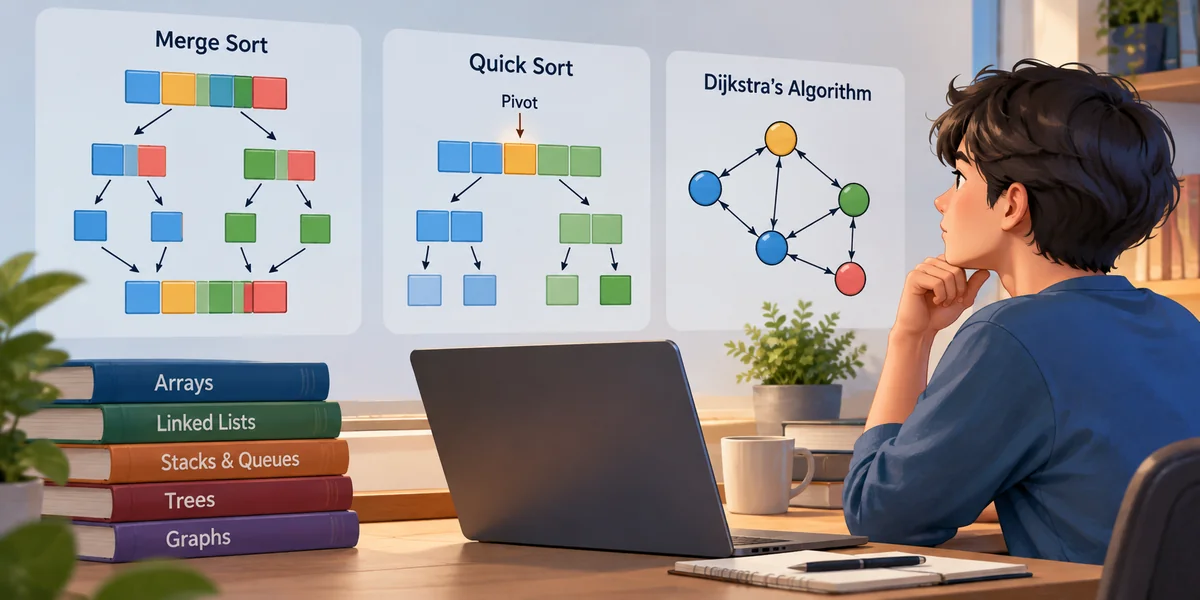
Quick sort es otro algoritmo de dividir y conquistar, pero en lugar de fusionar más tarde, realiza el trabajo pesado inicialmente al dividir la lista en función de un pivote.
Cómo Funciona:
- Elige un elemento pivote.
- Divide la lista en dos partes: elementos menores y mayores que el pivote.
- Ordena recursivamente ambos lados.
- Combina los resultados.
Por Qué Es Útil:
Generalmente, funciona más rápido que el merge sort en la práctica, aunque su rendimiento en el peor de los casos es más lento. Ideal cuando necesitas ordenar in situ.
4. Algoritmo de Dijkstra
El algoritmo de Dijkstra encuentra el camino más corto entre dos puntos en un grafo, suponiendo que todos los caminos tienen pesos no negativos.
Cómo Funciona:
- Asigna una distancia tentativa a cada nodo (comienza con 0 para la fuente, infinito para el resto).
- Visita el nodo con la distancia tentativa más corta.
- Actualiza las distancias a sus vecinos.
- Repite hasta que todos los nodos estén visitados o se alcance el destino.
Por Qué Es Útil:
Es fundamental en escenarios que involucran recorrido de grafos, especialmente para encontrar caminos optimizados entre nodos.
5. Búsqueda en Anchura (BFS)
Este es un algoritmo de recorrido por niveles, lo que significa que revisa todos los nodos de un nivel antes de pasar al siguiente.
Cómo Funciona:
- Utiliza una cola para llevar un registro de qué nodo visitar a continuación.
- Comienza en la raíz o en cualquier nodo inicial.
- Visita cada uno de sus vecinos antes de pasar a los vecinos de los vecinos.
- Continúa hasta que todos los nodos estén visitados.
Por Qué Es Útil:
Garantiza el camino más corto en un grafo no ponderado y es ideal para recorrer estructuras capa por capa.
6. Búsqueda en Profundidad (DFS)
DFS profundiza lo más posible en una rama antes de retroceder y probar otra. A diferencia de BFS, que utiliza una cola, DFS generalmente utiliza una pila o recursión.
Cómo Funciona:
- Comienza desde un nodo.
- Visita el primer vecino, luego el vecino del vecino, y así sucesivamente.
- Si llegas a un nodo sin vecinos no visitados, retrocede.
- Continúa hasta que todos los nodos estén visitados.
Por Qué Es Útil:
DFS es más eficiente en memoria que BFS para grafos con ramas largas y es útil en tareas como la detección de ciclos o la exploración de conectividad.
7. Hashing
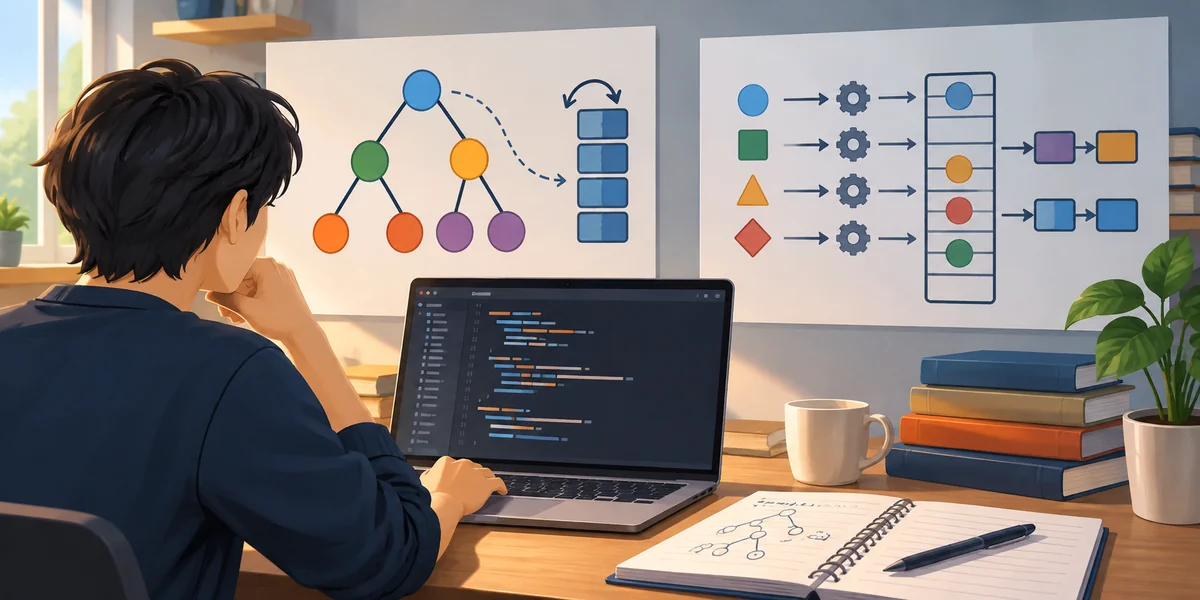
Hashing consiste en mapear datos a un array de tamaño fijo utilizando una función llamada función de hash. Es la columna vertebral de los tipos diccionario y conjunto integrados en Python.
Cómo Funciona:
- Una función de hash convierte claves en un índice.
- Los datos se almacenan en ese índice en una estructura similar a un array.
- Las colisiones (múltiples claves mapeadas al mismo índice) se manejan usando métodos como encadenamiento o sondeo lineal.
Por Qué Es Útil:
Ofrece una complejidad temporal promedio constante para inserciones, eliminaciones y búsquedas. Por eso los diccionarios en Python son tan rápidos.
Cómo Elegir el Algoritmo Correcto
Elegir el algoritmo correcto depende de:
- El tamaño de tus datos: Algunos algoritmos funcionan mejor con menos elementos.
- Las operaciones requeridas: ¿Necesitas búsquedas rápidas? Usa búsqueda binaria. ¿Necesitas inserciones y eliminaciones rápidas? Elige hashing.
- La estructura de tus datos: ¿Árbol? ¿Grafo? ¿Lista lineal? Algunos algoritmos están diseñados específicamente para ciertas estructuras.
Conclusión
Los algoritmos son los motores ocultos que impulsan el rendimiento de tus programas en Python. Cuando se usan con las estructuras de datos correctas, pueden mejorar significativamente cómo se comporta tu código en términos de velocidad, memoria y escalabilidad.
Al aprender estos 7 algoritmos clave, estás construyendo una base sólida en el diseño de estructuras de datos y algoritmos. Sigue practicando, ajusta y prueba variaciones, y lo más importante: comprende la lógica detrás de cada uno. Así es como pasas de escribir código en Python a dominarlo.
Artículos relacionados
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
Biblioteca Pandas de Python: Una Guía Completa para el Análisis de Datos
Pandas en Python: La Clave para una Manipulación de Datos Sin Esfuerzo

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas

11 Libros Que Todo Científico de Datos Debe Leer en 2025

¿Qué es la depuración de datos y por qué es importante para conjuntos de datos limpios?

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
Cómo la IA está transformando las estrategias y procesos de marketing en 2025
Construye tu Primera Extensión de Python para VS Code en 7 Sencillos Pasos
Selenium Python: Una Guía para Automatizar Tareas Web Eficientemente
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles

Guía para Principiantes para Elegir el Framework de Python Adecuado para tus Necesidades
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
