
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
En esta página
Los proyectos de ciencia de datos y aprendizaje automático dependen críticamente de la limpieza de datos, que implica transformar datos en bruto en un formato limpio y utilizable para el análisis. Automatizar la limpieza de datos puede mejorar significativamente la eficiencia, ahorrar tiempo y reducir errores. Python, junto con la poderosa biblioteca Pandas, simplifica el desarrollo de tuberías automatizadas de limpieza de datos.
Este artículo explorará los métodos para crear estas tuberías, la importancia de la limpieza de datos y las herramientas esenciales de Python y Pandas que facilitan la automatización. Ya sea que tu tarea implique conjuntos de datos grandes o pequeños, automatizar la limpieza de datos garantiza consistencia y precisión. Al final de esta guía, tendrás una sólida base para configurar tuberías automatizadas de limpieza de datos con Python y Pandas.
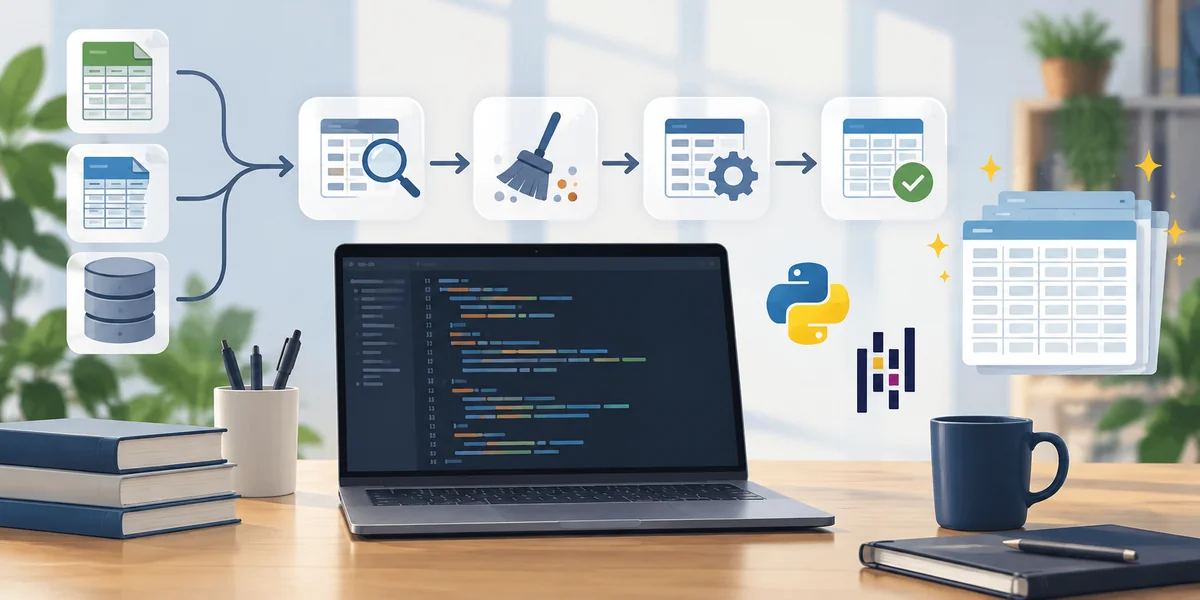
Pasos para Crear una Tubería Automatizada de Limpieza de Datos con Python y Pandas
Crear una tubería automatizada de limpieza de datos involucra varios pasos. Comienza cargando datos desde CSV, Excel o bases de datos usando Pandas. Una vez cargados, examina los datos en busca de problemas como valores faltantes y duplicados. Maneja los valores faltantes imputándolos o eliminándolos. Las herramientas de Pandas te permiten identificar y filtrar duplicados. Eliminar valores atípicos asegura que los valores extremos no distorsionen el análisis. Convierte tipos de datos para garantizar la consistencia de las columnas.
Estandariza formatos, incluyendo variables categóricas y sistemas de fecha y hora. Normaliza valores numéricos y codifica datos categóricos según sea necesario. Guarda los datos limpios para uso posterior. Desarrolla scripts en Python para automatizar estos procesos y programa su frecuencia de ejecución. Una tubería automatizada de limpieza de datos mejora la precisión, reduce el trabajo manual y aumenta la eficiencia.
Gestionando Datos Faltantes en Tuberías de Limpieza de Datos
Los datos faltantes son un problema común en los conjuntos de datos, a menudo causados por corrupción de datos, errores del sistema o entrada de datos insuficiente. Abordar los datos faltantes es crucial para mantener la integridad de los datos. Pandas ofrece varias soluciones rápidas para manejar valores faltantes. La función fillna() te permite reemplazar valores faltantes con un valor medio o mediano especificado. La función dropna() elimina filas o columnas con valores faltantes. Métodos más avanzados, como la interpolación, estiman valores faltantes usando datos existentes.
Al automatizar la limpieza de datos, define reglas para manejar datos faltantes basadas en requisitos empresariales. Los valores faltantes pueden impactar modelos de aprendizaje automático y cálculos estadísticos. Un enfoque consistente asegura la calidad de los datos. Automatizar este proceso previene inconsistencias en los conjuntos de datos. Técnicas predefinidas permiten un control efectivo de los datos faltantes sin intervención manual, asegurando que tus datos permanezcan viables para análisis futuros.
Eliminando Duplicados e Identificando Valores Atípicos
Las entradas duplicadas pueden distorsionar la investigación y llevar a resultados inexactos. La fusión de conjuntos de datos o errores del sistema a menudo causan duplicados. Eliminar duplicados es un paso crucial en la limpieza de datos. Pandas proporciona la función drop_duplicates() para eliminar registros redundantes. Los valores atípicos, o valores extremos, pueden afectar el análisis predictivo y los modelos estadísticos. Métodos estadísticos como el rango intercuartílico (IQR) y el puntaje Z ayudan a identificar anomalías.
Los diagramas de caja te permiten visualizar datos e identificar valores extremos. Eliminar o ajustar valores atípicos asegura hallazgos precisos. Los criterios de automatización ayudan a identificar y gestionar anomalías, mejorando la consistencia de los datos y previniendo distorsiones. Establecer scripts automatizados para detectar duplicados y anomalías mejora la productividad, asegurando que los datos permanezcan confiables y valiosos. El manejo adecuado de valores atípicos y duplicados aumenta la fiabilidad y calidad de los datos.
Convirtiendo Tipos de Datos y Estandarizando Formatos
Tipos de datos inconsistentes pueden llevar a errores de análisis. Los conjuntos de datos en bruto a menudo contienen formatos incorrectos, como números almacenados como cadenas. La conversión de tipos de datos asegura uniformidad en los conjuntos de datos. Pandas proporciona el método astype() para la conversión de tipos. La función to_datetime() ayuda a estandarizar formatos de fecha. La estandarización de texto asegura consistencia en los datos categóricos, y convertir todos los valores de texto a minúsculas elimina discrepancias sensibles a mayúsculas.
Eliminar caracteres especiales de campos de texto mejora la uniformidad de los datos. La automatización asegura la aplicación consistente de estas conversiones en múltiples conjuntos de datos. Los errores de formato pueden afectar modelos de aprendizaje automático. La estandarización mantiene un conjunto de datos organizado y fácil de leer. Este paso asegura un procesamiento de datos fluido y efectivo sin errores. La conversión automatizada de tipos de datos ayuda a prevenir problemas inesperados durante el análisis, manteniendo los datos limpios y listos para su uso posterior.
Automatizando Tuberías de Limpieza de Datos Usando Scripts de Python
La automatización en la limpieza de datos elimina la necesidad de tareas manuales y repetitivas. Escribir scripts en Python permite un procesamiento de datos rápido y consistente. Comienza importando las bibliotecas necesarias, como Pandas y NumPy. Carga el conjunto de datos en un DataFrame de Pandas para su procesamiento. Define métodos para manejar valores faltantes, eliminar duplicados y convertir tipos de datos. Aplica cambios en todos los registros usando bucles y condicionales. Las tareas programadas regularmente limpian automáticamente los datos.
Los scripts pueden ejecutarse automáticamente usando trabajos cron de Linux o el Programador de Tareas de Windows. Sistemas basados en la nube como AWS Lambda pueden lograr la automatización remota de las tuberías de limpieza. Los sistemas de registro de errores aseguran la integridad de los datos. Automatizar estas tareas minimiza los errores humanos y aumenta la productividad. Una tubería organizada asegura la precisión y actualidad de los datos. Automatizar la limpieza de datos permite a las empresas enfocarse en el análisis en lugar de la preparación de datos.
Probando y Optimizando Tu Tubería de Limpieza de Datos
Probar es crucial para asegurar el funcionamiento adecuado de los sistemas de limpieza de datos. Ejecuta la tubería en datos de muestra para verificar los resultados. Compara los datos limpios con los datos en bruto para identificar errores. Depurar scripts ayuda a resolver discrepancias antes de la implementación completa. Optimizar tuberías asegura un manejo eficiente de grandes volúmenes de datos. Las operaciones vectorizadas de Pandas mejoran la eficiencia, y minimizar cálculos innecesarios ahorra tiempo de procesamiento.
Los métodos de procesamiento paralelo manejan eficazmente datos a gran escala. Eliminar columnas adicionales y filtrar datos temprano acelera el procesamiento. Monitorear el rendimiento y registrar errores asegura un funcionamiento fluido. Las pruebas de rendimiento identifican cuellos de botella en el procesamiento de datos. Las tuberías mejoradas reducen el tiempo necesario para la limpieza de datos. Probar y refinar scripts automatizados mejora la exactitud y eficiencia. Las tuberías confiables previenen inconsistencias de datos. La optimización continua mantiene las tuberías automatizadas escalables y eficientes, asegurando datos de alta calidad para futuros proyectos de investigación.
Conclusión:
Construir procedimientos automatizados de limpieza de datos con Python y Pandas es crucial para un análisis de datos efectivo. Automatizar tareas repetitivas, como procesar datos faltantes, eliminar duplicados y estandarizar formatos, asegura que los datos permanezcan precisos y consistentes. Las robustas bibliotecas de Python permiten una integración fluida de las actividades de limpieza de datos en un flujo de trabajo automatizado. Ya sea trabajando con conjuntos de datos pequeños o grandes, la automatización ahorra tiempo y reduce errores, simplificando la preparación de datos. Utilizar tuberías automatizadas de limpieza de datos es un enfoque estratégico para agilizar los procesos de datos y mejorar tus capacidades analíticas.
Artículos relacionados
Biblioteca Pandas de Python: Una Guía Completa para el Análisis de Datos
3 Historias Inspiradoras de Líderes en IA
Pandas en Python: La Clave para una Manipulación de Datos Sin Esfuerzo
Selenium Python: Una Guía para Automatizar Tareas Web Eficientemente
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
5 Pasos para Aprender IA Gratis en 2025
Proyectos de IA Avanzados pero Simples, Perfectos para Principiantes
Cómo la IA está Transformando la Industria Minorista
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos
Podcasts de IA que Debes Seguir en 2025
Cómo Destacar y Proteger tu Empleo en la Era de la IA Generativa

Guía para Principiantes sobre la Integración de LLMs en tus Proyectos de Ciencia de Datos
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
