
¿Qué es la depuración de datos y por qué es importante para conjuntos de datos limpios?
En esta página
En el mundo actual impulsado por los datos, la información es el núcleo de la toma de decisiones, el análisis y la automatización. Sin embargo, los datos sin procesar suelen estar lejos de ser perfectos, plagados de inconsistencias, duplicaciones, formatos incorrectos e incluso errores evidentes. Aquí es donde la depuración de datos se vuelve esencial.
La depuración de datos es un enfoque riguroso y sistemático que va más allá de la limpieza básica de datos. Mientras que la limpieza puede corregir algunos errores tipográficos o de formato, la depuración garantiza que los datos sean precisos, consistentes y confiables para su uso analítico o computacional. Esta guía completa explorará los entresijos de la depuración de datos, sus procesos y su importancia para mantener la calidad de los datos.
Depuración de datos vs. Limpieza de datos: Entendiendo las diferencias
Aunque a menudo se usan indistintamente, la limpieza de datos y la depuración de datos tienen diferencias distintivas:
- Limpieza de datos: Este proceso aborda problemas menores y obvios como errores ortográficos, puntos decimales fuera de lugar o capitalización inconsistente.
- Depuración de datos: Este método incluye todo en la limpieza de datos y va más allá. Implica verificaciones basadas en lógica, eliminación de duplicados, validación y correcciones estructurales para alinear el conjunto de datos con estándares definidos.
Piensa en la limpieza de datos como ordenar una habitación, mientras que la depuración de datos es como una limpieza profunda que elimina la suciedad no visible.
Principales problemas abordados por la depuración de datos
Durante el proceso de depuración, se abordan varios errores de datos:
- Inexactitudes: Valores incorrectos o desactualizados.
- Duplicados: Entradas repetidas que sesgan el análisis e inflan los datos.
- Problemas de formato: Formatos desalineados que impiden un procesamiento adecuado.
- Datos nulos o faltantes: Campos vacíos que necesitan atención, ya sea para ser llenados, marcados o eliminados.
- Inconsistencias: Valores contradictorios para la misma variable en distintos registros.
El objetivo es eliminar estos errores y garantizar que cada punto de datos se adhiera a las reglas y estándares predeterminados.
Pasos clave en el proceso de depuración de datos
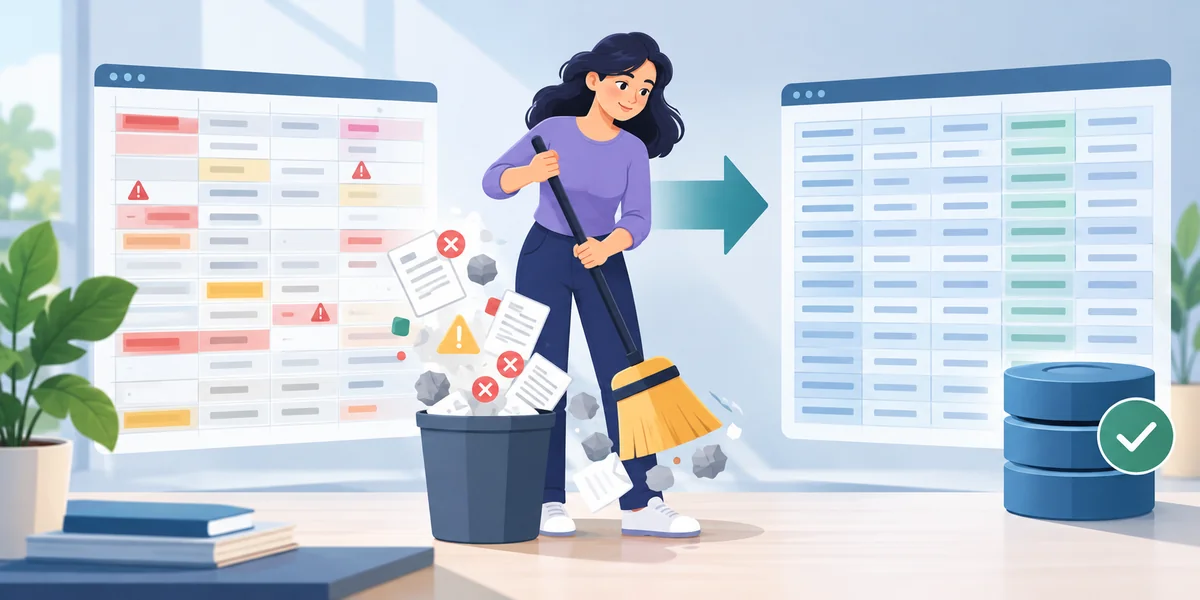
La depuración de datos generalmente implica una serie de pasos estructurados:
1. Perfilado de datos
Este paso examina el conjunto de datos para comprender su estructura, patrones y contenido. El perfilado resalta problemas críticos como valores nulos excesivos, tipos de datos inesperados o patrones inconsistentes.
2. Definición de estándares
Antes de comenzar la limpieza, se definen reglas claras y métricas de calidad de datos. Esto puede incluir reglas de formato para fechas, rangos de valores aceptables y criterios para identificar duplicados.
3. Detección de errores
Utilizando algoritmos o scripts de validación, la herramienta de depuración escanea el conjunto de datos en busca de problemas basados en los estándares definidos. Los errores son marcados para corrección o eliminación.
4. Corrección o eliminación
Dependiendo de la gravedad del problema, los datos marcados pueden ser corregidos, reemplazados o eliminados. Las herramientas automatizadas a menudo ayudan a aplicar estas decisiones de manera consistente.
5. Validación final
El conjunto de datos limpio se verifica contra los estándares originales para asegurar que todas las correcciones se hayan aplicado correctamente. Se puede generar una puntuación de calidad o un registro de errores para fines de auditoría.
Los beneficios de la depuración de datos
Los beneficios de la depuración de datos son extensos. No se trata solo de ordenar hojas de cálculo, sino que impacta directamente en la efectividad del uso de datos. Aquí hay algunas ventajas notables:
- Mejora de la precisión: Corregir errores conduce a mejores resultados analíticos.
- Consistencia: Se aplican formatos y valores estándar en todo el conjunto de datos.
- Eficiencia: Los datos limpios reducen el tiempo dedicado a solucionar errores más tarde.
- Conformidad: Adherirse a los estándares internos de datos se vuelve más fácil.
- Optimización: Eliminar entradas innecesarias hace que los datos sean más ligeros y rápidos de procesar.
Técnicas de depuración de datos
La depuración de datos implica diversas técnicas, cada una abordando diferentes problemas de datos. Estas técnicas aseguran que el conjunto de datos no solo esté limpio, sino también sea confiable y listo para su uso:
- Estandarización: Asegura uniformidad en formatos de datos y convenciones de nombres, eliminando confusiones y mejorando la precisión en la agrupación e informes.
- Eliminación de duplicados: Identifica y fusiona o elimina entradas duplicadas comparando identificadores clave como nombres o IDs.
- Validación de campos: Asegura que las entradas de datos cumplan con criterios específicos, verificando formatos para corrección y marcando entradas inválidas.
- Detección de valores atípicos: Resalta valores que se desvían significativamente de la norma, generalmente indicando errores de entrada de datos.
- Normalización: Convierte valores a una unidad o formato común cuando los datos provienen de diferentes fuentes, alineando los sistemas de escala y medición.
Estas técnicas forman el núcleo de una estrategia de depuración efectiva.
Depuración de datos manual vs. automatizada
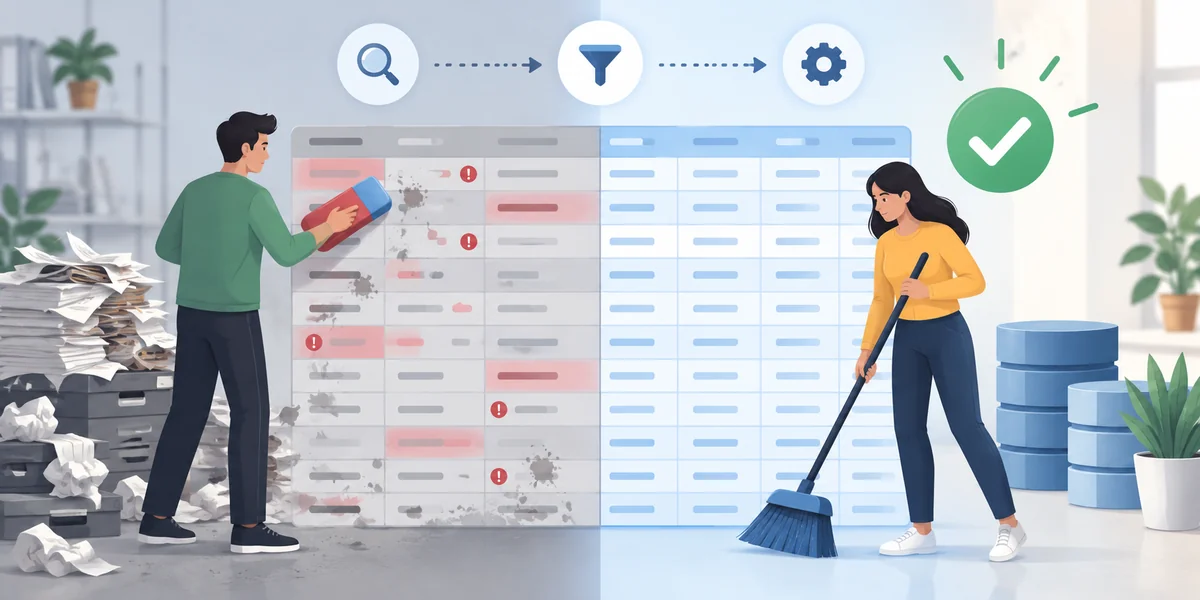
Si bien los conjuntos de datos pequeños pueden ser inspeccionados y corregidos manualmente, la mayoría de las tareas de depuración modernas utilizan herramientas de software. La depuración manual consume mucho tiempo y es propensa a errores, especialmente con conjuntos de datos grandes.
Las herramientas automatizadas permiten a los usuarios definir reglas de validación, rastrear cambios y generar informes, manejando miles o millones de registros con rapidez y consistencia. Las plataformas populares incluyen tanto herramientas de código abierto como soluciones a nivel empresarial, ofreciendo características como soporte multilingüe e integración con bases de datos.
Cuándo depurar tus datos
La depuración regular debe ser parte de cualquier flujo de trabajo de gestión de datos estructurado. Es mejor realizar la depuración:
- Antes de importar datos a herramientas analíticas.
- Al migrar de un sistema a otro.
- Después de fusionar datos de múltiples fuentes.
- En una base programada (por ejemplo, trimestral o semestralmente).
Incluso si tus datos se generan internamente, pequeños errores se acumulan con el tiempo. La depuración periódica asegura que los conjuntos de datos permanezcan limpios y utilizables a largo plazo.
Conclusión
La depuración de datos es esencial para mantener conjuntos de datos de alta calidad y confiables. A diferencia de la limpieza básica, ofrece un enfoque más profundo y estructurado para identificar y eliminar errores.
Al depurar regularmente tus datos, aseguras que cumplan con los estándares internos, rindan bien en análisis y eviten errores costosos. Los datos limpios son la base de una toma de decisiones inteligente, y la depuración es la herramienta que los mantiene sólidos.
Artículos relacionados

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas

11 Libros Que Todo Científico de Datos Debe Leer en 2025
¿Qué es Alteryx? Aprende Cómo Esta Herramienta Simplifica las Tareas de Preparación de Datos
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
¿Qué son las Redes Generativas Adversarias (GANs)?
Cómo UltraCamp utiliza la IA para construir conexiones reflexivas con los clientes
Las 5 Vs del Big Data: Comprendiendo su Papel en la Gestión de Datos
Inteligencia Artificial para Principiantes
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles
Comprendiendo el Impacto de la IA en la Escritura Creativa
Diferencias Clave Entre Ciencia de Datos y Aprendizaje Automático Explicadas
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
