
MoViNets: Reconocimiento de Video Rápido y Eficiente en Dispositivos Móviles
En esta página
El reconocimiento de video tradicionalmente ha requerido tiempo y recursos significativos. A medida que más aplicaciones móviles integran el procesamiento de video, la demanda de soluciones en tiempo real y ligeras se ha disparado. En este contexto, MoViNets, o redes de video móviles, ofrecen una alternativa robusta y eficiente.
MoViNets están diseñadas para equilibrar la precisión, la velocidad y el uso de memoria, permitiendo que dispositivos con recursos limitados comprendan videos. Esta arquitectura permite una inteligencia de video altamente eficiente sin la carga computacional típica, aplicable desde el reconocimiento de acciones hasta el análisis en tiempo real en teléfonos móviles.
Exploremos qué hace únicas a las MoViNets, cómo funcionan y su lugar en el mundo en evolución del reconocimiento de video potenciado por IA.
¿Qué Son las MoViNets?
MoViNets, o Redes de Video Móviles, son modelos avanzados de aprendizaje profundo diseñados para el reconocimiento eficiente de video en dispositivos móviles y de borde. A diferencia de las redes convolucionales 3D tradicionales que demandan mucha memoria y poder de cómputo, MoViNets son ligeras, rápidas y optimizadas para transmisión en tiempo real.
La innovación de estos modelos radica en su manejo de la información temporal. Los datos de video no son meramente una colección de imágenes; son una secuencia. MoViNets abordan esto procesando cuadros de video de manera que capturan efectivamente patrones espaciales y temporales, incluso en dispositivos con limitaciones de hardware.
Innovaciones Clave de MoViNets
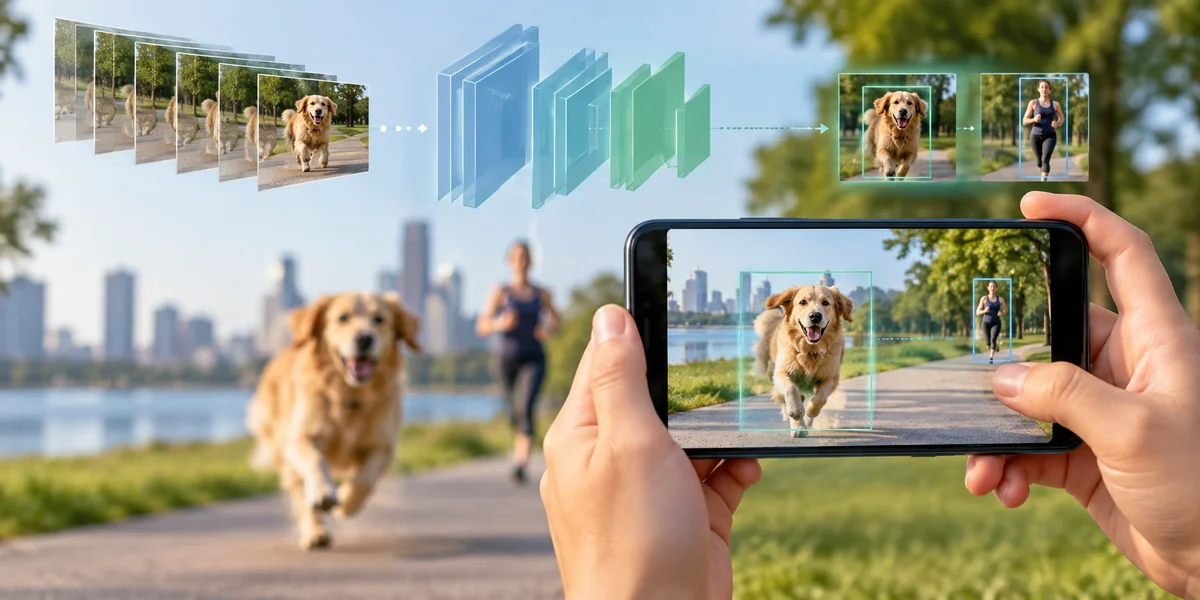
La genialidad de MoViNets reside en su construcción y funcionalidad. Varias técnicas se combinan para mejorar su eficiencia:
Búsqueda de Arquitectura Neural (NAS)
MoViNets se basan en un enfoque de búsqueda. Utilizando NAS, la arquitectura explora innumerables combinaciones de tamaños de kernel, números de filtro y profundidades de capa para identificar la configuración óptima para una tarea específica. Este método permite un ajuste fino automático entre rendimiento y uso de recursos.
Búferes de Transmisión
Un desafío significativo en el reconocimiento de video es la memoria requerida para procesar secuencias largas. MoViNets abordan esto con búferes de transmisión, dividiendo el video en clips más pequeños y manejables. En lugar de reprocesar cuadros superpuestos, los búferes de transmisión almacenan características de los extremos de los clips, preservando dependencias a largo plazo sin un uso excesivo de memoria.
Operaciones Causales
Para análisis de video en tiempo real, los modelos deben procesar datos a medida que llegan. MoViNets emplean convoluciones causales, donde cada cuadro de salida depende solo de las entradas actuales y anteriores. Esto es crucial para aplicaciones de transmisión como transmisiones de video en vivo.
Ensamblaje Temporal
Para mantener la precisión mientras operan de manera eficiente, MoViNets utilizan ensamblaje temporal. Dos modelos idénticos procesan el mismo video en intervalos de cuadros escalonados, promediando sus predicciones para mejorar la precisión con una demanda computacional mínima.
Ventajas de MoViNets
MoViNets ofrecen varios beneficios clave:
- Uso Eficiente de Memoria: Su arquitectura basada en transmisión reduce significativamente las demandas de memoria, haciéndolas ideales para implementación en móviles o de borde.
- Procesamiento en Tiempo Real: Las operaciones causales les permiten manejar video en vivo, cuadro a cuadro, sin demoras.
- Modelos Escalables: Varias versiones (A0 a A5) permiten a los usuarios priorizar velocidad o precisión.
- Precisión Competitiva: A pesar de su naturaleza ligera, se desempeñan de manera comparable a muchos modelos de reconocimiento de video a gran escala.
- Versatilidad: Apto para aplicaciones que van desde vigilancia de seguridad hasta aplicaciones de fitness y automatización de hogares inteligentes.
¿Por Qué Importan las MoViNets Hoy?
La demanda de análisis de video eficiente está aumentando rápidamente. Ya sea comprensión de escenas en vehículos autónomos, monitoreo de pacientes en atención médica o detección de anomalías en imágenes de seguridad en vivo, los dispositivos deben manejar inteligentemente el video, a menudo en tiempo real.
MoViNets llevan el reconocimiento de acciones de alto rendimiento y la comprensión de escenas a plataformas donde la energía y la memoria son escasas. Logran lo que alguna vez se pensó imposible: procesamiento de video eficiente y preciso en teléfonos inteligentes, cámaras integradas y sensores IoT.
A diferencia de los modelos pesados de CNN 3D, que requieren recursos computacionales extensivos, MoViNets ofrecen un equilibrio refrescante. Mantienen la precisión sin sobrecargar el hardware, un factor clave para habilitar la IA de borde a escala.
¿Dónde Pueden Usarse las MoViNets?
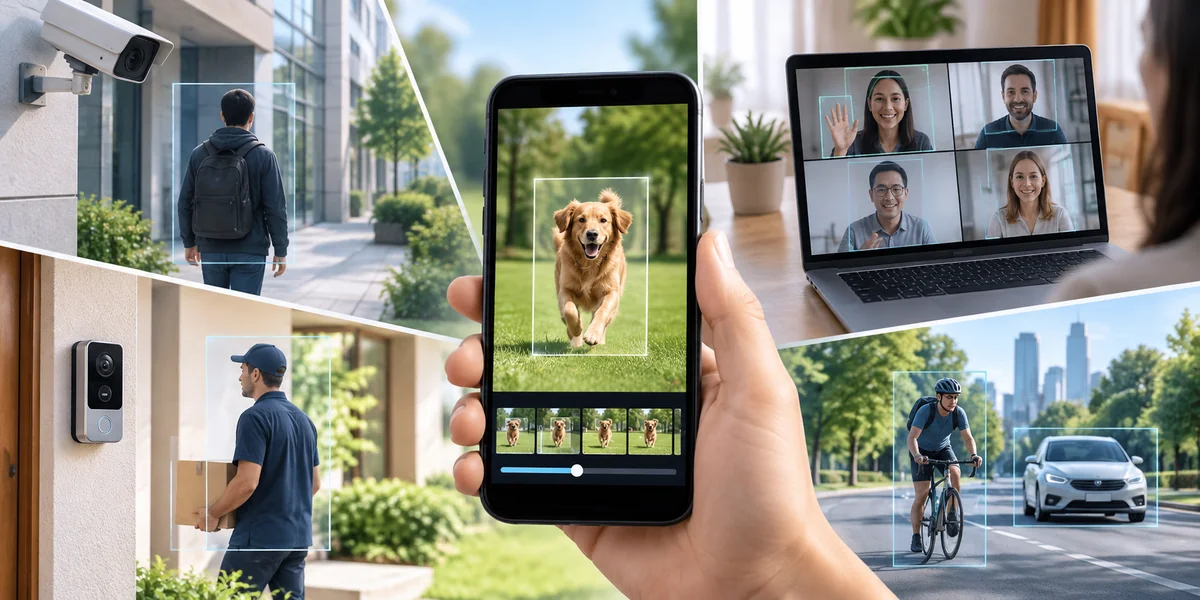
Gracias a su eficiencia y capacidad para operar en dispositivos móviles y de borde, MoViNets son ideales para el reconocimiento de video en tiempo real en varios escenarios prácticos. Estos modelos pueden mejorar tanto las aplicaciones orientadas al consumidor como los sistemas de infraestructura crítica.
1. Sistemas de Vigilancia Inteligente
Despliega MoViNets in situ para detectar actividades sospechosas en tiempo real sin transmitir todo a un servidor central.
2. Herramientas de Videoconferencia
Mejora las reuniones virtuales detectando gestos, expresiones o acciones de fondo sin agotar los recursos del dispositivo.
3. Dispositivos de Monitoreo de Salud
Útil en hospitales o dispositivos portátiles para monitorear a los pacientes mediante análisis de video de postura, movimiento o expresiones faciales.
4. Realidad Aumentada (AR)
Las aplicaciones de AR móvil pueden aprovechar MoViNets para reconocer patrones de movimiento y objetos dentro del entorno del usuario.
5. Análisis Deportivo
Analiza jugadas y movimientos de jugadores durante un partido para brindar información a entrenadores o aficionados en tiempo real.
¿Cómo se Entrenan las MoViNets?
El entrenamiento de MoViNets involucra el conjunto de datos Kinetics-600, un punto de referencia de reconocimiento de acciones a gran escala que comprende 600 categorías de acciones de videos de YouTube. Este conjunto de datos ofrece un conjunto diverso de actividades humanas, haciéndolo ideal para entrenar modelos destinados a tareas de comprensión de video en el mundo real.
- Dividir Videos en Clips Cortos
En lugar de usar videos de longitud completa, el conjunto de datos se divide en clips más cortos, típicamente de unos pocos segundos de duración. Estos segmentos más cortos permiten al modelo capturar patrones temporales detallados dentro de ventanas de tiempo manejables, reduciendo el uso de memoria durante el entrenamiento y mejorando las tasas de convergencia.
- Aplicar Aumento de Datos
Se aplican varias transformaciones, como recortes aleatorios, volteo horizontal, ajustes de brillo y parpadeo temporal, a cada clip para mejorar la generalización. Estas técnicas de aumento ayudan al modelo a volverse robusto frente a diferentes condiciones de video, iluminación, ángulos y velocidades.
- Usar Convoluciones Causales para el Ordenamiento Temporal
Las convoluciones causales aseguran que cada predicción dependa solo de cuadros actuales y previos, nunca de futuros. Esto es crucial para la inferencia en tiempo real y permite que las MoViNets funcionen eficazmente en entornos de transmisión.
- Implementar Modelos de Ensamblaje para Mejorar la Generalización
Se entrenan dos modelos idénticos de manera independiente con ligeras variaciones en el tiempo de entrada de cuadros. Sus predicciones se promedian, mejorando la precisión general sin aumentar significativamente el tiempo de ejecución.
Estos modelos entrenados se optimizan y exportan utilizando TensorFlow Lite, permitiendo un despliegue eficiente en dispositivos móviles y de borde con poder computacional limitado.
Posibilidades Futuras
A medida que los datos de video se vuelven más centrales para la IA, MoViNets pueden expandirse a:
- Sistemas AR/VR para reconocimiento de escenas en tiempo real
- Drones autónomos con detección de acciones a bordo
- Dispositivos portátiles que interpretan actividades humanas
- IA en juegos, ofreciendo respuestas inteligentes basadas en entrada de video
En todos estos escenarios, la capacidad de procesar datos de video de manera rápida y precisa, sin depender de un servidor o un clúster de GPU, es transformadora.
Conclusión
MoViNets están revolucionando el reconocimiento de video. Con su diseño simplificado, eficiencia de memoria y capacidades en tiempo real, ofrecen una combinación perfecta de precisión y practicidad. Desde aplicaciones de transmisión en vivo hasta juegos móviles y vigilancia, estos modelos están diseñados para llevar el poder de la IA de video a dispositivos en todas partes.
Su rendimiento demuestra que no necesitas redes voluminosas para procesar contenido de video complejo. A medida que la investigación continúa y surgen nuevas variantes, podemos anticipar versiones aún más refinadas y poderosas de MoViNets en un futuro cercano.
Si tu objetivo es llevar la comprensión de video de alta calidad a plataformas ligeras, es hora de considerar seriamente a MoViNets.
Artículos relacionados
Cómo UltraCamp utiliza la IA para construir conexiones reflexivas con los clientes
Redes Neuronales y Funciones de Activación: Una Conexión Crucial
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
El Impacto de los GANs en la Autenticidad de los Medios
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
¿Qué son las Redes Generativas Adversarias (GANs)?
Comprendiendo el Impacto de la IA en la Escritura Creativa
Explorando NVIDIA NIM: Preparando el Futuro de la Inferencia de IA a Gran Escala
Crea Títulos y Descripciones de YouTube Usando ChatGPT Efectivamente
CNN vs. GAN: ¿En qué se Diferencian?
Guía para Principiantes sobre Probabilidad Conjunta, Marginal y Condicional
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
