
ChatTTS: Convierte Tu Texto en Voz Realista y Expresiva
En esta página
La tecnología de texto a voz ha avanzado rápidamente en los últimos años, pero pocas herramientas pueden producir audio tan natural, expresivo y flexible como ChatTTS. Diseñado con control y personalización en su núcleo, ChatTTS es un modelo de IA de vanguardia que transforma contenido escrito en audio fluido y similar al habla.
Desde diálogos expresivos hasta soporte multilingüe, esta herramienta no solo “lee” tu texto en voz alta, sino que lo trae a la vida. Si buscas una solución que ofrezca generación de voz de alta calidad con parámetros ajustables, ChatTTS podría ser exactamente lo que necesitas.
Exploremos qué hace que este modelo destaque en el creciente ecosistema de herramientas de generación de voz.
¿Qué Hace Único a ChatTTS?
ChatTTS ofrece un marco robusto para generar voz que se siente genuinamente humana. A diferencia de muchos modelos TTS genéricos, prioriza el control, la conciencia del contexto y el matiz emocional.
En su núcleo, ChatTTS soporta:
- Fluidez conversacional para diálogos de ida y vuelta
- Compatibilidad dual de idiomas, principalmente en inglés y chino
- Personalización de identidad del hablante, para imitar diversos tipos de voz
- Control basado en tokens para ajustar la entrega del discurso
Este modelo no se trata solo de convertir oraciones en sonido. Sintetiza el diálogo con ritmo natural, tono y variaciones sutiles, cualidades que a menudo faltan en las herramientas de voz tradicionales.
Control Integrado con Tokens Especiales
Lo que distingue a ChatTTS es su capacidad para seguir tokens de control específicos incrustados en el texto. Estos tokens instruyen al modelo para introducir pausas, risas o descansos sutiles, permitiendo que el audio suene menos robótico y más realista.
Generalmente, hay dos tipos de control que puedes aplicar:
- Control a nivel de oración, como agregar pausas o marcadores emocionales
- Refinamiento a nivel de palabra, donde se aplican descansos y expresiones a frases individuales
Este sistema de tokens mejora la flexibilidad para los creadores que desean mantener una entrega consistente en guiones largos mientras preservan la expresividad.
Personalizando la Salida para Mejorar la Calidad del Discurso
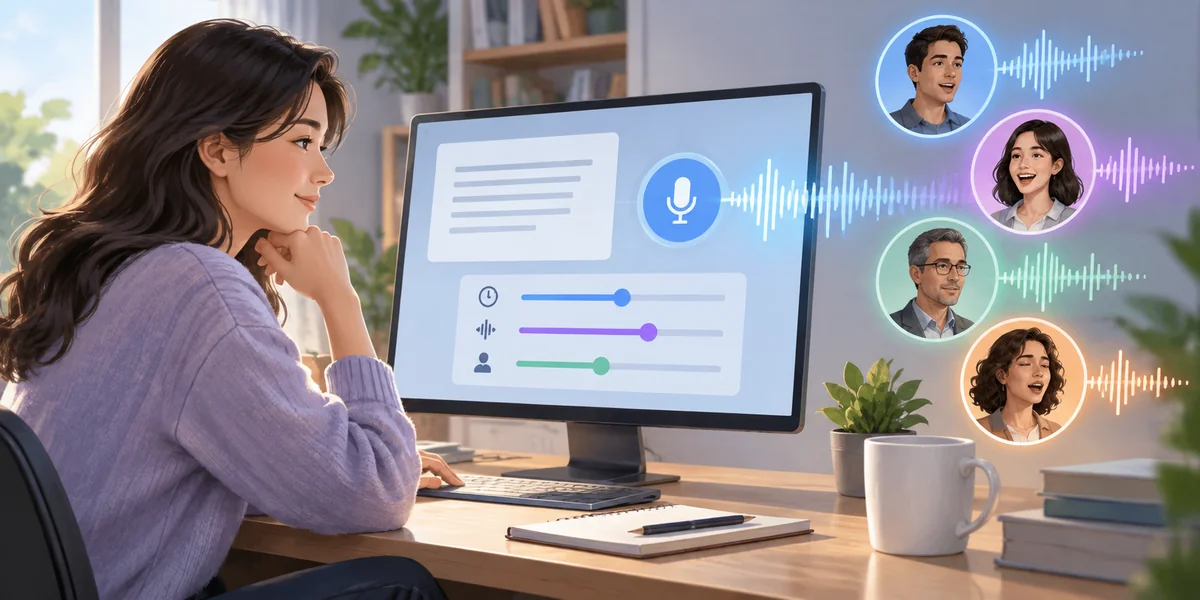
Otra fortaleza de ChatTTS es el ajuste fino de la salida. Los usuarios pueden ajustar el discurso generado modificando algunos valores de parámetros, que incluyen:
- Velocidad del discurso
- Variación o tono de voz
- Incorporación de identidad del hablante
Al ajustar estos parámetros, puedes crear audio que coincida con diferentes tonos, ya sea profesional, casual o dramático. Esto hace que ChatTTS sea adecuado para casos donde se necesita una expresión emocional consistente o una entrega de voz variada.
Diseño Ético y Uso Responsable
A medida que las herramientas de texto a voz ganan popularidad, también lo hacen las preocupaciones sobre su uso indebido. Los desarrolladores detrás de ChatTTS han tomado medidas proactivas para abordar estas preocupaciones mediante:
- Incorporando ruido imperceptible para identificar audio sintético
- Limitando la replicación excesivamente realista de voces
- Explorando mecanismos de marcado de agua de código abierto
Estas salvaguardas reflejan el compromiso del modelo con la innovación responsable y el uso ético. Es un recordatorio de que, aunque las herramientas de IA avanzadas ofrecen posibilidades creativas, también requieren un uso reflexivo.
Cómo Maneja ChatTTS el Procesamiento de Texto
El texto se refina primero antes de ser convertido en habla. El modelo analiza la estructura, identifica el tono y la intención, y aplica los tokens de discurso. Estos tokens pueden ser implícitos o explícitos, dependiendo de la configuración del usuario.
Puedes guiar a ChatTTS para que pause entre palabras, agregue tonos expresivos o simule una risa a mitad de una oración. El modelo interpreta estas señales, resultando en una generación de voz más fluida y dinámica.
Este proceso ayuda a ChatTTS a ir más allá de la narración plana o sin emociones, que a menudo es la limitación de los sistemas TTS estándar.
Ejecutando ChatTTS: Lo Que Debes Saber
Para usar ChatTTS, los usuarios generalmente siguen un enfoque simple de dos pasos:
- Preparar el entorno – Esto incluye instalar los paquetes necesarios y cargar los pesos del modelo.
- Proporcionar tu texto y parámetros – Proporcionas tu texto de entrada, junto con valores de personalización (por ejemplo, velocidad o tipo de hablante), y el modelo genera el archivo de audio.
Para mayor eficiencia, puedes evitar usar comandos de código exactos interactuando con el sistema a través de una interfaz gráfica, como una interfaz web, donde todos los ajustes se realizan mediante deslizadores o casillas de verificación.
Esto es especialmente útil para personas que no son desarrolladores o equipos que desean trabajar colaborativamente en proyectos de voz sin tocar ningún código de backend.
Muestreo Aleatorio de Hablantes
Una característica interesante de ChatTTS es la incorporación aleatoria de hablantes. En lugar de seleccionar un tipo de voz fijo, el modelo permite un muestreo de voz aleatorio, dando a tu audio un tono único con cada generación.
Esto te ayuda a:
- Evitar la monotonía en guiones repetitivos
- Simular múltiples personajes con diferentes voces
- Añadir una dinámica fresca en la narración de audio
Al aprovechar esta opción, los usuarios pueden crear contenido de voz que se siente más variado y vivo.
Control en Dos Etapas para Máximo Refinamiento
ChatTTS también introduce un control en dos etapas, permitiendo que el refinamiento del texto y la generación de audio ocurran en fases separadas. Así es como funciona:
- Etapa 1: El texto se analiza, y se incorporan tokens para el tiempo, el tono o el énfasis.
- Etapa 2: La versión refinada del texto se utiliza para generar el audio final.
Este método de dos etapas ayuda a los usuarios a probar y ajustar la estructura del discurso antes de comprometerse con la generación de audio. Puede ser especialmente útil al afinar guiones de gran extensión.
ChatTTS + LLMs = Generación de Voz Más Inteligente
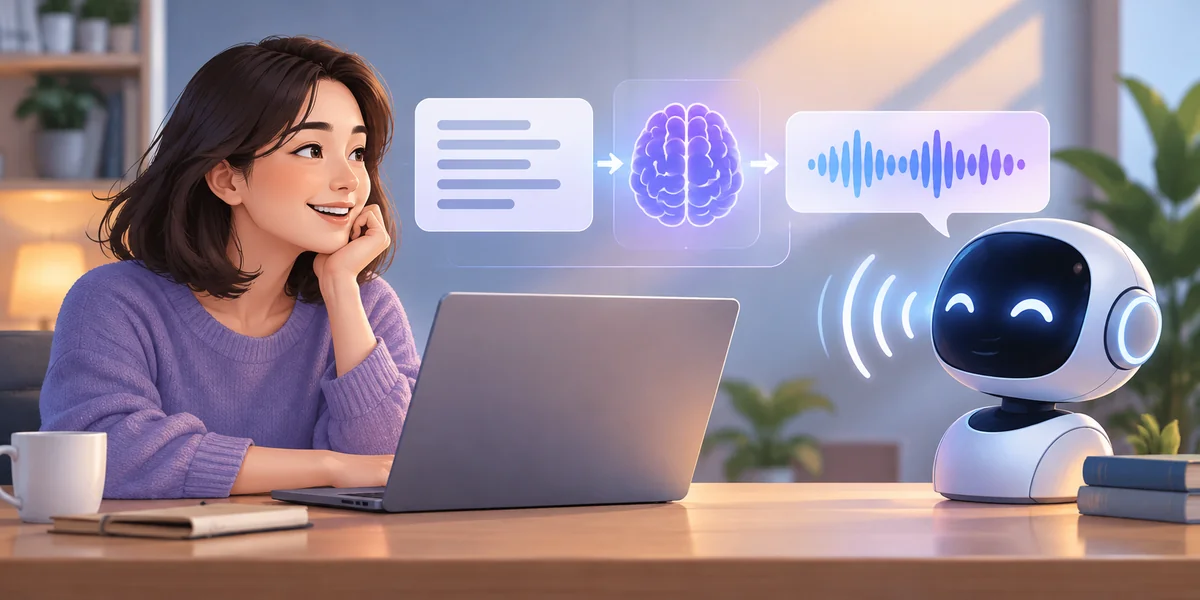
ChatTTS puede integrarse con modelos de lenguaje grandes (LLMs) para crear sistemas altamente dinámicos. En tales configuraciones, el LLM maneja la generación de contenido, mientras que ChatTTS convierte ese texto en voz.
Esta integración trae beneficios como:
- Respuestas de voz en tiempo real al texto generado
- Asistentes de IA que suenan humanos, no robóticos
- Interacción más natural en herramientas basadas en chat
Puedes usar esta combinación para construir chatbots, mesas de ayuda interactivas o sistemas de voz multilingües, todos con un flujo y tono de discurso consistente.
Interfaz y Accesibilidad
ChatTTS ofrece tanto una interfaz basada en scripts como una interfaz web opcional. La interfaz gráfica es simple, haciéndola accesible para usuarios que prefieren no escribir código. Los usuarios pueden pegar su texto, ajustar configuraciones de salida y reproducir o descargar el audio generado.
Su simplicidad, combinada con el desarrollo de código abierto, hace de ChatTTS una opción sólida tanto para principiantes como para expertos.
Conclusión
ChatTTS no es solo otra herramienta de síntesis de voz; es un avance en la generación de texto a voz controlable, expresiva y ética. Con sus poderosas opciones de personalización, soporte multilingüe e integración reflexiva con modelos de lenguaje grandes, abre la puerta a nuevas posibilidades creativas en aplicaciones de voz impulsadas por IA.
Ya sea que estés escribiendo diálogos digitales, creando contenido educativo o simplemente experimentando con salidas vocales, ChatTTS te permite dar vida a tus palabras, en tus propios términos.
Artículos relacionados
La IA en la Verificación de Identidad: Prevención de Fraude y Seguridad de Datos
Aprende PyLab Fácilmente: Guía para Principiantes sobre Fundamentos de Trazado en Python
Explorando el Potencial Empresarial de los Asistentes de Voz
Cómo el Reconocimiento de Entidades Nombradas (NER) Transforma el Procesamiento de Texto
La IA y la Salud Digital: Mejorando el Cuidado y el Bienestar de los Adultos Mayores
Desbloqueando el Futuro: Sinergias entre IA y Computación Cuántica
Cómo la profesión legal puede beneficiarse de la tecnología de IA
3 Tipos de Tecnología de Detección de Deepfake y Cómo Funcionan
¿Deberías Incluir la IA en la Estrategia Digital de Tu Negocio Hoy?
IA Tradicional vs IA Generativa
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
