
Cómo el Reconocimiento de Entidades Nombradas (NER) Transforma el Procesamiento de Texto
En esta página
El lenguaje está lleno de complejidades, y mientras los humanos comprenden el contexto sin esfuerzo, la IA lucha por entender las palabras sin estructura. El Reconocimiento de Entidades Nombradas (NER) es una tecnología transformadora que ayuda a las máquinas a identificar y categorizar información clave, como nombres, lugares y fechas, a partir de texto. ¿Alguna vez te has preguntado cómo los motores de búsqueda destacan instantáneamente los nombres de las empresas o cómo los chatbots reconocen las ubicaciones en tus consultas?
Esa es la función del NER. Transforma texto no estructurado en datos valiosos, haciendo que el análisis de texto basado en IA sea más inteligente y eficiente. Pero, ¿cómo funciona exactamente? Vamos a explorar cómo esta herramienta esencial impulsa la inteligencia artificial moderna y el procesamiento de datos.
Fundamentos del Reconocimiento de Entidades Nombradas
El NER es un componente crítico del análisis de texto, que permite a las máquinas identificar palabras significativas y categorizarlas en tipos predefinidos. Lo logra leyendo textos y usando algoritmos para detectar palabras o frases que correspondan a tipos de entidades específicas. Estos tipos pueden incluir nombres de individuos, ubicaciones, valores numéricos como fechas o cifras financieras, y tipos especializados como términos médicos o legales.
El proceso involucra dos pasos principales: detección y clasificación. Primero, el sistema detecta las entidades nombradas probables dentro del texto, identificando palabras o frases que puedan representar ciertas categorías. Después de la detección, el siguiente paso es la clasificación, en la que las palabras detectadas se etiquetan según su significado. Por ejemplo, en la frase "Elon Musk estableció SpaceX en 2002," el sistema identifica "Elon Musk" como un individuo, "SpaceX" como una organización, y "2002" como una fecha.
Para ejecutar estas operaciones de manera eficiente, los sistemas NER dependen de varios enfoques, como métodos basados en reglas, modelos estadísticos y aprendizaje profundo. Los métodos basados en reglas utilizan patrones predefinidos y diccionarios para reconocer entidades, mientras que los modelos estadísticos utilizan probabilidades para hacer predicciones a partir de datos de entrenamiento. Los modelos actuales de aprendizaje profundo, incluidos aquellos basados en arquitecturas de transformadores como BERT y GPT, aprovechan grandes cantidades de datos de texto para aprender el contexto y mejorar la eficiencia del reconocimiento de entidades. Estos modelos aprenden continuamente de nuevos datos, mejorando su comprensión de las diversas estructuras del lenguaje.
Una de las fortalezas clave del Reconocimiento de Entidades Nombradas es su capacidad para procesar grandes volúmenes de texto rápidamente. En consecuencia, se utiliza ampliamente en campos como los motores de búsqueda, la automatización de servicios al cliente y la investigación médica. Al extraer información específica de conjuntos de datos extensos, el NER permite a empresas y organizaciones analizar contenido de manera eficiente, ahorrando tiempo y recursos.
Aplicaciones y Desafíos del NER
El verdadero poder del Reconocimiento de Entidades Nombradas radica en su amplia gama de aplicaciones. En la agregación de noticias y el monitoreo de medios, el NER ayuda a filtrar y organizar artículos de noticias al etiquetar entidades clave, facilitando el seguimiento de menciones de personas, empresas o ubicaciones. En finanzas, analiza informes y detecta información relevante para los inversores. De manera similar, en el cuidado de la salud, el NER extrae condiciones médicas, nombres de medicamentos y procedimientos de tratamiento de los registros de pacientes, ayudando en el diagnóstico y la investigación.
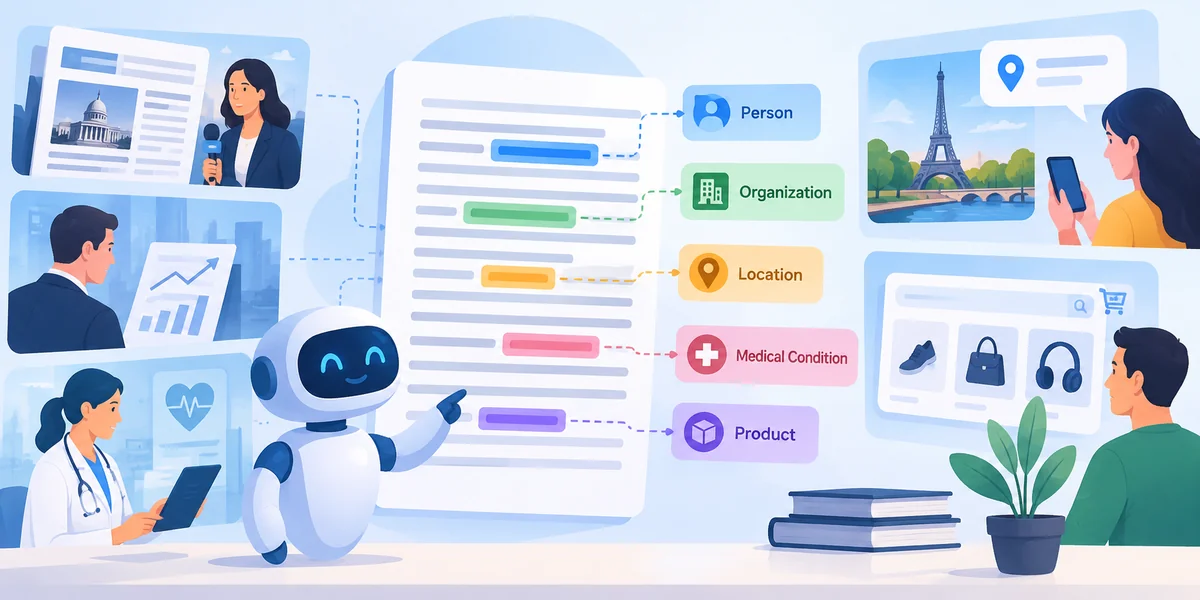
Otro caso de uso crucial es el servicio al cliente, donde los chatbots y asistentes virtuales dependen del NER para interpretar las consultas de los usuarios con precisión. Por ejemplo, si un usuario pregunta, "¿Cómo está el clima en París?" el sistema identifica "París" como una ubicación y obtiene los datos meteorológicos relevantes. En e-commerce, el NER mejora la funcionalidad de búsqueda al reconocer nombres de marcas, categorías de productos y preferencias de los usuarios, asegurando mejores resultados de búsqueda y recomendaciones.
A pesar de sus ventajas, el Reconocimiento de Entidades Nombradas también enfrenta desafíos. Un problema significativo es el manejo de palabras ambiguas y variaciones de contexto. Por ejemplo, "Washington" podría referirse al apellido de una persona, una ciudad o incluso al gobierno de los EE. UU., dependiendo del contexto. Resolver tales ambigüedades requiere algoritmos avanzados que analicen las palabras circundantes y la estructura de la oración.
Otro desafío es el manejo de entidades nuevas o desconocidas. El lenguaje está en constante evolución, con nuevos nombres de empresas, jerga y términos específicos de dominio que aparecen regularmente. Los modelos tradicionales pueden tener dificultades para reconocer estos sin actualizaciones frecuentes. Además, el rendimiento del NER varía entre idiomas debido a las diferencias en gramática y sintaxis. Mientras que los modelos NER en inglés están bien desarrollados, otros idiomas con estructuras complejas a menudo requieren datos de entrenamiento adicionales para lograr niveles de precisión similares.
Las preocupaciones de privacidad también surgen al usar el Reconocimiento de Entidades Nombradas en información sensible. En las industrias de salud y legal, donde la confidencialidad es crucial, los modelos NER deben garantizar que los datos privados se manejen de manera segura sin exponer detalles personales. Por esta razón, las organizaciones que trabajan con datos sensibles suelen emplear modelos personalizados con protocolos estrictos de protección de datos.
El Futuro del Reconocimiento de Entidades Nombradas
A medida que avanza la inteligencia artificial, el Reconocimiento de Entidades Nombradas (NER) se vuelve más sofisticado, gracias al aprendizaje profundo y los modelos basados en transformadores. Estos avances permiten a las máquinas comprender el lenguaje con mayor precisión, reduciendo errores en la identificación de entidades clave. La integración de modelos preentrenados a gran escala ha mejorado aún más la conciencia del contexto, haciendo que el NER sea más confiable.
Un desarrollo significativo es el auge de los modelos multilingües, que permiten a los sistemas NER procesar varios idiomas sin necesidad de un entrenamiento extenso. Esto es particularmente beneficioso para las empresas globales, facilitando un análisis de texto sin interrupciones en diferentes regiones. Además, los avances en el aprendizaje sin ejemplos y con pocos ejemplos ayudan a la IA a reconocer nuevas entidades con datos de entrenamiento mínimos, abordando un desafío importante en los modelos NER tradicionales.
El NER también está evolucionando al integrarse con otras técnicas de procesamiento del lenguaje natural, como el análisis de sentimientos y la extracción de relaciones. Esta integración permite a la IA no solo identificar entidades, sino también analizar sus relaciones y sentimientos. A medida que mejora su eficiencia, el NER seguirá transformando industrias, desde el procesamiento de documentos legales hasta el monitoreo en tiempo real de las tendencias de las redes sociales.
Conclusión
El Reconocimiento de Entidades Nombradas se ha convertido en una herramienta vital en el análisis de texto impulsado por IA, permitiendo a las máquinas extraer datos significativos de texto no estructurado. A medida que la tecnología evoluciona, el NER será aún más preciso, manejando datos multilingües, matices contextuales y aplicaciones en tiempo real con mayor eficiencia. Su integración con otras técnicas de procesamiento del lenguaje natural desbloqueará ideas más profundas en todas las industrias. Sin embargo, las mejoras continuas en la reducción de sesgos, la mejora de la comprensión del lenguaje y el aseguramiento del uso ético de la IA serán cruciales para maximizar su potencial en los próximos años.
Artículos relacionados
El Concepto de Entidades en NLP: Cómo la IA Entiende el Lenguaje
La IA en la Verificación de Identidad: Prevención de Fraude y Seguridad de Datos
Análisis Predictivo Potenciado por IA para Pronóstico de Demanda Energética
El Papel de la IA en el Cine: Escritura, Edición y Efectos Visuales Impresionantes
Entrenadores de IA: El Puente Entre los Datos y la Inteligencia
Herramientas de IA Transformando la Educación Especial para el Aprendizaje Inclusivo
Aprendizaje Federado: Entrena Modelos de IA Manteniendo la Privacidad de los Datos
Cómo la IA Entiende el Lenguaje: Una Guía sobre el Procesamiento del Lenguaje Natural
La IA y la Salud Digital: Mejorando el Cuidado y el Bienestar de los Adultos Mayores
¿Qué es la tecnología RPA y qué puede hacer por tu negocio?
Desbloqueando el Futuro: Sinergias entre IA y Computación Cuántica
Cómo la profesión legal puede beneficiarse de la tecnología de IA
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
