
Redes Neuronales y Funciones de Activación: Una Conexión Crucial
En esta página
Las redes neuronales son la columna vertebral de la inteligencia artificial moderna, impulsando desde asistentes de voz hasta automóviles autónomos. Pero, ¿qué las hace tan efectivas? La respuesta radica en las funciones de activación. Estas operaciones matemáticas esenciales deciden si una neurona debe "disparar" o permanecer inactiva, moldeando cómo una red aprende y procesa datos. Sin ellas, las redes neuronales serían nada más que calculadoras complejas, incapaces de reconocer patrones o tomar decisiones.
Las funciones de activación proporcionan a las redes neuronales su verdadero poder, ya sea clasificando imágenes o traduciendo idiomas. Entender las funciones de activación es fundamental para dominar el aprendizaje profundo y desarrollar modelos que funcionen eficazmente en escenarios del mundo real.
¿Qué es una Función de Activación?
En su esencia, una función de activación es una fórmula matemática que determina si un nodo de red neuronal (neurona) debe activarse. Cuando se introduce una entrada en una neurona, esta calcula la entrada y genera un resultado. La función de activación decide si la señal de esta neurona debe transmitirse a la siguiente capa de la red. Lo hace al calcular la suma ponderada de las entradas y aplicar una transformación a esta suma para producir un resultado final.
La importancia de esta transformación no puede subestimarse. Sin una función de activación, toda la red funcionaría como un modelo lineal simple, incapaz de resolver problemas que requieren toma de decisiones complejas. Al introducir no linealidad a través de funciones de activación, las redes neuronales pueden aprender de los datos y predecir resultados basados en patrones complejos.
¿Por Qué las Redes Neuronales Necesitan Funciones de Activación?
Las funciones de activación son cruciales porque introducen no linealidad. Imagina intentar trazar una línea recta para ajustar puntos de datos en un gráfico bidimensional. Un modelo lineal solo puede generar una línea recta, limitando su capacidad para capturar relaciones de datos complejas. Al incorporar transformaciones no lineales, las redes neuronales pueden mapear datos de entrada en un conjunto significativamente más amplio de posibles salidas.
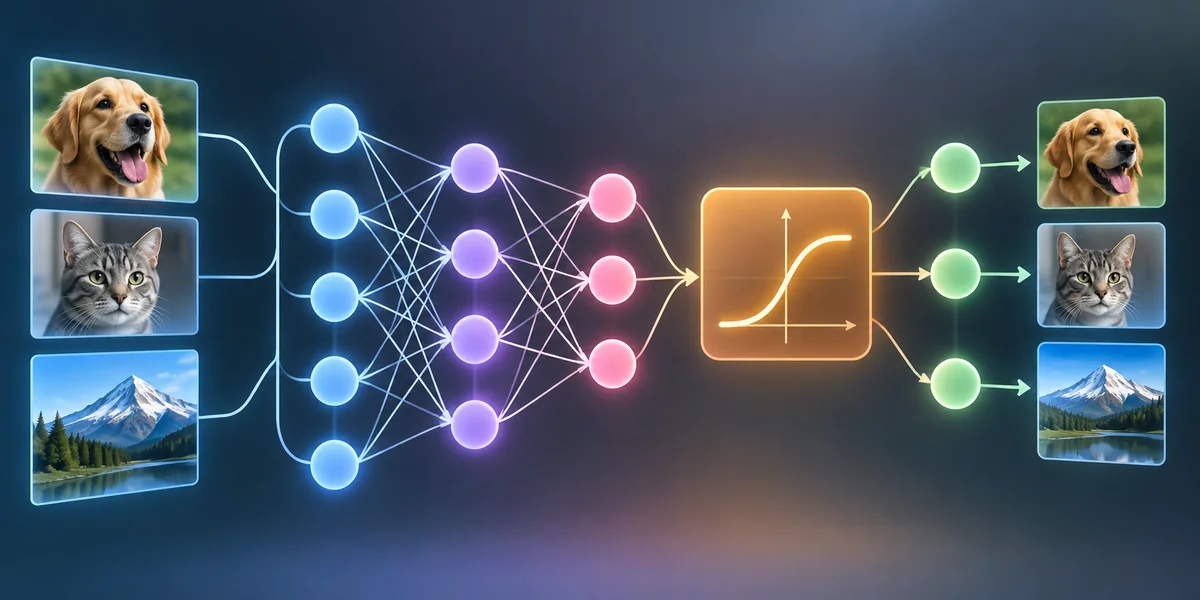
En otras palabras, las funciones de activación ofrecen a las redes neuronales la flexibilidad para aprender de datos complejos y de alta dimensión. Permiten que el modelo se adapte a las complejidades de las tareas del mundo real, como pronosticar precios de acciones, reconocer objetos en imágenes o generar lenguaje humano. Sin ellas, las redes neuronales serían mucho menos efectivas y poderosas.
Otra razón por la que las funciones de activación son importantes es que permiten la retropropagación, un algoritmo clave utilizado para entrenar redes neuronales ajustando los pesos de las conexiones entre neuronas. Durante el entrenamiento, el modelo utiliza la derivada de la función de activación para actualizar los pesos y mejorar su rendimiento con el tiempo.
Tipos de Funciones de Activación
Existen varios tipos de funciones de activación utilizadas en redes neuronales, cada una con sus ventajas y desventajas. Algunas son más adecuadas para tareas específicas que otras. Exploremos las más comunes.
Función de Activación Sigmoide
Una de las funciones de activación más tradicionales es la función sigmoide. Mapea valores de entrada a un rango entre 0 y 1, lo que la hace particularmente útil para tareas de clasificación binaria. La fórmula para la función sigmoide es:
Aquí, e es la base del logaritmo natural y z es la suma ponderada de la entrada. Mapea suavemente las salidas entre 0 y 1, siendo útil para tareas basadas en probabilidades. Sin embargo, tiene un inconveniente: el problema del "gradiente que desaparece", donde los gradientes se reducen para entradas grandes, ralentizando o dificultando el entrenamiento de redes profundas.
ReLU (Unidad Lineal Rectificada)
La función ReLU se ha convertido en la función de activación más utilizada en los últimos años, especialmente en modelos de aprendizaje profundo. Es simple y computacionalmente eficiente, con la fórmula:
ReLU devuelve la entrada si es positiva; de lo contrario, devuelve cero. Evita el problema del gradiente que desaparece, permitiendo un entrenamiento más rápido. Sin embargo, puede causar el problema del "ReLU muerto", donde las neuronas dejan de aprender debido a salidas constantes de cero. Variantes como Leaky ReLU abordan esto permitiendo pequeños valores negativos en lugar de cero absoluto.
Tanh (Tangente Hipérbolica)
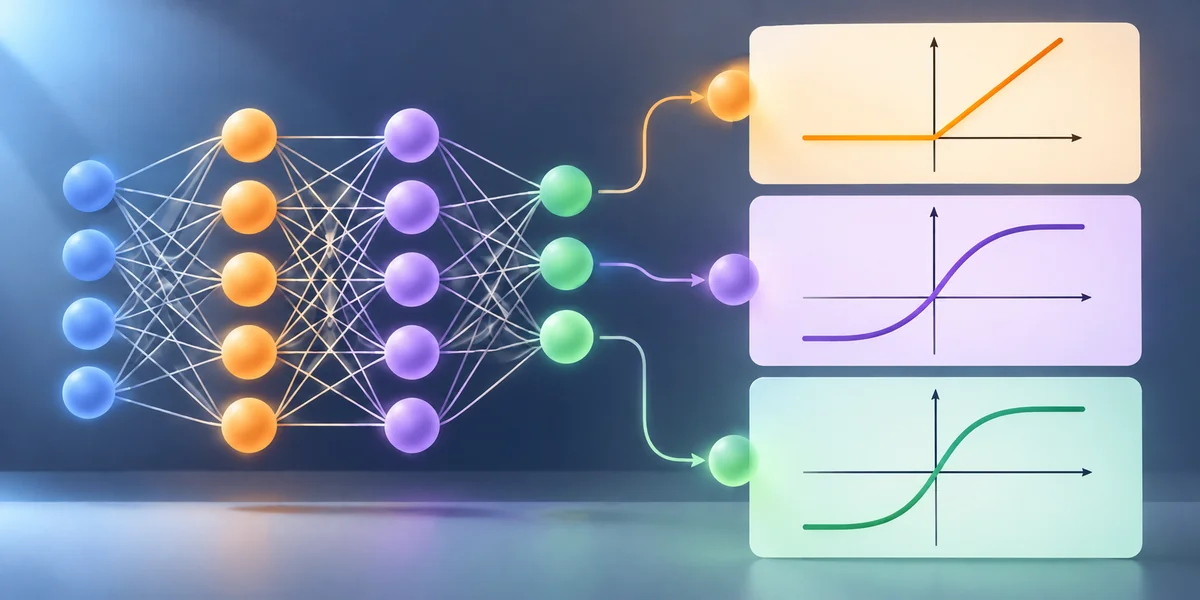
La función de activación tanh es similar a la sigmoide pero mapea la salida a un rango entre -1 y 1 en lugar de 0 y 1. Su fórmula es:
Al igual que la sigmoide, tanh sufre del problema del gradiente que desaparece, pero tiende a funcionar mejor en la práctica porque tiene un rango de salida más amplio. Es útil cuando la salida necesita centrarse alrededor de cero, lo que ayuda en el aprendizaje durante el entrenamiento.
Función de Activación Softmax
La función de activación softmax se utiliza principalmente en la capa de salida de problemas de clasificación, especialmente cuando hay múltiples clases. Toma un vector de puntuaciones crudas (logits) y las normaliza en una distribución de probabilidad. La fórmula para softmax es:
Aquí, xᵢ representa cada elemento en el vector de entrada, y el denominador es la suma de los exponenciales de todos los elementos en el vector de entrada. La función softmax asegura que los valores de salida sean probabilidades que sumen 1, lo que la hace ideal para problemas de clasificación multiclase.
Elegir la Función de Activación Correcta
Elegir la función de activación adecuada depende de la tarea específica y la arquitectura del modelo. ReLU suele ser la opción por defecto debido a su eficiencia, pero la sigmoide funciona bien para la clasificación binaria, mientras que softmax es ideal para problemas multiclase.
Ninguna función de activación es universalmente la mejor; la elección debe alinearse con los objetivos de la red y los datos. Experimentar con diferentes funciones y analizar el rendimiento es crucial para optimizar las redes neuronales en términos de precisión, estabilidad y eficiencia de aprendizaje en aplicaciones de aprendizaje profundo.
Conclusión
Las funciones de activación son cruciales en las redes neuronales, añadiendo no linealidad para ayudar a reconocer patrones complejos. Son clave para tareas como el procesamiento de imágenes y la comprensión del lenguaje. Elegir la función de activación adecuada, como sigmoide, ReLU o softmax, es vital para optimizar el rendimiento del modelo. Dado que ninguna función es perfecta para cada escenario, seleccionar la adecuada mejora la precisión y eficiencia. Una función de activación bien elegida asegura que las redes neuronales puedan abordar problemas intrincados de manera efectiva, mejorando su capacidad para ofrecer resultados precisos y confiables en diversas aplicaciones.
Artículos relacionados
¿Qué es la Función de Activación en IA?
El Impacto de los GANs en la Autenticidad de los Medios
Una Guía sobre Redes Neuronales Recurrentes (RNNs) para Datos Secuenciales
¿Qué son las Redes Generativas Adversarias (GANs)?
Algoritmos de Aprendizaje Profundo: El Cerebro Detrás de la Innovación en IA
Redes Neuronales de Retropropagación: El Motor de Aprendizaje de la IA
CNNs vs. Transformadores: ¿Qué Modelo de IA Funciona Mejor para tu Tarea?
La IA y el Arte: Cómo los Algoritmos Crean Obras Maestras en el Mundo Creativo
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Comprendiendo el Impacto de la IA en la Escritura Creativa
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
