
Explorando NVIDIA NIM: Preparando el Futuro de la Inferencia de IA a Gran Escala
En esta página
La inteligencia artificial (IA) está revolucionando numerosas industrias en todo el mundo, desde la banca y el servicio al cliente hasta la salud y los vehículos autónomos. Aunque se presta mucha atención al entrenamiento de modelos de IA, la inferencia, es decir, la aplicación de estos modelos entrenados para hacer predicciones sobre nuevos datos, es lo que realmente da vida a la IA en aplicaciones del mundo real. Para los sistemas de IA que operan en tiempo real, la inferencia eficiente es crucial, especialmente cuando se escala.
Aquí es donde entra en juego NVIDIA NIM. Representa un avance significativo en la inferencia de IA escalable, proporcionando a los desarrolladores un método optimizado para desplegar modelos de IA utilizando microservicios. Con un rendimiento optimizado, modelos preentrenados plug-and-play e integración perfecta en pilas tecnológicas modernas, NIM está allanando el camino para implementaciones de IA más inteligentes y rápidas. Profundicemos en lo que hace de NVIDIA NIM un avance en este ámbito.
Inferencia de IA: El Motor Detrás de las Aplicaciones Inteligentes
Para comprender la importancia de NVIDIA NIM, es esencial entender el papel de la inferencia en el ciclo de vida de la IA. Mientras que entrenar un modelo implica alimentarlo con grandes conjuntos de datos y ajustar parámetros para minimizar errores, la inferencia es el proceso de usar ese modelo entrenado para generar resultados basados en nuevas entradas.
Aunque pueda parecer sencillo, en la práctica, la inferencia a menudo debe ser:
- Rápida: La latencia es crítica. En un coche autónomo o un sistema de detección de fraudes en tiempo real, cada milisegundo cuenta.
- Escalable: Las empresas necesitan atender a millones de usuarios o procesar vastos flujos de datos simultáneamente.
- Confiable: Los modelos de inferencia deben producir resultados precisos y consistentes independientemente de las fluctuaciones de carga o infraestructura.
NVIDIA NIM aborda estos desafíos al ofrecer un marco que combina alto rendimiento, facilidad de uso y flexibilidad para desarrolladores y organizaciones por igual.
¿Qué es NVIDIA NIM?
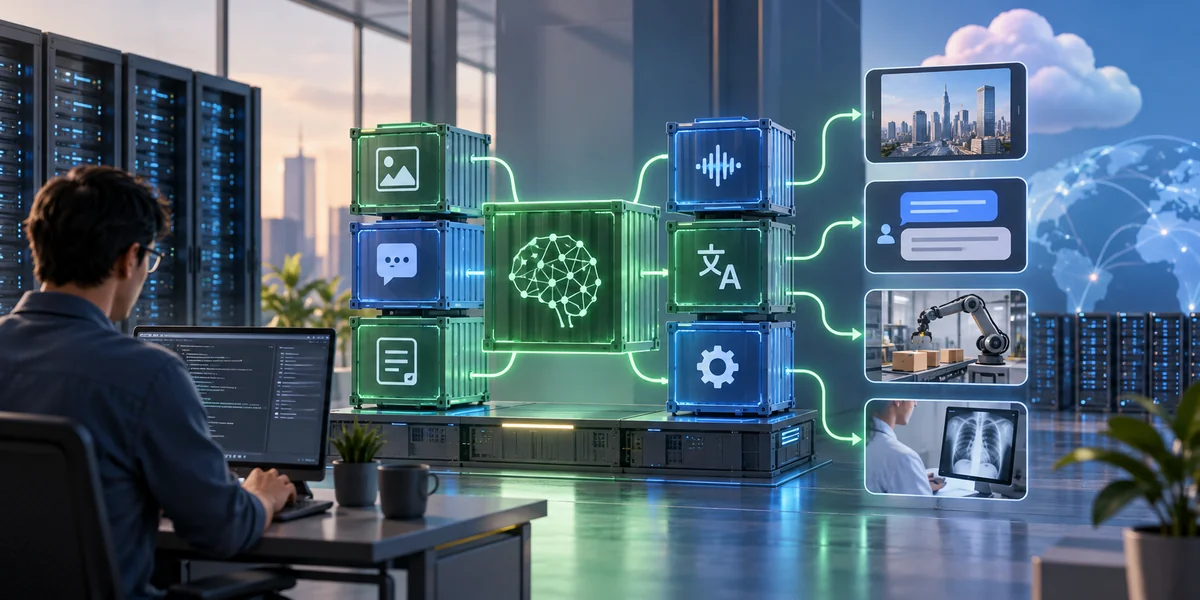
En su núcleo, NVIDIA NIM es una plataforma que empaqueta modelos de IA preentrenados en microservicios, simplificando la integración de potentes capacidades de IA en aplicaciones sin la carga de gestionar la infraestructura.
Estos microservicios son unidades ligeras e independientes que se comunican a través de APIs, lo que permite desplegarlos, escalarlos y actualizarlos de manera independiente. Este diseño se alinea con las mejores prácticas de arquitectura en la nube moderna y desbloquea ventajas significativas para el despliegue de IA.
Con NVIDIA NIM, los modelos de IA ya no son componentes monolíticos que requieren esfuerzos de ingeniería complejos para desplegar. En cambio, son servicios plug-and-play optimizados para funcionar de manera eficiente en la poderosa infraestructura GPU de NVIDIA, ya sea en la nube, en instalaciones locales o en el borde.
Características Clave de NVIDIA NIM
NVIDIA NIM es más que otro servicio de IA: es un ecosistema meticulosamente diseñado para eliminar la fricción de la inferencia de IA. Estas son algunas de las características destacadas que lo hacen una solución a prueba de futuro para el despliegue escalable:
1. Modelos Preentrenados para Uso Instantáneo
NIM incluye una biblioteca de modelos preentrenados adaptados a una amplia variedad de casos de uso, que incluyen:
- Procesamiento de Lenguaje Natural (NLP)
- Visión por Computadora
- Reconocimiento de Voz
- Generación de Texto a Imagen
- Razonamiento e IA Basada en Chat
Esto permite a los desarrolladores aprovechar instantáneamente las capacidades de IA de vanguardia sin invertir semanas o meses en entrenamiento y ajuste fino.
2. Rendimiento de Baja Latencia y Alto Rendimiento
La inferencia exige velocidad, y NIM cumple. Gracias a las tecnologías de aceleración GPU especializadas de NVIDIA, como TensorRT, los modelos desplegados a través de NIM ofrecen mínima latencia y alto rendimiento, haciéndolos adecuados para su uso en aplicaciones en tiempo real como:
- Conducción autónoma
- Asistentes de voz
- Plataformas de comercio financiero
- Moderación de contenido en vivo
La optimización detrás de NIM garantiza un rendimiento consistente incluso bajo cargas exigentes.
3. Arquitectura de Microservicios
El uso de microservicios en contenedores significa que cada modelo opera de manera independiente pero puede integrarse sin problemas con otros. Este enfoque ofrece varias ventajas:
- Escalabilidad: Escalar fácilmente componentes individuales según demanda.
- Modularidad: Combinar múltiples servicios para construir flujos de trabajo complejos.
- Aislamiento de Fallos: Si un servicio falla, los demás continúan funcionando sin interrupciones.
Esta arquitectura es ideal para empresas que buscan construir sistemas de IA robustos y flexibles sin estar atados a implementaciones monolíticas rígidas.
4. Compatibilidad Cruzada de Plataformas
Ya sea que estés implementando en la nube, en el borde o en infraestructuras híbridas, NIM ofrece la portabilidad y flexibilidad para soportar diversos escenarios de implementación. Está optimizado para trabajar con los principales proveedores de la nube, así como en dispositivos de borde con tecnología NVIDIA. Esta flexibilidad abre puertas para que los desarrolladores construyan y ejecuten soluciones de IA en entornos diversos, haciendo de NIM una plataforma verdaderamente versátil.
Cómo Usar NVIDIA NIM para Inferencia de IA
Comenzar con NIM es notablemente sencillo. Aquí te presentamos una visión general simplificada de cómo los desarrolladores pueden acceder y utilizar modelos de la plataforma:
- Regístrate e inicia sesión a través del portal de NVIDIA NIM usando tu correo electrónico.
- Selecciona un modelo preentrenado que se adapte a tu tarea (por ejemplo, razonamiento, visión o generación).
- Genera tu clave de API, que se requiere para autenticar y llamar al servicio.
La interfaz de usuario y las herramientas para desarrolladores de NIM hacen que este proceso sea accesible incluso para equipos con experiencia limitada en despliegue de IA.
Comenzando: Un Enfoque Amigable para Desarrolladores
Para comenzar a usar NVIDIA NIM, los desarrolladores solo necesitan conocimientos básicos de Python y acceso a bibliotecas estándar como requests, dotenv y una clave API de NVIDIA. Las implementaciones de muestra para tareas de texto e imagen están fácilmente disponibles en la documentación. Además, debido a que NIM está impulsado por API, se integra fácilmente con herramientas como Postman, cURL o scripts de Python, permitiendo una integración sin problemas en flujos de trabajo existentes.
Velocidad y Eficiencia: Una Combinación Ganadora
Uno de los beneficios más atractivos de NIM es la rapidez con la que puede devolver resultados. Los puntos de referencia de inferencia muestran:
- Los modelos de razonamiento responden en menos de 1 segundo
- Las tareas de generación de imágenes se completan en menos de 4 segundos
Este nivel de rendimiento es especialmente impactante en sistemas en tiempo real donde la experiencia del usuario y la eficiencia operativa están estrechamente vinculadas con la latencia.
Además, dado que NIM maneja gran parte de la complejidad del backend, como la provisión de GPU, el escalado y el enrutamiento, los desarrolladores pueden centrarse en mejorar la lógica de la aplicación, la experiencia del usuario y los resultados comerciales.
Conclusión
A medida que la IA continúa la transición de los laboratorios de investigación a los entornos de producción, el enfoque se está desplazando del entrenamiento de modelos al despliegue de modelos. Una inferencia eficiente, escalable y confiable es ahora la clave para desbloquear el potencial completo de la inteligencia artificial. NVIDIA NIM se encuentra a la vanguardia de esta transformación, proporcionando una plataforma práctica y poderosa para el despliegue de IA en tiempo real. Con sus modelos preentrenados, arquitectura de microservicios, rendimiento acelerado por GPU y amplia compatibilidad, ofrece todo lo necesario para escalar la inferencia de IA a través de industrias y casos de uso.
Artículos relacionados
Cómo UltraCamp utiliza la IA para construir conexiones reflexivas con los clientes
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Comprendiendo el Impacto de la IA en la Escritura Creativa
Guía para Principiantes sobre Probabilidad Conjunta, Marginal y Condicional
5 Acciones de IA Generativa a Vigilar para Oportunidades de Inversión en 2025
Ray: La Forma Más Inteligente de Escalar Cargas de Trabajo de IA y Aprendizaje Automático
Tecnología de Gemelos Digitales: Usos Reales, Tipos y Beneficios Clave

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
El Futuro de la IA en la Publicidad Digital
IA vs. Escritores Humanos: Pros y Contras para la Creación de Contenido
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
