
Descubre LitServe: Un Nuevo Estándar en Despliegue Escalable de Modelos de IA
En esta página
En el mundo actual impulsado por la inteligencia artificial, construir modelos robustos es solo la mitad de la batalla. El verdadero desafío surge cuando llega el momento de desplegarlos. Para empresas y desarrolladores que buscan aprovechar la IA en aplicaciones en tiempo real, el servicio de modelos es un componente crucial pero a menudo pasado por alto. No se trata solo de envolver modelos en una API; se trata de hacerlo de manera eficiente, escalable y confiable.
Los métodos tradicionales de servicio comienzan a fallar a medida que los modelos de IA se vuelven más complejos, especialmente los grandes modelos de lenguaje (LLMs) y los sistemas de visión-lenguaje que requieren más recursos. Aquí es donde LitServe realmente sobresale.
LitServe es un motor de servicio de modelos flexible y de alto rendimiento, específicamente diseñado para cargas de trabajo modernas de IA. Construido sobre FastAPI pero adaptado a las demandas específicas de IA, LitServe representa un avance significativo en la evolución del despliegue de aprendizaje automático. En esta publicación, exploraremos cómo LitServe está transformando el panorama del despliegue de IA, sus características destacadas y por qué podría ser el futuro del servicio de modelos escalables.
¿Por qué el Servicio de Modelos es Más que un Simple Punto de Acceso?
Antes de profundizar en LitServe, es importante entender qué implica realmente el servicio de modelos.
El servicio de modelos se refiere al proceso de hacer un modelo de aprendizaje automático entrenado disponible para inferencia, típicamente a través de una API. Una vez desplegado, los usuarios o aplicaciones pueden enviar datos al modelo y recibir predicciones a cambio, formando esto la columna vertebral de cualquier sistema impulsado por IA en producción.
Sin embargo, el despliegue en el mundo real viene con desafíos únicos:
- Latencia: Los usuarios esperan respuestas rápidas, especialmente en aplicaciones como chatbots, procesamiento de imágenes o sistemas de recomendación.
- Escalabilidad: El sistema debe manejar picos de tráfico sin ralentizarse o colapsar.
- Gestión de Recursos: Los modelos grandes requieren una potencia de computación significativa, a menudo involucrando GPUs o incluso configuraciones multi-GPU.
- Confiabilidad: El servidor debe permanecer consistente y receptivo bajo cargas variables.
Los marcos web tradicionales como FastAPI y Flask pueden técnicamente servir modelos, pero carecen del control detallado y las características de optimización de rendimiento necesarias para cargas de trabajo de IA. Aquí es donde LitServe se destaca.
¿Qué es LitServe?
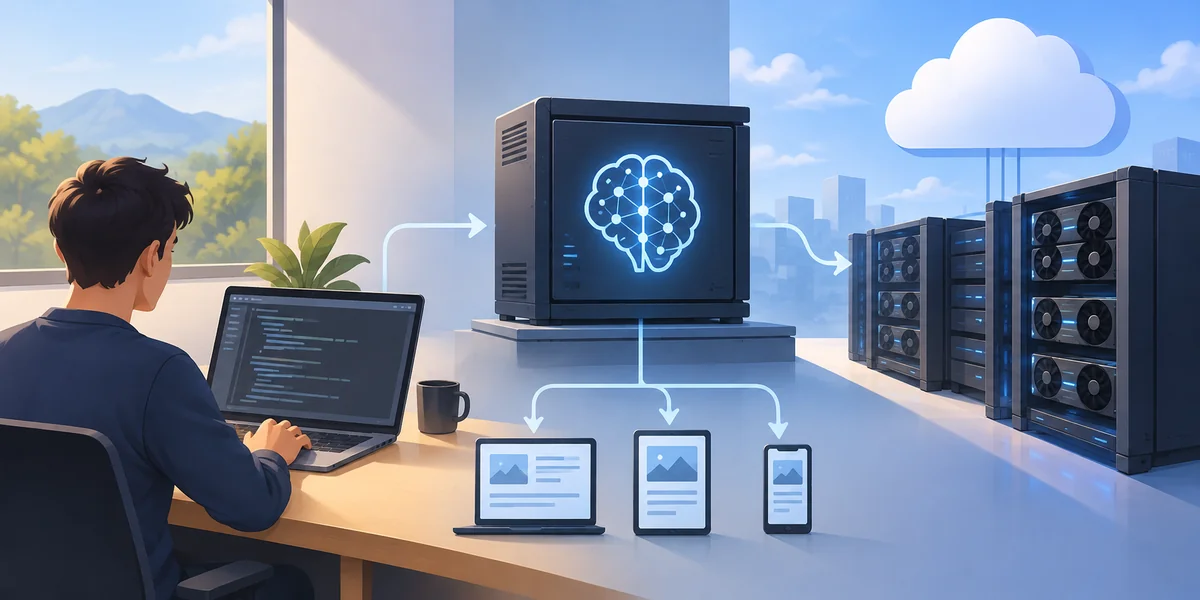
LitServe es una solución de servicio de modelos de código abierto que se basa en FastAPI pero se extiende para soportar las exigencias de aprendizaje automático en producción. Está diseñado específicamente para servir modelos de IA de manera eficiente, ya sea que estés trabajando en una computadora portátil, desplegando en infraestructura en la nube o escalando a través de múltiples GPUs. El objetivo de LitServe es simple pero ambicioso: hacer que el despliegue y la escalabilidad de modelos de IA sean sencillos mientras se ofrece el máximo rendimiento.
Diseñado para Cargas de Trabajo de IA
A diferencia de los marcos de propósito general, LitServe aborda los cuellos de botella que surgen al servir modelos, especialmente arquitecturas grandes basadas en transformadores o modelos que manejan altos volúmenes de solicitudes.
Ofrece características como batching, streaming, aceleración con GPU y escalado automático desde el principio. Más importante aún, abstrae gran parte del trabajo complejo de ingeniería típicamente involucrado en el despliegue de modelos de IA, permitiendo a los desarrolladores centrarse en la lógica del modelo en lugar de la infraestructura.
Características Clave que Diferencian a LitServe
LitServe ofrece una gama de características que atienden directamente las demandas del servicio de modelos escalables. Aquí hay algunas que realmente destacan:
Diseño Orientado a Desempeño
LitServe está optimizado para inferencia de alto rendimiento y baja latencia. Ya sea ejecutando modelos ligeros o grandes LLMs, está diseñado para servir predicciones más rápido que los métodos de servicio tradicionales al simplificar la canalización de predicción y aprovechar al máximo las capacidades asincrónicas de FastAPI.
Soporte para Multi-GPU y Aceleración de Hardware
Los modelos modernos a menudo requieren computación GPU para una velocidad de inferencia práctica. LitServe no solo soporta aceleración con GPU, sino que también se extiende a configuraciones multi-GPU, distribuyendo automáticamente cargas de trabajo a través de dispositivos para reducir cuellos de botella y acelerar tiempos de respuesta.
Batching para Eficiencia
Servir múltiples solicitudes individualmente puede llevar a cálculos redundantes. LitServe introduce el batching, que permite procesar varias solicitudes a la vez. Esto reduce la sobrecarga, mejora la utilización de recursos y mejora significativamente el rendimiento, ideal para aplicaciones con solicitudes de alta frecuencia.
Capacidades de Streaming
En escenarios donde los datos de entrada o salida son grandes, como en aplicaciones de chat o procesamiento multimedia, el streaming es crucial. El soporte de streaming de LitServe asegura que los datos se manejen en fragmentos en lugar de cargar todo en la memoria a la vez, haciéndolo adecuado para casos de uso en tiempo real.
Escalado Automático y Manejo de Carga
Otra característica destacada es la capacidad de LitServe para escalar según la demanda. Con asignación dinámica de dispositivos, los desarrolladores pueden servir modelos en diferentes configuraciones de hardware sin preocuparse por escalado manual o fallos del servidor durante picos de uso.
Integración Avanzada y Personalización
Desde capas de autenticación hasta endpoints al estilo OpenAI, LitServe ofrece opciones de personalización profunda para casos de uso avanzados. Soporta flujos de trabajo de IA complejos e incluso sistemas multimodales que combinan modelos de texto, visión o audio.
Aplicación Real: Servicio de Modelos de Visión
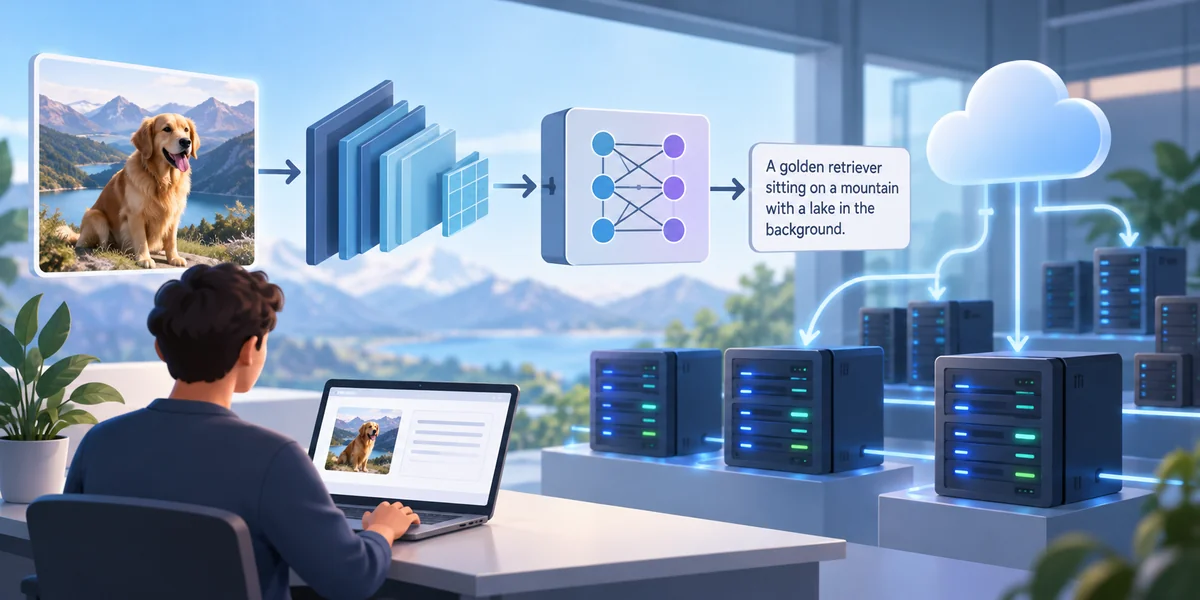
Para comprender mejor las capacidades de LitServe, consideremos un caso de uso práctico: servir un modelo de visión-lenguaje para subtitulado de imágenes. Esto implica una canalización de aprendizaje profundo donde una imagen es procesada por un codificador de visión y pasada a un decodificador de lenguaje (típicamente un transformador) para generar subtítulos descriptivos. Tales modelos, como el sistema de subtitulado de imágenes ViT-GPT2 de Hugging Face, son intensivos en computación y requieren un despliegue cuidadoso.
Con LitServe, desplegar un modelo de este tipo se vuelve sencillo. El servidor puede manejar solicitudes para describir una imagen desde un archivo local o una URL. Bajo el capó, carga el modelo, maneja el preprocesamiento de imágenes y devuelve subtítulos legibles por humanos en tiempo real, todo con aceleración GPU y manejo eficiente de solicitudes. Lo notable es que LitServe gestiona las complejidades, asignación de dispositivos, gestión de recursos, decodificación de entrada, formato de salida, para que el desarrollador no tenga que hacerlo.
Conclusión
La IA avanza a un ritmo vertiginoso, pero el despliegue a menudo sigue siendo un cuello de botella. Herramientas como LitServe están cambiando esa narrativa al proporcionar una solución robusta, escalable y amigable para desarrolladores para el servicio de modelos. Ya sea que seas un desarrollador solitario experimentando con modelos en tu computadora portátil o un equipo de ingenieros desplegando IA a escala en la nube, LitServe ofrece una plataforma unificada que maneja el trabajo pesado, para que puedas centrarte en construir grandes productos de IA.
A medida que los modelos de IA crecen y las aplicaciones se vuelven más exigentes, las herramientas que usamos para servirlos también deben evolucionar. LitServe no solo está manteniéndose al día con esta evolución, sino que la está liderando. Si estás serio sobre la IA en producción, LitServe es un nombre que querrás recordar.
Artículos relacionados

Cómo Utilizar un Generador de Voz de Marca AI para Preservar Voces Específicas de los Canales
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025

12 Recursos Principales para Construir un Marco de IA Ética

Orquestando la IA: la Transición de Actos Solitarios a una Sinfonía Completa

Cómo Utilizar Generadores de Anuncios AI para Crear Campañas Publicitarias Personalizadas 5 Veces Más Rápido

Cómo la IA Puede Ser tu Compañero en Recursos Humanos para el Reclutamiento y Compromiso de Empleados

El Centro de Llamadas con IA Ya No es un Mito, Sino una Realidad: 6 Pasos para una Implementación sin Dolor

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal
Explorando las Últimas Herramientas de IA de Google: Guía para Principiantes
¿Qué es Gemma? Explicación del modelo de IA de código abierto de Google
Tu Guía Fácil de Seguir para Flujos de Trabajo con IA Agente
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
