
Desbloqueando el Poder de la Arquitectura Lambda para Sistemas de Datos Escalables
En esta página
Entendiendo la Arquitectura Lambda: Una Guía Integral para el Procesamiento de Big Data
La arquitectura Lambda es un robusto marco de procesamiento de datos diseñado para manejar eficientemente big data al integrar el procesamiento por lotes y el procesamiento de datos en tiempo real. Esta estructura híbrida consta de tres componentes principales: la capa de lotes, que procesa conjuntos de datos masivos en lotes para mayor precisión; la capa de velocidad, que maneja datos en tiempo real para obtener conocimientos inmediatos; y la capa de servicio, que fusiona los resultados de ambas capas para facilitar las consultas.
Esta mezcla de procesamiento por lotes y en flujo permite a las empresas gestionar de manera efectiva tanto los datos históricos como los actuales, permitiéndoles aprovechar información precisa y en tiempo real. La arquitectura Lambda es tolerante a fallos, escalable y particularmente adecuada para aplicaciones que requieren tanto velocidad como precisión en el procesamiento de datos.
Los Componentes Principales de la Arquitectura Lambda
La arquitectura Lambda se construye sobre tres componentes principales: la capa de lotes, la capa de velocidad y la capa de servicio. Logra un equilibrio entre velocidad y precisión en las aplicaciones de big data.
Capa de Lotes
La capa de lotes es responsable de almacenar y procesar grandes conjuntos de datos en masa. Esta capa se centra en la precisión y exhaustividad, procesando datos que ya se han recopilado. Típicamente, el procesamiento por lotes consume tiempo, pero asegura que los datos se procesen y almacenen con precisión para futuras consultas.
Los datos en la capa de lotes generalmente se almacenan en sistemas de almacenamiento distribuido como HDFS (Hadoop Distributed File System) o almacenamiento en la nube. Se procesan periódicamente, creando un conjunto de datos maestro continuamente actualizado.
Capa de Velocidad
En contraste con la capa de lotes, la capa de velocidad está optimizada para el procesamiento instantáneo de datos en tiempo real. Procesa la información entrante y entrega resultados a velocidades casi instantáneas. Aunque prioriza la velocidad sobre la exhaustividad, la capa de velocidad proporciona a los usuarios información actualizada sin los retrasos asociados con el procesamiento por lotes.
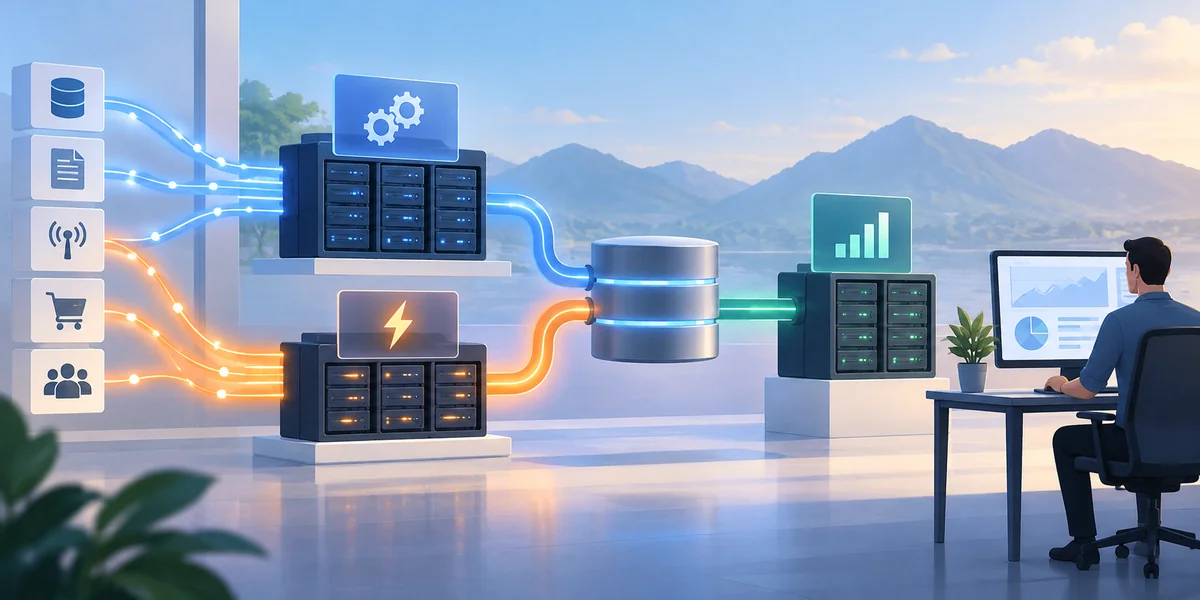
Los datos en tiempo real generalmente implican el procesamiento de eventos de sensores IoT, transacciones web o actividades de usuarios en tiempo real. La capa de velocidad procesa rápidamente estos eventos para generar conocimientos casi inmediatos, aunque posiblemente menos exhaustivos que los producidos por la capa de lotes.
Capa de Servicio
La capa de servicio actúa como la interfaz para consultar los datos procesados. Integra resultados de las capas de lotes y de velocidad, haciéndolos accesibles para los usuarios finales. Esta capa permite a las empresas consultar tanto datos históricos como en tiempo real, ofreciendo una visión completa de la información que necesitan.
Al fusionar los resultados de las capas de lotes y de velocidad, la capa de servicio garantiza que los datos siempre estén disponibles para el análisis. Ya sea que los usuarios requieran conocimientos inmediatos o una perspectiva histórica completa, la capa de servicio proporciona la flexibilidad para acceder a los datos de ambas fuentes.
¿Por Qué Elegir la Arquitectura Lambda?
La arquitectura Lambda ofrece una solución única a los desafíos que plantea el procesamiento de datos a gran escala. Su estructura híbrida permite a las empresas abordar dos preocupaciones críticas: velocidad y precisión. Aquí hay algunas razones clave por las que las organizaciones podrían optar por la arquitectura Lambda:
- Escalabilidad: La arquitectura Lambda se escala fácilmente para manejar volúmenes crecientes de datos, permitiendo a las organizaciones expandir las capacidades de procesamiento tanto para datos en tiempo real como históricos.
- Tolerancia a Fallos: Al utilizar capas separadas de lotes y velocidad, la arquitectura Lambda proporciona tolerancia a fallos. Si una capa falla, la otra continúa procesando, asegurando un procesamiento de datos confiable.
- Flexibilidad: Las empresas pueden aprovechar simultáneamente datos en tiempo real e históricos, permitiendo un análisis profundo a través de la capa de lotes y conocimientos rápidos a través de la capa de velocidad.
- Costo-Efectividad: El enfoque dual optimiza los recursos, permitiendo a las empresas escalar según sea necesario y ajustar eficientemente la potencia de procesamiento en función de las demandas de datos.
Desafíos de la Arquitectura Lambda
Aunque la arquitectura Lambda tiene sus ventajas, no está exenta de desafíos. El sistema de dos capas—lotes y velocidad—puede hacer que sea complejo de implementar y gestionar. Aquí hay algunos desafíos que las empresas pueden enfrentar:
Complejidad
Gestionar dos capas de procesamiento de datos distintas requiere una planificación y coordinación cuidadosas. Asegurar una colaboración fluida entre las capas de lotes y velocidad puede ser desafiante, y cualquier fallo en una capa puede afectar todo el sistema. Mantener este complejo sistema demanda personal y recursos calificados.
Problemas de Consistencia
Dado que la capa de lotes procesa datos en masa y la capa de velocidad procesa datos en tiempo real, pueden surgir discrepancias entre las dos capas, llevando a inconsistencias temporales. Aunque la capa de servicio intenta reconciliar estas discrepancias, lograr una consistencia perfecta puede ser difícil, especialmente en escenarios sensibles al tiempo.
Intensidad de Recursos
La arquitectura Lambda requiere recursos computacionales sustanciales para procesar tanto datos en tiempo real como por lotes. Soportar ambas capas puede ser costoso, particularmente para empresas con recursos limitados. Además, gestionar y mantener el sistema puede llevar a mayores costos operativos.
La Arquitectura Lambda en Acción
La arquitectura Lambda se aplica en diversas industrias donde el procesamiento de grandes volúmenes de datos es crucial. Algunos ejemplos incluyen:
E-Commerce
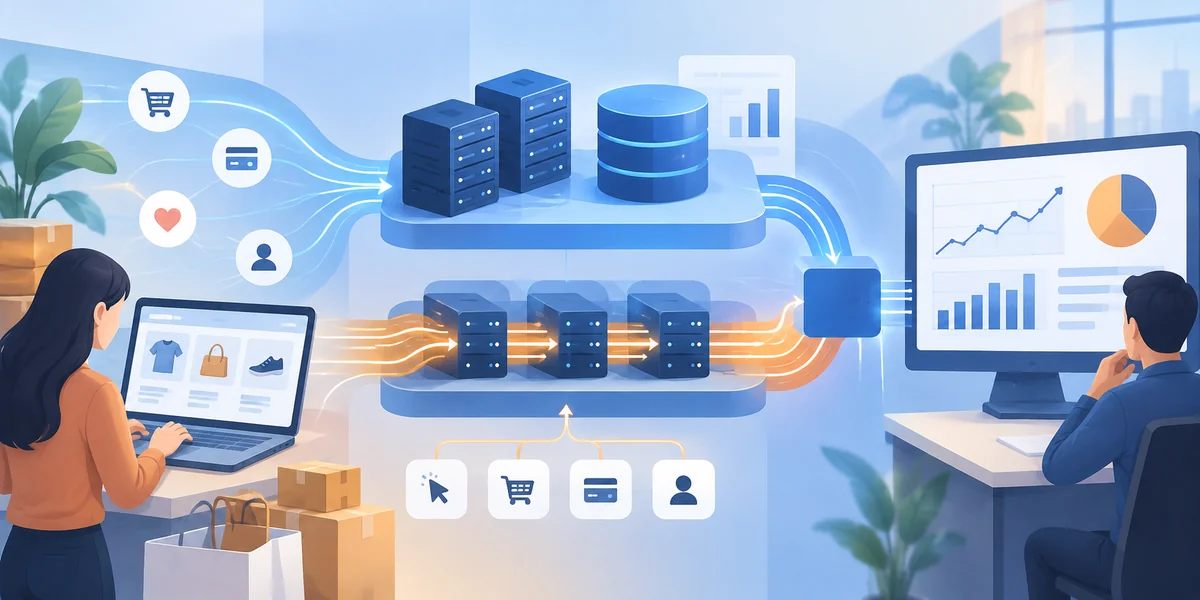
Las plataformas de e-commerce dependen de datos en tiempo real para rastrear interacciones y transacciones de usuarios. La arquitectura Lambda permite a estas plataformas analizar el comportamiento del cliente en tiempo real mientras también utilizan el procesamiento por lotes para evaluar tendencias a largo plazo y patrones de ventas.
Servicios Financieros
En finanzas, los datos en tiempo real son esenciales para monitorear los precios de las acciones, las actividades de trading y las transacciones financieras. Al combinar procesamiento por lotes y en tiempo real, la arquitectura Lambda permite tanto conocimientos inmediatos sobre los movimientos del mercado como una visión histórica completa de los datos financieros.
IoT (Internet de las Cosas)
Con millones de dispositivos IoT generando datos cada segundo, la arquitectura Lambda es ideal para procesar las vastas cantidades de información que estos dispositivos producen. La capa de velocidad procesa datos en tiempo real de los sensores, mientras que la capa de lotes agrega datos a lo largo del tiempo para proporcionar conocimientos sobre tendencias a largo plazo.
Conclusión
La arquitectura Lambda ofrece una solución poderosa para gestionar big data al combinar el procesamiento por lotes y en tiempo real. Su capacidad para ofrecer tanto velocidad como precisión la hace ideal para empresas que necesitan sistemas escalables y tolerantes a fallos. Aunque presenta desafíos en términos de complejidad y demandas de recursos, sus beneficios—como flexibilidad y escalabilidad—la convierten en una herramienta valiosa para organizaciones que manejan grandes volúmenes de datos. Para empresas que buscan conocimientos integrales y oportunos, la arquitectura Lambda resulta ser un marco invaluable.
Artículos relacionados
Gestión de la Privacidad de Datos con IA en la Creciente Era del Big Data

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas

Desempaquetando Hadoop vs. Spark: Perspectivas sobre el Procesamiento de Datos

11 Libros Que Todo Científico de Datos Debe Leer en 2025
El Impacto de los Datos Masivos en la Inteligencia Artificial y su Rol
Por Qué No Tienes Tantos Datos Como Crees. Y 3 Formas de Solucionarlo
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles
Microsoft Drasi: Herramienta de Código Abierto para la Gestión de Cambios en Tiempo Real
Comprendiendo Sus Roles Únicos: Visión Artificial o Visión por Computadora
Análisis Predictivo Potenciado por IA para Pronóstico de Demanda Energética
Pandas en Python: La Clave para una Manipulación de Datos Sin Esfuerzo
Tidyverse para Principiantes: Desbloqueando el Potencial de Ciencia de Datos de R
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
