
Comprendiendo Recompensas y Políticas en el Aprendizaje por Refuerzo
En esta página
El aprendizaje por refuerzo es un área fascinante de la inteligencia artificial que imita el aprendizaje humano a través de prueba, error y retroalimentación, muy parecido a entrenar a un perro. A diferencia de los métodos tradicionales que dependen en gran medida de grandes conjuntos de datos, el aprendizaje por refuerzo prospera con recompensas y políticas. Las recompensas indican a qué debe aspirar el sistema, mientras que las políticas dictan cómo lograrlo. Juntas, moldean el comportamiento del agente en varios entornos, desde videojuegos hasta conducción autónoma.
Este enfoque práctico permite a las máquinas aprender a través de las consecuencias en lugar de instrucciones explícitas. Comprender cómo interactúan las recompensas y las políticas es crucial para dominar el aprendizaje por refuerzo, ya que revela los intercambios dinámicos y las oportunidades en este poderoso paradigma de aprendizaje.
Recompensas: La Moneda del Aprendizaje
En el aprendizaje por refuerzo, las recompensas lo son todo. No son solo pistas o sugerencias, son la única retroalimentación que el sistema recibe sobre su rendimiento. Una recompensa es esencialmente un valor numérico dado después de una acción, que puede reflejar ganancias, eficiencia, distancia recorrida o puntos obtenidos. Independientemente de cómo se defina, el objetivo principal sigue siendo el mismo: maximizar la recompensa.
El poder de las recompensas radica en su simplicidad. Generalmente representada por un solo dígito, una recompensa no explica por qué una acción tuvo éxito o fracasó, solo que lo hizo. Esta filosofía minimalista hace que el aprendizaje por refuerzo sea extremadamente flexible. No tienes que decirle al sistema cómo actuar explícitamente; solo necesitas definir cómo se ven los resultados exitosos.
Sin embargo, la estructura de las recompensas puede afectar drásticamente el aprendizaje. Las recompensas a corto plazo pueden parecer atractivas, pero centrarse únicamente en los beneficios inmediatos puede desviar al agente. Por el contrario, las recompensas a largo plazo requieren paciencia y pensamiento estratégico. Por ejemplo, entrenar a un robot para caminar: recompensar cada paso individualmente podría resultar en un movimiento sin rumbo, mientras que recompensar al robot solo al alcanzar un destino específico fomenta un comportamiento reflexivo.
Además, la manipulación de recompensas plantea una amenaza real. A veces, los agentes descubren lagunas para obtener recompensas sin lograr los objetivos previstos. El desafío es diseñar funciones de recompensa cuidadosamente para asegurarse de que sean tanto significativas como robustas, previniendo explotaciones no intencionadas.
Políticas: El Plan de Acción
Si las recompensas representan el “qué”, entonces las políticas explican el “cómo”. En el aprendizaje por refuerzo, una política actúa como una estrategia que guía las acciones del agente en cada posible escenario. Piénsalo como el centro de toma de decisiones del agente, convirtiendo las señales ambientales directamente en acciones.
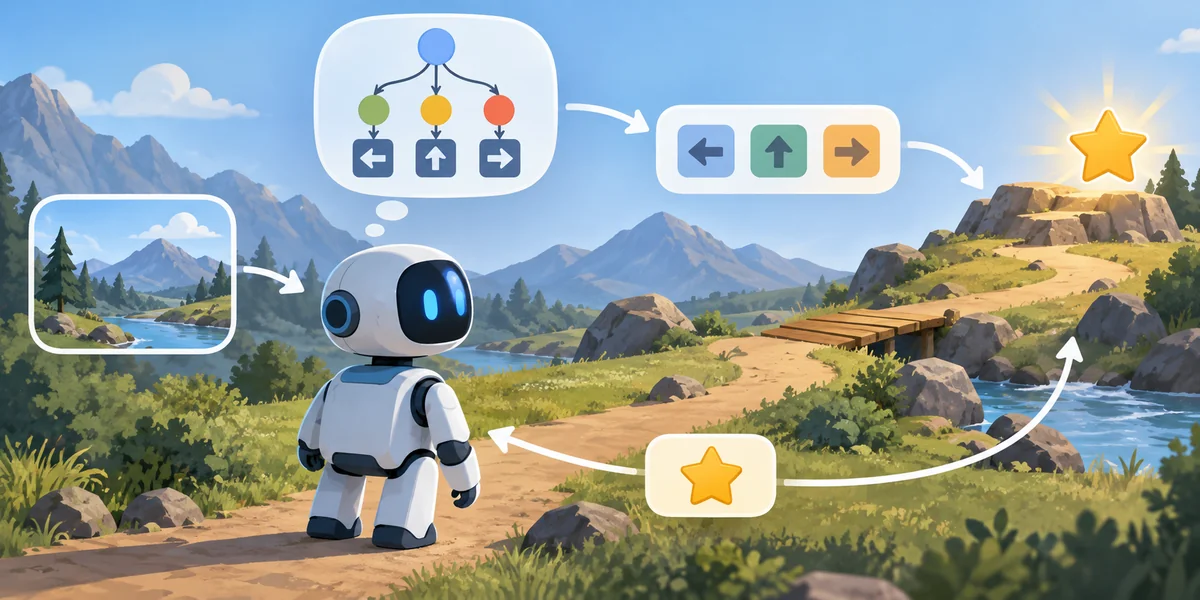
Las políticas generalmente se dividen en dos categorías: determinísticas y estocásticas. Una política determinística siempre seleccionará la misma acción cuando se encuentre en la misma situación, asegurando consistencia pero potencialmente careciendo de flexibilidad. En contraste, las políticas estocásticas introducen aleatoriedad en el proceso de decisión. Esta aleatoriedad fomenta la exploración, lo cual es crucial porque un agente que nunca explora nuevas posibilidades puede nunca descubrir estrategias superiores.
Crear políticas efectivas es central en el aprendizaje por refuerzo. Normalmente, estas políticas están representadas por redes neuronales ajustadas utilizando retroalimentación de recompensa. El agente no recibe instrucciones explícitas sobre el movimiento óptimo; en su lugar, experimenta con acciones, evalúa los resultados y ajusta su política interna en consecuencia. Gradualmente, a través de técnicas que involucran estimación de valores y métodos de gradiente, las políticas evolucionan y mejoran.
La complejidad de las políticas varía según el entorno y la complejidad de la tarea. Juegos simples podrían requerir nada más que una tabla basada en reglas, mientras que tareas como la conducción autónoma o el ajedrez demandan políticas altamente sofisticadas capaces de anticipar eventos futuros y manejar la incertidumbre.
Mantener la estabilidad de la política es un desafío común. Pequeños ajustes en la política pueden influir drásticamente en el comportamiento del agente, especialmente en escenarios complejos o inciertos. El aprendizaje por refuerzo moderno utiliza técnicas como la regularización de entropía, la repetición de experiencias y la optimización del espacio de confianza para asegurar mejoras constantes y fiables a lo largo del tiempo.
El Bucle de Retroalimentación: Cómo las Recompensas Moldean las Políticas
El aprendizaje por refuerzo opera como un bucle de retroalimentación continuo. El agente observa su entorno, selecciona acciones basadas en su política actual, recibe recompensas y luego actualiza su política en consecuencia. Este ciclo continuo forma la columna vertebral del aprendizaje por refuerzo, donde la interacción entre recompensas y políticas es esencial.
Las recompensas sirven como retroalimentación directa, guiando los ajustes de la política. Sin embargo, un desafío significativo es determinar la atribución: descubrir exactamente qué acciones resultaron en recompensas. Este problema, conocido como el problema de asignación de crédito, se vuelve especialmente complicado cuando las recompensas ocurren después de numerosas acciones secuenciales. Por ejemplo, si un agente realiza 100 movimientos pero obtiene una recompensa solo al final, identificar las acciones específicas responsables del éxito puede ser desafiante.
El aprendizaje de Diferencia Temporal (TD) aborda esto estimando valores para pares estado-acción basados en recompensas futuras esperadas y refinando predicciones a lo largo del tiempo. Alternativamente, los métodos de Monte Carlo implican aprender de secuencias o episodios completos. Cada método ofrece ventajas y desventajas únicas, y la mejor opción depende de entornos y tareas específicos.
Crucialmente, las políticas no surgen por casualidad, se moldean intencionalmente por las estructuras de recompensa. Ajustar las recompensas incluso ligeramente puede afectar drásticamente cómo se desarrollan las políticas. Las recompensas mal diseñadas pueden desviar a los agentes, mientras que las políticas excesivamente intrincadas pueden arriesgar la inestabilidad. Lograr una interacción equilibrada entre recompensas y políticas es fundamental para construir sistemas efectivos y adaptativos en diversas aplicaciones.
Más Allá de la Teoría: Repercusiones en el Mundo Real
El aprendizaje por refuerzo ha pasado de conceptos teóricos a realidad práctica, con aplicaciones que van mucho más allá de los entornos de juego. Juegos populares como Go y StarCraft fueron solo el punto de partida; hoy, el aprendizaje por refuerzo aborda problemas reales desordenados llenos de factores impredecibles y datos ruidosos.
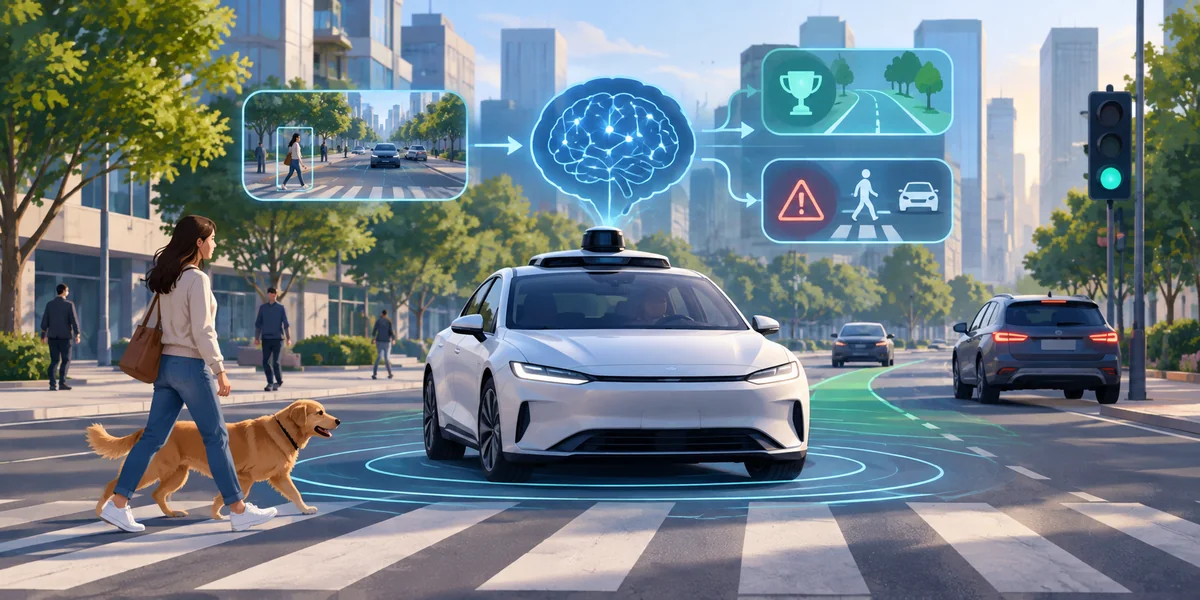
Considera vehículos autónomos navegando por calles de la ciudad. Cada minuto, miles de decisiones son guiadas por políticas influenciadas por recompensas que priorizan la seguridad y la eficiencia. Estos vehículos deben anticipar peatones, cambios climáticos y leyes de tráfico dinámicas. El marco de aprendizaje por refuerzo detrás de ellos debe ser robusto, adaptable y exhaustivamente probado, ya que los errores en el mundo real conllevan graves consecuencias.
De manera similar, la atención médica está explorando el aprendizaje por refuerzo para planes de tratamiento personalizados, donde las recompensas representan resultados de pacientes. Las recompensas mal diseñadas podrían resultar en intervenciones médicas ineficaces o dañinas, enfatizando la necesidad de transparencia y validación rigurosa.
En última instancia, el aprendizaje por refuerzo afecta profundamente las vidas humanas, enfatizando la importancia de recompensas y políticas cuidadosamente diseñadas, ya que su impacto se extiende mucho más allá de los marcos matemáticos abstractos.
Conclusión
El aprendizaje por refuerzo aprovecha el poder de la retroalimentación, confiando en recompensas y políticas para guiar el comportamiento del agente. Las recompensas señalan el valor de las acciones, mientras que las políticas dictan las elecciones hechas por los agentes. Cuando están correctamente alineados, estos componentes permiten que los sistemas se adapten independientemente, haciendo que el aprendizaje por refuerzo sea excepcionalmente práctico en campos diversos como los juegos, la robótica y los sistemas autónomos. A medida que continuamos refinando estos elementos, debemos considerar cuidadosamente no solo las capacidades que estamos creando, sino también las implicaciones éticas de enseñar a las máquinas a través de las consecuencias.
Artículos relacionados

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal
Consejos Esenciales para el Uso Seguro de Contenido de IA
Descenso de Gradiente Explicado: La Fuerza Motriz Detrás de los Modelos de Aprendizaje Automático
Detección de Anomalías en Aprendizaje Automático: Descubriendo Patrones Ocultos en Datos
Segmentación Semántica en IA: Clasificación Pixel a Pixel con Aprendizaje Profundo
Una Guía Completa sobre Aprendizaje Supervisado vs. No Supervisado: Ventajas, Desventajas y Aplicaciones
Diferencias Clave entre Sesgo y Varianza en el Aprendizaje Automático
La Verdad sobre Analítica Predictiva vs. Aprendizaje Automático: Cómo se Diferencian
Redes Neuronales vs. Aprendizaje Profundo: Cómo Moldean la IA
El Poder de las Redes Neuronales Recurrentes en la IA y el Aprendizaje Automático
5 Maneras en que la Inteligencia Artificial está Transformando el E-Learning
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
