
Segmentación Semántica en IA: Clasificación Pixel a Pixel con Aprendizaje Profundo
En esta página
Entender cómo las máquinas perciben el mundo es uno de los desafíos fundamentales en la inteligencia artificial. En los últimos años, el aprendizaje profundo ha avanzado enormemente en la capacidad de las computadoras para interpretar imágenes con notable precisión. Una de las técnicas más avanzadas en este campo es la segmentación semántica, que permite a las máquinas no solo detectar objetos, sino también clasificar cada píxel en una imagen.
Esta capacidad juega un papel crucial en aplicaciones como la imagen médica, los coches autónomos y la realidad aumentada. Aunque el concepto puede parecer complejo, su funcionamiento puede desglosarse en pasos fundamentales.
Fundamentos de la Segmentación Semántica
La segmentación semántica es una parte de la visión por computadora donde cada píxel de una imagen se etiqueta según la categoría a la que pertenece. A diferencia de la detección de objetos, donde se dibujan cuadros delimitadores sobre los objetos, la segmentación semántica muestra un nivel de detalle mucho más alto, ya que cada píxel se asigna a una clase. Por ejemplo, en una imagen de una escena callejera, este método puede identificar coches, peatones, carreteras y edificios al etiquetar adecuadamente cada región de la imagen.
Este nivel de precisión es esencial en muchos campos. En la imagen médica, ayuda a los médicos a distinguir y localizar órganos y posibles tumores en las exploraciones. Para los coches autónomos, permite a los vehículos comprender su entorno al detectar marcas viales, obstáculos y peatones. El concepto de segmentación semántica es sencillo: segmentar una imagen en sus partes más relevantes y etiquetar correctamente cada área.
En el centro de este proceso se encuentra una forma de red neuronal artificial llamada red neuronal convolucional (CNN). Las CNN están diseñadas específicamente para identificar patrones y extraer características en imágenes, lo que las hace adecuadas para tareas de segmentación. Sin embargo, las CNN estándar requieren algunos ajustes para manejar la clasificación pixel a pixel, lo que lleva a arquitecturas especializadas para la segmentación semántica.
Segmentación Semántica vs. Otras Técnicas de Visión por Computadora
| Técnica | Salida | Caso de Uso | Nivel de Precisión |
|---|---|---|---|
| Clasificación de Imágenes | Etiqueta de imagen completa | Detección “Gato vs Perro” | Baja |
| Detección de Objetos | Cuadros delimitadores | Seguimiento de inventario | Media |
| Segmentación Semántica | Etiquetas pixel a pixel | Mapeo de límites de tumores | Alta |
| Segmentación de Instancias | Etiquetas de píxeles + conteo | Análisis de multitudes | Más alta |
Cómo Funciona la Segmentación Semántica
La segmentación semántica pasa por una serie de pasos que convierten una imagen de entrada en una salida que está clasificada a nivel de píxel. Esto comienza con la extracción de características, donde las capas convolucionales en una Red Neuronal Convolucional (CNN) identifican características prominentes como bordes, texturas y formas en una imagen. Dichas características extraídas facilitan que el modelo comprenda los objetos en la imagen. Las características se vuelven más abstractas a medida que la red se profundiza, facilitando la comprensión.
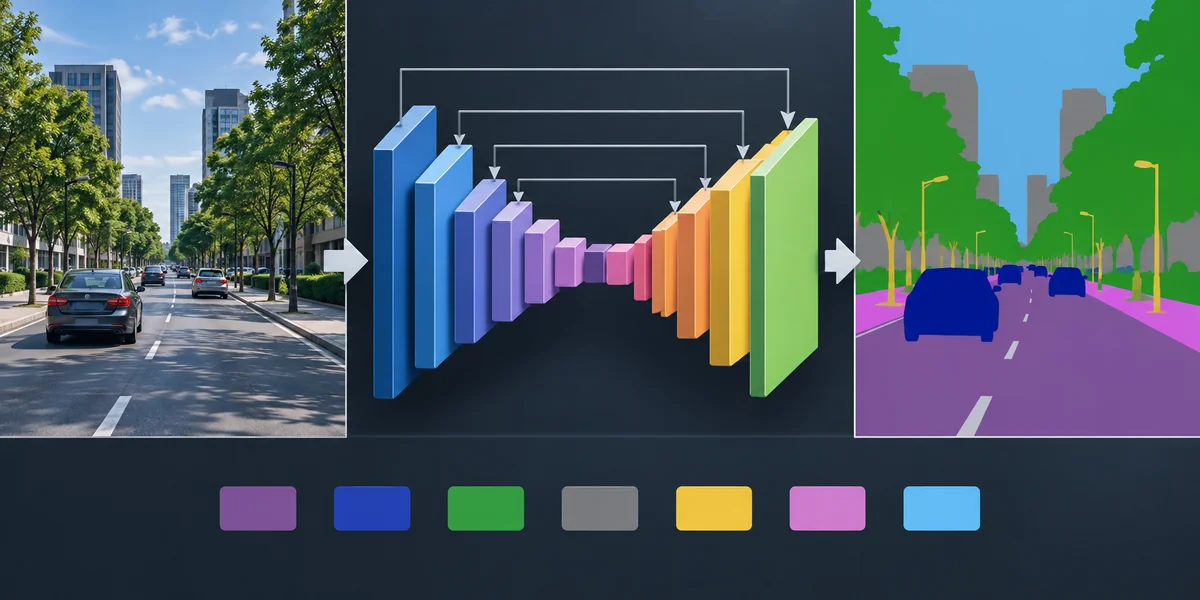
Luego, la fase de clasificación asigna una etiqueta a cada píxel de la imagen. A diferencia de las CNN tradicionales que terminan con una capa completamente conectada, las Redes Completamente Convolucionales (FCN) utilizan capas convolucionales a lo largo de la red, preservando la información espacial. Esto permite al modelo generar un mapa de clasificación pixel a pixel, ofreciendo detalles más finos que un enfoque simple de detección de objetos.
Para mejorar la precisión, los modelos de segmentación utilizan conexiones de salto para retener detalles finos de diferentes capas. Sin estas conexiones, los elementos importantes podrían perderse, resultando en una segmentación borrosa o imprecisa. La arquitectura encoder-decoder es otra herramienta útil. En esta arquitectura, el codificador reduce el tamaño de la imagen mientras mantiene patrones importantes, y el decodificador aumenta las características para reconstruir la imagen a su resolución original.
Finalmente, las técnicas de post-procesamiento como los Campos Aleatorios Condicionales (CRF) suavizan las predicciones, asegurando que los píxeles vecinos del mismo objeto se clasifiquen de manera consistente. Este paso es vital para lograr límites de segmentación nítidos y precisos, lo cual es crucial para aplicaciones del mundo real.
Aplicaciones y Desafíos
La segmentación semántica ha encontrado un uso generalizado en múltiples industrias, resolviendo problemas que requieren una comprensión detallada de escenas. En el cuidado de la salud, juega un papel vital en la imagen médica, donde ayuda a segmentar órganos, tejidos y anomalías en radiografías, resonancias magnéticas y tomografías computarizadas. La segmentación precisa ayuda en el diagnóstico, la planificación del tratamiento y la navegación quirúrgica.
La industria automotriz depende en gran medida de la segmentación para la conducción autónoma. Los coches autónomos utilizan la segmentación para detectar carriles, señales de tráfico, vehículos y peatones, lo que les permite tomar decisiones de conducción seguras. Sin segmentación precisa, estos vehículos tendrían dificultades para navegar por las carreteras de manera confiable.
Otro campo que se beneficia de esta tecnología es la agricultura, donde la segmentación ayuda a analizar imágenes satelitales y grabaciones de drones. Al clasificar diferentes tipos de terrenos, cultivos y cuerpos de agua, los agricultores pueden optimizar más eficazmente el uso de la tierra y monitorear la salud de las plantas.
Sin embargo, a pesar de su éxito, la segmentación semántica presenta desafíos. Una gran dificultad es el costo computacional. Los modelos de aprendizaje profundo requieren un poder de procesamiento inmenso, especialmente para imágenes de alta resolución. Entrenar grandes redes de segmentación demanda GPUs con significativa memoria y capacidad computacional.
Otro desafío es la anotación de datos. A diferencia de las tareas de clasificación regular donde etiquetar una imagen es sencillo, la segmentación requiere anotaciones a nivel de píxel, lo cual es laborioso y costoso. Crear conjuntos de datos de alta calidad para entrenar modelos sigue siendo un cuello de botella en el campo.
Además, los modelos de segmentación a veces luchan con el desequilibrio de clases. En muchas imágenes, ciertos objetos dominan mientras que otros son raros, lo que lleva a predicciones deficientes para clases menos comunes. Técnicas como las funciones de pérdida ponderada y la aumentación de datos ayudan a abordar este problema, pero sigue siendo un desafío persistente.
Desafíos Actuales & Soluciones
| Desafío | Solución | Impacto |
|---|---|---|
| Alto Costo Computacional | MobileNetV3 (75% más ligero) | Permite aplicaciones en tiempo real |
| Costos de Anotación | SAM (Segment Anything de Meta) | Reduce el tiempo de etiquetado en un 70% |
| Desequilibrio de Clases | Pérdida Focal | Mejora detección de clases raras 4x |
| Casos Extremos | Datos Sintéticos (GANs) | Cubre el 98% de escenarios de manejo |
El Futuro de la Segmentación Semántica
El futuro de la segmentación semántica es prometedor, con continuos avances en arquitecturas de modelos y técnicas de entrenamiento. Un desarrollo emocionante es la integración de modelos basados en transformadores, como los Transformers de Visión (ViTs), que capturan dependencias de largo alcance más eficazmente que las CNN tradicionales. Además, el aprendizaje semi-supervisado y no supervisado está ganando terreno, permitiendo que los modelos aprendan de datos no etiquetados y reduzcan la dependencia de anotaciones manuales.
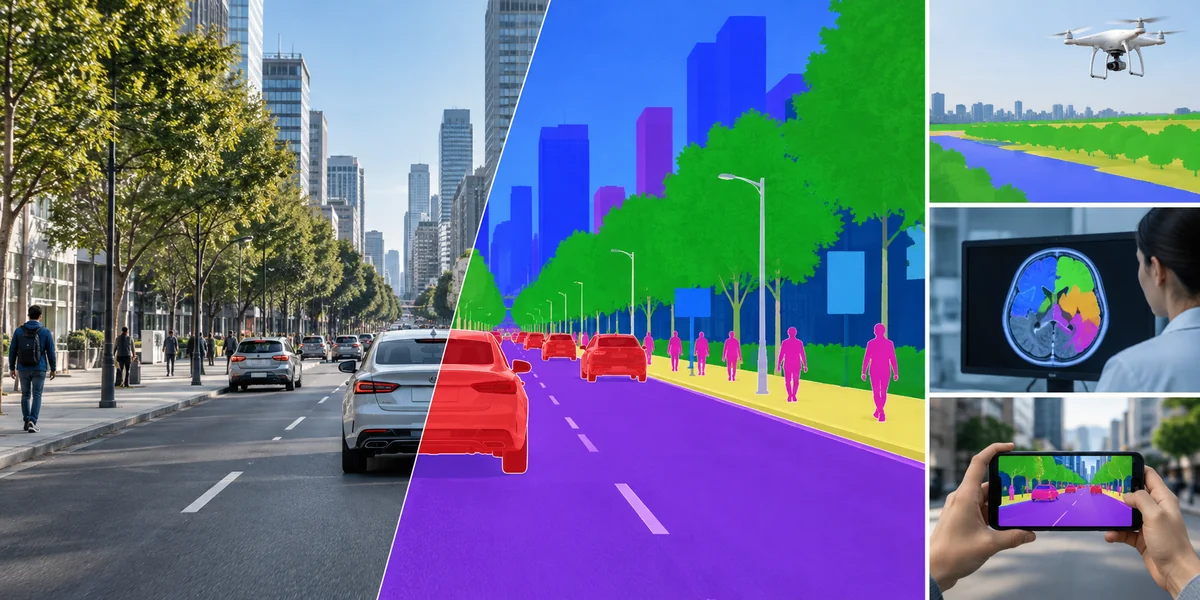
La computación en el borde también está transformando el campo, permitiendo aplicaciones en tiempo real como la realidad aumentada y la IA móvil para realizar tareas de segmentación de manera eficiente en dispositivos como teléfonos inteligentes y drones. A medida que la IA evoluciona, la segmentación semántica jugará un papel crucial en áreas como el cuidado de la salud y la conducción autónoma, con investigaciones en curso que empujan los límites de lo que las máquinas pueden comprender a nivel de píxel.
Conclusión
La segmentación semántica es una técnica poderosa en visión por computadora que permite a las máquinas clasificar cada píxel en una imagen para una comprensión detallada de la escena. A pesar de desafíos como altas demandas computacionales y anotación de datos, los avances en modelos de transformadores, aprendizaje auto-supervisado y computación en el borde están impulsando el progreso. A medida que la IA mejora, la segmentación semántica se volverá más eficiente, transformando industrias como el cuidado de la salud, la conducción autónoma y la agricultura. Esta tecnología está remodelando cómo las máquinas interactúan con el mundo, desbloqueando nuevas posibilidades para la toma de decisiones inteligentes y la automatización.
Artículos relacionados
Cómo se Diferencian la Segmentación Semántica y la Segmentación de Instancias en Visión por Computadora
Cómo Usar la Visión por Computadora en el Deporte
Comprendiendo Sus Roles Únicos: Visión Artificial o Visión por Computadora
Redes Neuronales vs. Aprendizaje Profundo: Cómo Moldean la IA
El Poder de las Redes Neuronales Recurrentes en la IA y el Aprendizaje Automático
El Poder del Procesamiento de Imágenes: Cómo Transforma los Datos Digitales
10 Conceptos Críticos de IA Explicados en 5 Minutos
Una Guía Completa sobre Aprendizaje Supervisado vs. No Supervisado: Ventajas, Desventajas y Aplicaciones
Desbloqueando el Poder de la Arquitectura Lambda para Sistemas de Datos Escalables
Diferencias Clave entre Sesgo y Varianza en el Aprendizaje Automático
La Verdad sobre Analítica Predictiva vs. Aprendizaje Automático: Cómo se Diferencian
Redes Neuronales: Los Bloques Fundamentales de la IA
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
