
K-Means Clustering: El Algoritmo de Referencia para la Segmentación de Datos
En esta página
Los datos están omnipresentes y descifrarlos puede ser desalentador. K-Means clustering, un algoritmo de aprendizaje automático prevalente, facilita este proceso agrupando puntos de datos similares en clusters, revelando así patrones ocultos. Como una técnica fundamental en la agrupación de datos, K-Means encuentra aplicaciones en diversos campos como el marketing, la salud y el reconocimiento de imágenes, permitiendo la organización eficiente de conjuntos de datos complejos. A diferencia del aprendizaje supervisado, K-Means no requiere datos etiquetados, lo que lo hace ideal para escenarios de aprendizaje no supervisado.
Ya sea segmentando clientes, detectando fraudes o simplificando el procesamiento de imágenes, K-Means juega un papel crucial en la toma de decisiones basada en datos. Comprender su funcionamiento empodera a las empresas e investigadores para extraer conocimientos significativos de información aparentemente caótica.
¿Cómo Funciona K-Means Clustering?
K-Means clustering opera mediante un procedimiento sistemático de dividir datos en K grupos. El proceso se itera para mejorar la agrupación de los puntos de datos. Aquí hay una guía paso a paso sobre cómo funciona:
Elegir K Clusters: El usuario especifica el número de clusters (K) antes de ejecutar el algoritmo. Seleccionar el K adecuado es crucial ya que determina la partición de los datos.
Colocación de Centroides Iniciales: El algoritmo selecciona aleatoriamente K puntos para servir como los centros iniciales de los clusters, conocidos como centroides.
Asignación de Puntos de Datos: Cada punto de datos se asigna al centrod más cercano usando una métrica de distancia, típicamente la distancia euclidiana.
Recalcular Centroides: Una vez que los puntos de datos están agrupados, los centroides se recalculan a la posición media de todos los puntos dentro de un cluster.
Repetir el Proceso: Se repiten los pasos 3 y 4 hasta que los centroides se estabilicen o se alcance un número predefinido de iteraciones.
Este enfoque iterativo asegura que los clusters se vuelvan más refinados con cada ciclo, agrupando puntos de datos similares en clusters distintos. Sin embargo, determinar el valor óptimo para K puede ser un desafío.
Elegir el Número Correcto de Clusters
Determinar el número óptimo de clusters es un desafío común con K-Means clustering. El método del codo es una técnica popular para este fin. Involucra ejecutar el algoritmo con varios valores de K y graficar la suma total de distancias cuadradas entre los puntos de datos y sus centroides asignados. El punto de "codo" en el gráfico, donde la tasa de reducción de error se ralentiza, generalmente indica el K ideal.
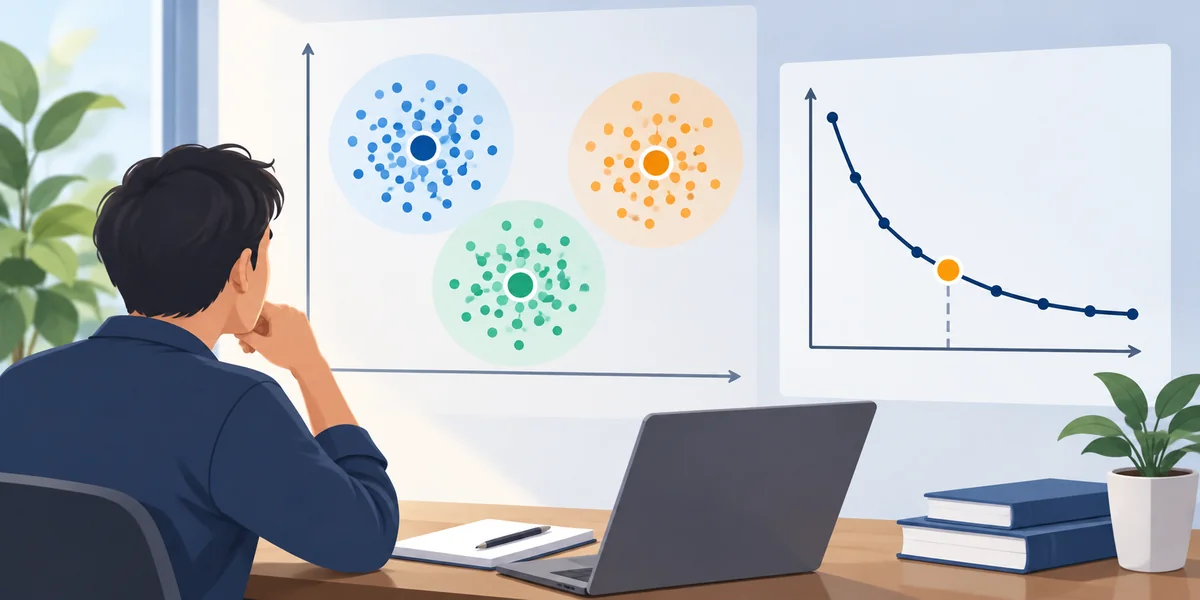
Otro método es el puntaje de silueta, que evalúa qué tan bien encaja cada punto de datos dentro de su cluster en comparación con otros clusters. Un puntaje de silueta más alto indica una estructura de agrupamiento mejor definida.
Aunque estas técnicas son útiles, las aplicaciones del mundo real pueden requerir experimentar con diferentes valores de K para identificar el número más adecuado para una agrupación de datos precisa.
Aplicaciones de K-Means Clustering
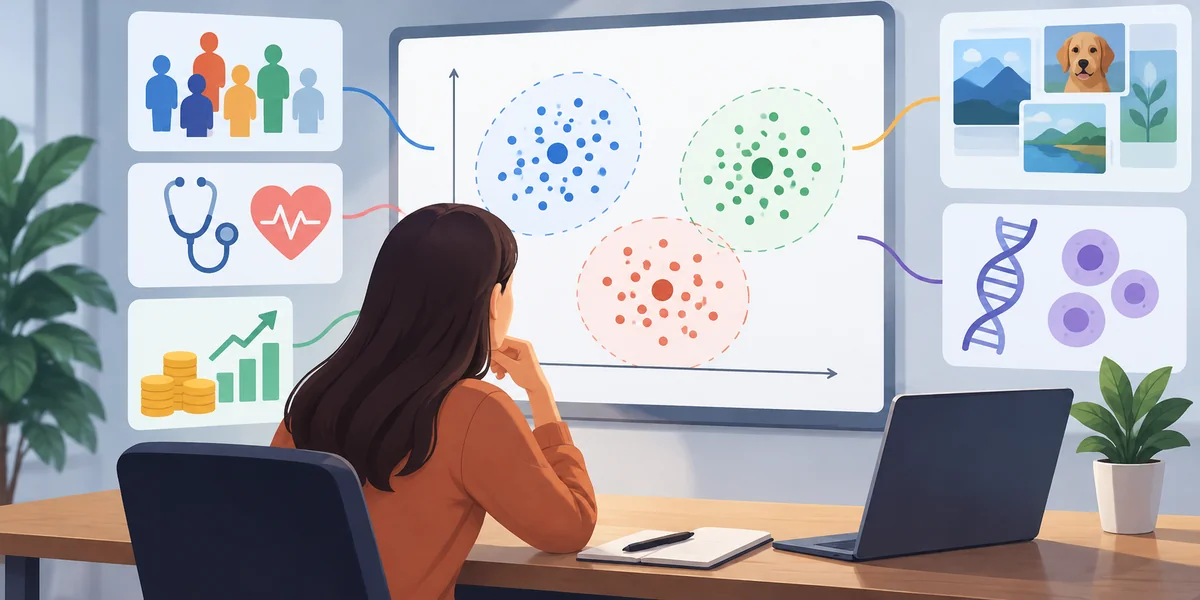
K-Means clustering cuenta con numerosas aplicaciones en varias industrias debido a su capacidad para manejar eficientemente grandes conjuntos de datos.
Segmentación de Clientes
Las empresas utilizan K-Means clustering para el análisis de mercado dividiendo a los clientes en grupos distintos basados en hábitos de compra, demografía o comportamiento en línea. Esto permite estrategias de marketing dirigidas, recomendaciones personalizadas y experiencias mejoradas para los clientes.
Segmentación y Compresión de Imágenes
K-Means clustering se utiliza extensamente en el procesamiento de imágenes, particularmente para la segmentación y compresión. Agrupando píxeles con propiedades de color similares, el algoritmo reduce el número de colores únicos en una imagen, llevando a un almacenamiento eficiente y un procesamiento más rápido. Esta técnica también es invaluable en imágenes médicas, ayudando en la detección de tumores, clasificación de tejidos y resaltado de anomalías en radiografías y escáneres MRI.
Detección de Anomalías en Finanzas y Ciberseguridad
En el sector financiero, K-Means clustering ayuda en la detección de fraude al identificar patrones de gasto inusuales o transacciones sospechosas. Dado que el fraude a menudo se desvía del comportamiento normal de las transacciones, el clustering resalta inconsistencias que requieren una mayor investigación. De manera similar, en ciberseguridad, K-Means detecta anomalías en la red al agrupar patrones de tráfico normales y señalando outliers que pueden indicar brechas de seguridad.
Análisis de Expresión Génica en Biología
Los científicos utilizan K-Means clustering para clasificar datos de expresión génica, agrupando comportamientos génicos similares. Esta técnica ayuda a identificar diferentes tipos de células, rastrear la progresión de enfermedades y categorizar trastornos genéticos.
Estas aplicaciones demuestran cómo K-Means clustering trasciende el análisis básico de clusters, ofreciendo conocimientos valiosos que impulsan la innovación en diversas industrias.
Fortalezas y Limitaciones de K-Means Clustering
K-Means clustering es favorecido por su eficiencia y simplicidad, pero también presenta ciertas limitaciones.
Ventajas
Rápido y Escalable: K-Means clustering maneja eficientemente grandes conjuntos de datos, lo que lo hace ideal para aplicaciones en tiempo real.
Fácil de Implementar: En comparación con otros algoritmos de aprendizaje automático, K-Means es sencillo y requiere recursos computacionales mínimos.
Versátil: Su amplio rango de aplicaciones en marketing, salud, finanzas y procesamiento de imágenes lo convierte en una opción popular en diversas industrias.
Desafíos
Valor K Predefinido: La necesidad de especificar el número de clusters antes de ejecutar el algoritmo puede ser una limitación, especialmente cuando el K óptimo es desconocido.
Sensibilidad a Outliers: Puntos de datos extremos pueden alterar significativamente los centroides del cluster, distorsionando las formaciones de grupo y reduciendo la precisión, haciendo a K-Means clustering sensible a outliers en conjuntos de datos del mundo real.
Asunción de Clusters Esféricos: K-Means funciona bien con clusters esféricos y de tamaño igual. Para clusters irregulares o superpuestos, métodos como DBSCAN o clustering jerárquico son más adecuados.
A pesar de estas limitaciones, K-Means sigue siendo una técnica de clustering fundamental. Estrategias como la inicialización K-Means++ pueden mejorar su precisión optimizando la selección de centroides.
Conclusión
K-Means clustering simplifica la compleja tarea de organizar datos, siendo un algoritmo de aprendizaje automático fundamental en diversas industrias. Al agrupar puntos de datos similares, ayuda a las empresas a refinar estrategias de marketing, mejorar la agrupación de datos en el procesamiento de imágenes y ayudar en la detección de fraudes. Su velocidad y eficiencia lo convierten en una opción preferida para grandes conjuntos de datos, aunque su sensibilidad a outliers y números de cluster predefinidos plantean desafíos. A pesar de estas limitaciones, K-Means sigue siendo una herramienta poderosa para descubrir patrones en datos brutos. A medida que la tecnología avanza, técnicas de clustering como K-Means continuarán moldeando la toma de decisiones basada en datos, ofreciendo conocimientos valiosos en múltiples campos.
Artículos relacionados
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
Desvelando la Búsqueda por Haz y su Importancia en el Aprendizaje Automático Moderno
Técnicas de Procesamiento de Lenguaje Natural: El Futuro de la Comunicación en IA
Conceptos de Aprendizaje Automático Explicados: El Futuro de la Inteligencia Financiera
Tensores Descubiertos: Conceptos Clave y Aplicaciones en IA y Aprendizaje Automático
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Aprendizaje Automático: Modelos Listos para Usar o Personalizados - Pros y Contras
Recall vs. Precisión: Comprendiendo las Diferencias Clave
Herramientas de Aprendizaje Automático
Aprendizaje Zero-Shot: Cómo la IA Reconoce lo Desconocido Sin Datos de Entrenamiento
Máquinas de Vectores de Soporte (SVM): Cómo Impulsan los Modelos de Aprendizaje Automático
Comprendiendo Sus Roles Únicos: Visión Artificial o Visión por Computadora
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
