
Comprendiendo los Datos Nominales: La Base del Pensamiento Categórico
En esta página
No todos los datos útiles vienen en forma de números. Algunas de las percepciones más significativas provienen de etiquetas, como el color de tu coche, tu ciudad natal o tu fruta favorita. Estos no son cantidades que puedas clasificar o promediar, pero aún así importan. Estos son datos nominales: datos basados en nombres, no en números. Están en todas partes, moldeando silenciosamente cómo clasificamos, agrupamos y entendemos la información.
En campos como la inteligencia artificial, el marketing y la salud, los datos nominales ayudan a organizar las elecciones humanas en categorías claras. Los datos nominales no reflejan valor, sino identidad. Y en un mundo construido sobre la personalización y los patrones, la identidad lo es todo. Vamos a desglosar qué los hace tan esenciales.
Comprendiendo los Fundamentos de los Datos Nominales
Los datos nominales son uno de los tipos más básicos de datos utilizados en estadísticas y ciencia de datos. La palabra "nominal" proviene del latín "nomen", que significa "nombre". Este tipo de datos no involucra números o clasificaciones, simplemente utiliza etiquetas para nombrar diferentes categorías. Por ejemplo, los colores de ojos como azul, marrón y verde son todos valores nominales. No hay un orden lógico entre ellos; son solo identificadores distintos.
Lo que separa los datos nominales de los ordinales es la ausencia de una secuencia. Con los datos ordinales, puedes clasificar elementos, como calificar una película de una a cinco estrellas. Pero en los datos nominales, no hay "mayor que" o "menor que". Cada categoría existe de manera aislada sin una jerarquía inherente.
A menudo encontrarás datos nominales en lugares que requieren clasificación sin juicio. Cosas como opciones de género en un formulario, etiquetas de partidos políticos o tipos de mascotas son ejemplos típicos. Ayudan a organizar personas o elementos en grupos significativos.
En el mundo de la inteligencia artificial y el aprendizaje automático, los datos nominales son clave para las tareas de clasificación. Ayudan a los sistemas a reconocer categorías basadas en características compartidas. Sin esta forma simple de etiquetado, sería mucho más difícil clasificar, agrupar y analizar la información de manera efectiva.
¿Cómo Funcionan los Datos Nominales en Contextos Estadísticos y de IA?
En estadística, el primer paso para manejar datos nominales suele ser la codificación. Dado que el software y los algoritmos no pueden procesar directamente etiquetas de texto, estos valores se traducen en números. Por ejemplo, etiquetas como "gato", "perro" y "pájaro" podrían convertirse en 1, 2 y 3. Pero estos números no están clasificados, son solo identificadores. El verdadero riesgo radica en interpretar erróneamente estos códigos como datos ordenados, lo que puede introducir sesgos si no se aborda adecuadamente.
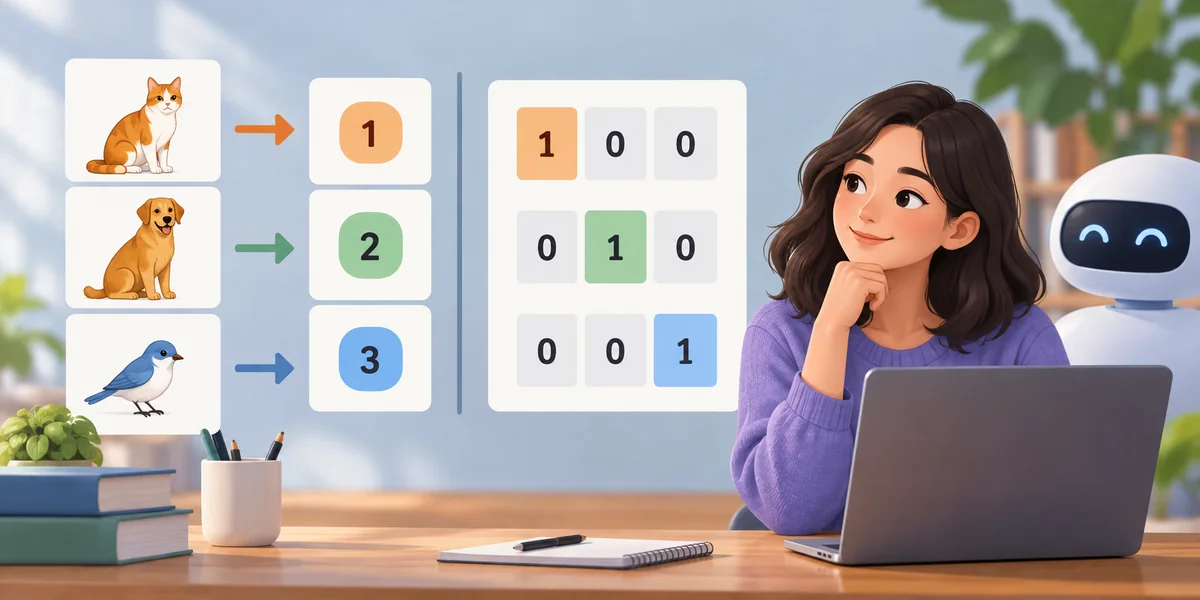
Esto se vuelve especialmente importante en la inteligencia artificial. Muchos algoritmos están diseñados para interpretar entradas numéricas como si tuvieran algún tipo de relación. Ahí es donde entran las estrategias de codificación. La codificación one-hot, por ejemplo, convierte cada etiqueta en una variable binaria separada. Así, en lugar de malinterpretar relaciones, el modelo ve cada categoría como independiente. Es una técnica simple que mantiene los datos limpios y el análisis confiable.
Los datos nominales también son una parte crítica de muchos modelos de aprendizaje automático. En un sistema de predicción de abandono, características como "tipo de contrato" o "método de pago" no tienen peso numérico, pero revelan patrones de comportamiento. Estos conocimientos a menudo guían las decisiones del modelo.
Sin embargo, no todos los algoritmos manejan bien los datos nominales. Métodos de agrupamiento como K-means se basan en cálculos de distancia, que no se aplican a este tipo de datos. Sin un manejo o transformación adecuados, tales modelos pueden producir resultados defectuosos, haciendo vital respetar la estructura única de los datos nominales en cualquier análisis.
Aplicaciones Reales de los Datos Nominales
Los datos nominales están a nuestro alrededor. En marketing, ayudan a clasificar a los clientes por preferencias de marca o colores favoritos, detalles no numéricos que guían estrategias dirigidas. En el ámbito de la salud, se ven en categorías como género, tipo de sangre o enfermedades, ayudando en el diagnóstico y tratamiento. Aunque no son numéricos, estas etiquetas organizan la información de maneras que son vitales para el análisis, la toma de decisiones y la personalización en múltiples industrias.
Las encuestas también dependen en gran medida de las entradas nominales. Piensa en preguntas como "¿Qué plataforma de redes sociales usas más?" o "¿Cuál es tu estado civil?" Estas respuestas no siguen ningún orden, pero permiten una segmentación limpia en informes y tendencias.
Los sistemas gubernamentales también utilizan datos nominales para todo, desde el seguimiento del censo hasta las categorías de presentación de impuestos. Ayudan a organizar conjuntos de datos masivos y aseguran una entrega más fluida de los servicios públicos. Los sistemas educativos tampoco se quedan atrás, categorizando a los estudiantes por materias, departamentos o incluso clubes extracurriculares, todo derivado de este tipo de datos.
En la inteligencia artificial y el aprendizaje automático, los datos nominales apoyan la personalización. Los algoritmos los utilizan para entender categorías, como géneros de películas o tipos de usuarios, y ofrecer sugerencias personalizadas. Puede que no llamen la atención, pero los datos nominales están haciendo un trabajo importante detrás de casi todas las interacciones digitales.
Desafíos y Consideraciones al Trabajar con Datos Nominales
Los datos nominales pueden parecer simples en la superficie, pero usarlos eficazmente conlleva sus propios desafíos. Uno de los mayores obstáculos es la codificación. La mayoría de los algoritmos no pueden procesar directamente etiquetas basadas en texto, por lo que necesitamos convertirlas en números. Pero hacer esto de manera descuidada puede implicar un orden falso. La codificación one-hot se usa a menudo para evitar eso, aunque aumenta el número de características en el conjunto de datos, a veces drásticamente. Esto lleva a lo que se conoce como la maldición de la dimensionalidad, lo que puede hacer que los modelos sean más lentos y más propensos al sobreajuste.
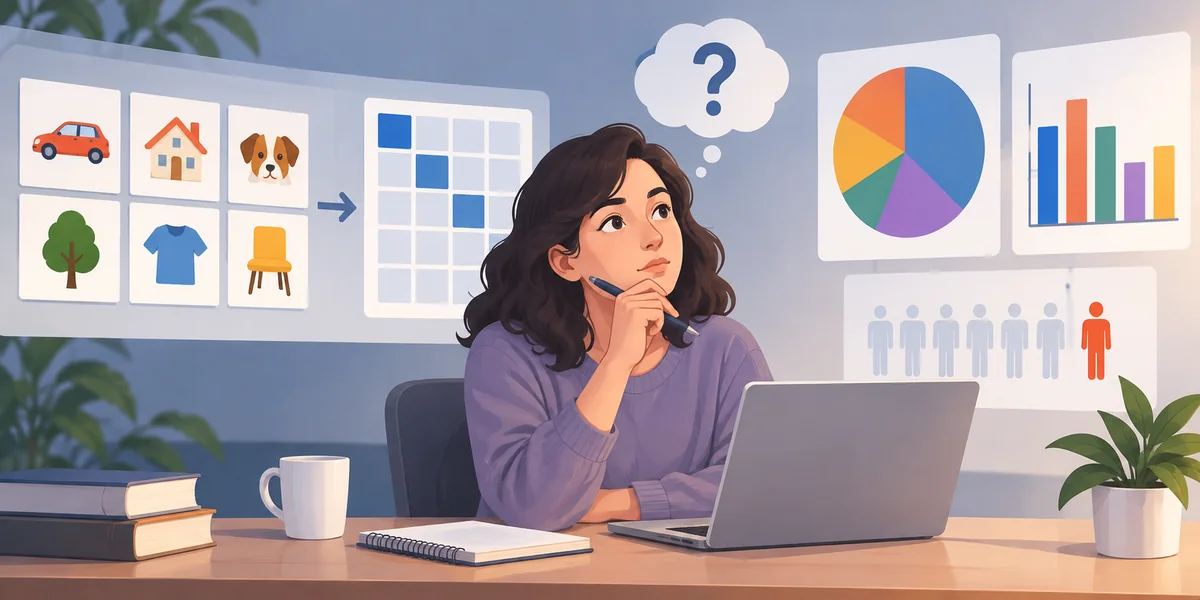
La visualización es otra área complicada. No puedes colocar datos nominales en una escala, por lo que los gráficos estándar no siempre encajan. Los gráficos de pastel y de barras funcionan mejor, pero incluso estos pueden inducir a error si las categorías se colocan en un orden que implica clasificación. Usar gradientes de color o barras ordenadas puede añadir accidentalmente significado donde no lo hay.
El muestreo presenta sus problemas. Cuando ciertas categorías son raras, los modelos pueden tener dificultades para aprender de ellas. Esto puede ser especialmente crítico en áreas como la detección de fraudes o la investigación médica. El submuestreo y el sobremuestreo deben hacerse con cuidado.
Finalmente, interpretar los datos nominales en modelos es complejo. Dado que no hay un orden, las conclusiones deben hacerse con cuidado. Leer patrones incorrectamente puede llevar a resultados engañosos. Aún así, cuando se manejan correctamente, los datos nominales siguen siendo esenciales para un análisis limpio y estructurado.
Conclusión
Los datos nominales pueden ser simples, pero son una herramienta poderosa para organizar la información en categorías claras y no ordenadas. Ya sea que estés etiquetando preferencias de usuario, respuestas de encuestas o registros médicos, este tipo de datos ayuda a los sistemas a dar sentido a las entradas basadas en la identidad. Aunque no involucran números o clasificaciones, su impacto en la clasificación de datos y la inteligencia artificial es innegable. Manejarlo correctamente asegura conocimientos precisos y modelos más inteligentes. En un mundo impulsado por los datos, incluso las etiquetas más básicas pueden tener un valor significativo.
Artículos relacionados

Guía para Principiantes sobre la Integración de LLMs en tus Proyectos de Ciencia de Datos

Modelado de Datos Conceptual: Estructurando Datos para Claridad y Eficiencia

Cómo la IA Generativa Puede Ayudarte a Mejorar tus Gráficas de Visualización de Datos

¿Qué es la Minería de Datos y Cómo Funciona?

Los Peligros Ocultos de la IA: Riesgos de Seguridad de Datos y Preocupaciones sobre la Privacidad

El Papel de un Curador de Datos: Organizando y Gestionando Datos de Calidad

Una Guía de Herramientas de Visualización de Big Data: Tipos, Beneficios y Elegir la Adecuada
Las 5 Vs del Big Data: Comprendiendo su Papel en la Gestión de Datos
Arquitectura de Hadoop: Comprendiendo sus Componentes Clave y Funcionalidad
8 Formas en que los Profesionales de RevOps están Utilizando la IA y la Automatización
Las Reglas Ocultas: Entendiendo las Restricciones de Integridad en SQL
Superando la Escasez de Datos y Desafíos de Entrenamiento de IA para Sistemas Más Inteligentes
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
