
Superando la Escasez de Datos y Desafíos de Entrenamiento de IA para Sistemas Más Inteligentes
En esta página
La Inteligencia Artificial (IA) se ha convertido en una fuerza transformadora en diversas industrias y en la vida cotidiana, pero su éxito depende de un principio fundamental: la IA no puede aprender sin datos. Aunque la tecnología avanza a un ritmo rápido, el acceso a datos de alta calidad a menudo queda rezagado. Muchas empresas enfrentan desafíos no porque sus ideas carezcan de innovación, sino porque sus modelos de IA carecen de los datos necesarios para aprender de manera efectiva.
Este problema, conocido como escasez de datos, presenta obstáculos significativos en el entrenamiento de sistemas de IA. Sin cerrar esta brecha, incluso la tecnología de IA más sofisticada no alcanza su potencial. Comprender la escasez de datos es crucial para desbloquear el potencial completo de soluciones de IA más inteligentes y confiables.
La Importancia de los Datos en el Entrenamiento de la IA
Los datos son la piedra angular de la inteligencia artificial, dando forma a cómo aprende, evoluciona y se desempeña. Independientemente de cuán avanzado pueda parecer un modelo de IA, su base se construye sobre datos. Enseñar a un sistema de IA es similar a educar a un estudiante. Un estudiante expuesto a diversos libros, situaciones y experiencias naturalmente se vuelve más conocedor y capaz. De manera similar, la IA requiere grandes cantidades de datos diversos y de alta calidad para reconocer patrones, hacer predicciones y responder con precisión.
Sin embargo, recopilar estos datos suele ser una tarea desafiante. Industrias como la atención médica, las finanzas y la seguridad manejan información sensible que no puede compartirse libremente debido a preocupaciones de privacidad y legales. En otros casos, los datos requeridos simplemente no existen aún. Por ejemplo, entrenar un vehículo autónomo requiere millones de imágenes que muestren diferentes escenarios de tráfico, condiciones climáticas y tipos de carreteras. Sin tales datos, los sistemas de IA pueden tener un rendimiento deficiente en situaciones desconocidas.
La escasez de datos no solo limita el rendimiento, sino que también puede llevar a sistemas de IA sesgados. Si los datos de entrenamiento carecen de diversidad o contienen sesgos, la IA puede producir resultados que favorecen a ciertos grupos sobre otros, lo que lleva a una representación incorrecta. Abordar la escasez de datos no es solo un problema técnico: es vital para crear una IA precisa, justa y confiable.
Desafíos Comunes de Entrenamiento de IA Causados por la Escasez de Datos
La escasez de datos introduce varios desafíos durante el entrenamiento de modelos de IA. Un problema importante es la mala generalización. Cuando la IA se entrena con un conjunto de datos limitado, puede rendir bien en esos datos específicos pero fallar en entregar resultados precisos en datos nuevos o del mundo real. Este fenómeno, conocido como sobreajuste, ocurre porque el sistema de IA aprende demasiado de una muestra limitada y carece de la capacidad para manejar nuevos escenarios.
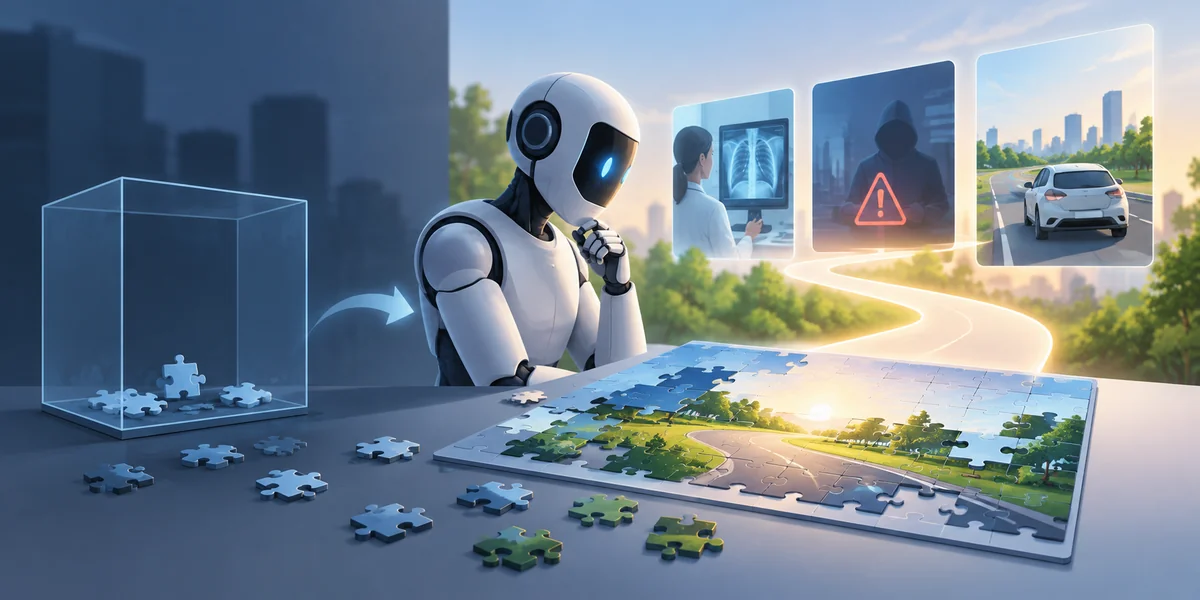
Otro desafío es la detección de eventos raros. En campos como el diagnóstico médico o la detección de fraudes, los eventos que necesitan identificación son infrecuentes. Los datos de entrenamiento para estos eventos raros a menudo son escasos, lo que dificulta que los modelos de IA aprendan de manera efectiva. Este problema se vuelve aún más crítico cuando estos eventos raros conllevan altos riesgos o consecuencias graves.
La escasez de datos también obstaculiza el desarrollo de sistemas de IA especializados. Mientras que los modelos de IA generales pueden manejar tareas comunes, las aplicaciones altamente enfocadas—como la identificación de enfermedades raras o la predicción de fallas de máquinas en contextos industriales—requieren grandes cantidades de datos específicos. Sin estos datos, crear soluciones de IA efectivas se vuelve casi imposible.
Además, la disponibilidad limitada de datos a menudo resulta en costos más altos. Las empresas pueden necesitar invertir significativamente en recolectar o comprar datos y contratar expertos para limpiarlos y etiquetarlos adecuadamente, haciendo que el desarrollo de IA sea más costoso y lento.
Estrategias para Superar la Escasez de Datos
Superar la escasez de datos requiere estrategias innovadoras. Una solución popular es la aumentación de datos. Esta técnica implica generar nuevas muestras de datos a partir de las existentes mediante pequeñas modificaciones, como rotar imágenes, alterar colores o agregar ruido. La aumentación de datos mejora el tamaño y la diversidad del conjunto de datos, permitiendo que los modelos de IA aprendan de manera más efectiva.
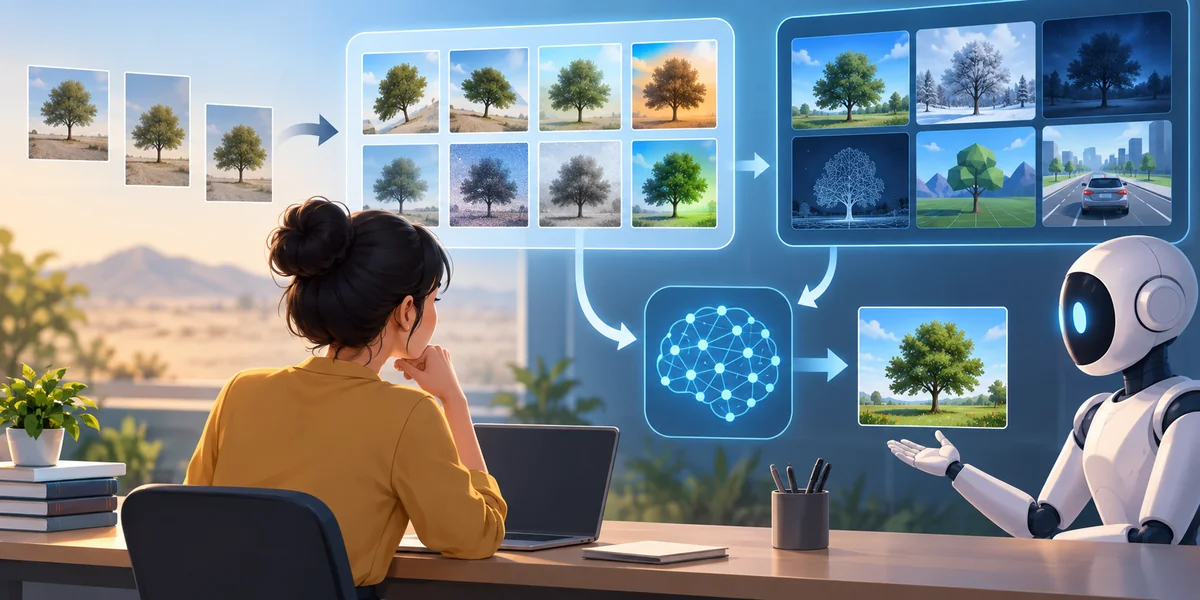
Otra estrategia es el uso de datos sintéticos. En escenarios donde recopilar datos reales es desafiante o costoso, los datos sintéticos pueden generarse usando simulaciones por computadora u otros modelos de IA. Este enfoque se emplea ampliamente en industrias como los videojuegos, la robótica y la conducción autónoma, donde los entornos simulados ofrecen una forma segura y rentable de crear grandes conjuntos de datos.
El aprendizaje por transferencia es otro método valioso. Implica aprovechar un modelo de IA preentrenado, que ya ha aprendido de un gran conjunto de datos, y adaptarlo a una nueva tarea pero relacionada. Este método reduce la cantidad de datos necesarios para entrenar nuevos modelos y acelera el proceso de desarrollo.
El aprendizaje federado es una solución emergente que permite que los modelos de IA aprendan de datos almacenados en varias ubicaciones sin transferir los datos a un servidor central. Este enfoque es especialmente beneficioso en atención médica y finanzas, donde la privacidad es primordial. Con el aprendizaje federado, las empresas pueden colaborar y entrenar modelos de IA sin exponer datos sensibles.
La colaboración entre industrias, organizaciones e instituciones de investigación también puede ayudar a abordar la escasez de datos. Compartir datos anonimizados o contribuir a conjuntos de datos de código abierto permite a los desarrolladores acceder a más información y construir mejores modelos. Sin embargo, tales colaboraciones deben cumplir con estrictas pautas de privacidad y seguridad.
Finalmente, el desarrollo de algoritmos mejorados es esencial. Los investigadores de IA están trabajando continuamente en modelos que puedan aprender efectivamente de conjuntos de datos pequeños. Técnicas como el aprendizaje con pocos ejemplos (few-shot learning) y el aprendizaje sin ejemplos (zero-shot learning) buscan crear sistemas de IA que requieran datos mínimos para entender y realizar tareas.
Conclusión
La escasez de datos y los desafíos de entrenamiento de IA son obstáculos significativos en la búsqueda de crear tecnología más inteligente. Sin datos de calidad suficientes, los sistemas de IA luchan por desempeñarse de manera óptima en escenarios del mundo real. Sin embargo, superar este desafío no es imposible. A través de soluciones innovadoras como la aumentación de datos, los datos sintéticos, el aprendizaje por transferencia y los esfuerzos colaborativos, los desarrolladores pueden mejorar sus modelos y mitigar el impacto de los datos limitados. A medida que las industrias dependen cada vez más de la IA para tareas críticas, abordar la escasez de datos sigue siendo esencial. El futuro de la IA depende de descubrir formas más inteligentes de entrenar sistemas, asegurando precisión, equidad y disposición para el uso práctico.
Artículos relacionados

Cómo Utilizar un Generador de Voz de Marca AI para Preservar Voces Específicas de los Canales

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal
¿Cómo se Entrenan las Herramientas de IA?

12 Recursos Principales para Construir un Marco de IA Ética

Orquestando la IA: la Transición de Actos Solitarios a una Sinfonía Completa

Cómo Utilizar Generadores de Anuncios AI para Crear Campañas Publicitarias Personalizadas 5 Veces Más Rápido

Cómo la IA Puede Ser tu Compañero en Recursos Humanos para el Reclutamiento y Compromiso de Empleados

El Centro de Llamadas con IA Ya No es un Mito, Sino una Realidad: 6 Pasos para una Implementación sin Dolor
3 Historias Inspiradoras de Líderes en IA
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025

Los Peligros Ocultos de la IA: Riesgos de Seguridad de Datos y Preocupaciones sobre la Privacidad
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
