
Un Conjunto de Datos, Dos Historias: El Extraño Caso de la Paradoja de Simpson
En esta página
A veces los números cuentan una historia clara, hasta que miras más de cerca y ves una narrativa diferente escondida debajo. Esta es la naturaleza intrigante y a menudo desconcertante de la Paradoja de Simpson. Ocurre cuando las tendencias en grupos individuales se invierten o desaparecen una vez que los datos se combinan. Lo que parecía cierto inicialmente, de repente no lo es.
Esta paradoja aparece en diversos campos, como la salud, la contratación y la inteligencia artificial, donde los patrones pueden ser engañosos si no se examinan cuidadosamente. Subraya la importancia del contexto en el análisis de datos. Sin contexto, corremos el riesgo de sacar conclusiones incorrectas y tomar decisiones erróneas basadas en ideas engañosas que no revelan la historia completa.
¿Qué es la Paradoja de Simpson?
La Paradoja de Simpson es un fenómeno estadístico donde las tendencias observadas en grupos separados desaparecen o se invierten cuando los datos se agregan. Aunque los números son precisos, la agrupación de datos genera confusión. Esta paradoja destaca cómo pueden surgir ideas engañosas cuando las variables ocultas no se consideran en el análisis general.
Considera una universidad con dos departamentos: Ingeniería y Humanidades. En ambos departamentos, las mujeres son admitidas a una tasa más alta que los hombres. Eso parece equitativo. Sin embargo, cuando los datos generales se combinan, sorprendentemente muestra a los hombres con una tasa de admisión más alta. ¿Cómo es posible? La explicación radica en la distribución de las solicitudes. Si más mujeres solicitan a los departamentos más competitivos con tasas de aceptación más bajas, su tasa de éxito total se verá reducida. Entonces, aunque se desempeñaron mejor dentro de cada grupo, los datos combinados cuentan una historia diferente y engañosa.
El problema principal a menudo involucra un factor oculto, llamado variable latente, que distorsiona la imagen general. Estas variables no siempre son obvias, pero pueden cambiar completamente la apariencia de los datos. Si te basas únicamente en totales o promedios sin profundizar en los detalles, corres el riesgo de sacar ideas engañosas que presentan una imagen falsa de la realidad.
Por Qué Sucede en la IA y el Aprendizaje Automático
En la inteligencia artificial y el aprendizaje automático, los modelos están diseñados para aprender de patrones en los datos. Sin embargo, cuando los datos incluyen subgrupos ocultos o distribuciones desiguales, la Paradoja de Simpson puede surgir silenciosamente. Si un modelo se entrena con datos combinados sin tener en cuenta las diferencias a nivel de grupo, podría terminar aprendiendo patrones que son engañosos o incorrectos.
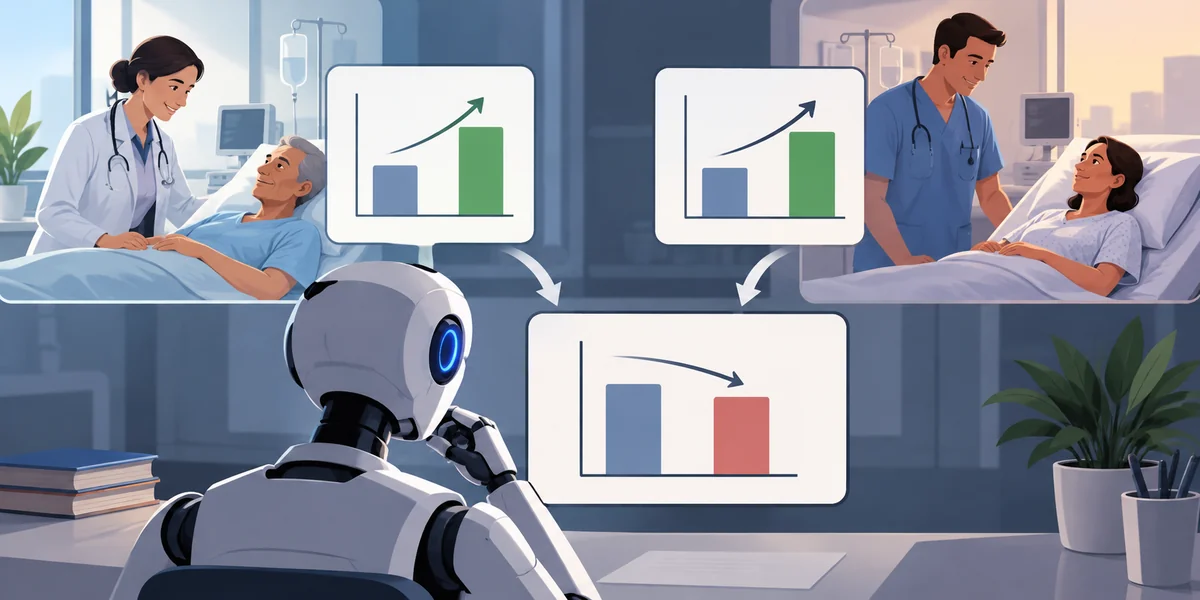
Considera un ejemplo en el ámbito de la salud: imagina entrenar una IA médica para predecir las tasas de recuperación de pacientes. Recolectas datos de dos hospitales, uno con mejores instalaciones que el otro. En ambos hospitales, los pacientes que recibieron un cierto tratamiento tuvieron mejores resultados. Sin embargo, cuando los datos de ambos hospitales se combinan, podría parecer que el tratamiento no es efectivo en absoluto. Esta tendencia invertida engaña al modelo y puede resultar en ideas engañosas al hacer recomendaciones de tratamiento.
El mismo problema surge en la equidad. Si estás construyendo un algoritmo de contratación e ignoras las diferencias entre departamentos o niveles de trabajo, el modelo podría favorecer o rechazar injustamente a ciertos grupos. El algoritmo no es inherentemente sesgado, el sesgo surge de una estructura de datos defectuosa.
Por eso los equipos de aprendizaje automático deben ir más allá de los patrones superficiales. Un análisis exploratorio profundo y una segmentación adecuada ayudan a descubrir la verdadera historia oculta en los datos. Sin ello, los sistemas de IA corren el riesgo de tomar decisiones basadas en señales falsas.
Consecuencias Reales de Malinterpretar los Datos
Los peligros de la Paradoja de Simpson se extienden mucho más allá de la teoría. Leer mal los patrones en los datos puede llevar a decisiones erróneas en salud, políticas, negocios y más. Uno de los casos más citados proviene de un análisis de la década de 1970 sobre el sesgo de género en las admisiones de UC Berkeley. A primera vista, los datos mostraron que las mujeres fueron aceptadas a tasas más bajas que los hombres.
Sin embargo, un examen más detallado reveló que las mujeres habían solicitado más a menudo a departamentos con tasas de rechazo más altas. Dentro de la mayoría de los departamentos individuales, las mujeres tenían tasas de aceptación ligeramente más altas que los hombres. Los datos combinados contaban una historia engañosa.
En el ámbito de la salud, pasar por alto los detalles de subgrupos puede ser peligroso. Un medicamento podría parecer efectivo en general, pero podría dañar a grupos de edad o géneros específicos. Sin desglosar los datos por estas variables, tales ideas engañosas pasan desapercibidas, llevando a decisiones médicas pobres.
El mismo problema ocurre en los negocios. Las empresas pueden diseñar productos o campañas basadas en el comportamiento promedio del cliente, ignorando cómo responden realmente diferentes grupos. Un segmento puede amar un producto mientras otro lo rechaza, pero los datos combinados ocultan esto.
La Paradoja de Simpson enseña una lección crucial: los resúmenes superficiales pueden ocultar verdades más profundas. Para evitar conclusiones falsas, es vital profundizar en los datos, separar claramente los grupos y pensar críticamente antes de tomar decisiones que afecten a personas reales.
Cómo Evitar Ideas Engañosas de la Paradoja de Simpson
La mejor manera de evitar la Paradoja de Simpson es abordar el análisis de datos con cuidado y curiosidad. Comienza dividiendo tus datos en segmentos significativos. Ya sea por edad, ubicación, género, departamento o período, segmentar ayuda a revelar patrones que podrían estar ocultos en los números generales.
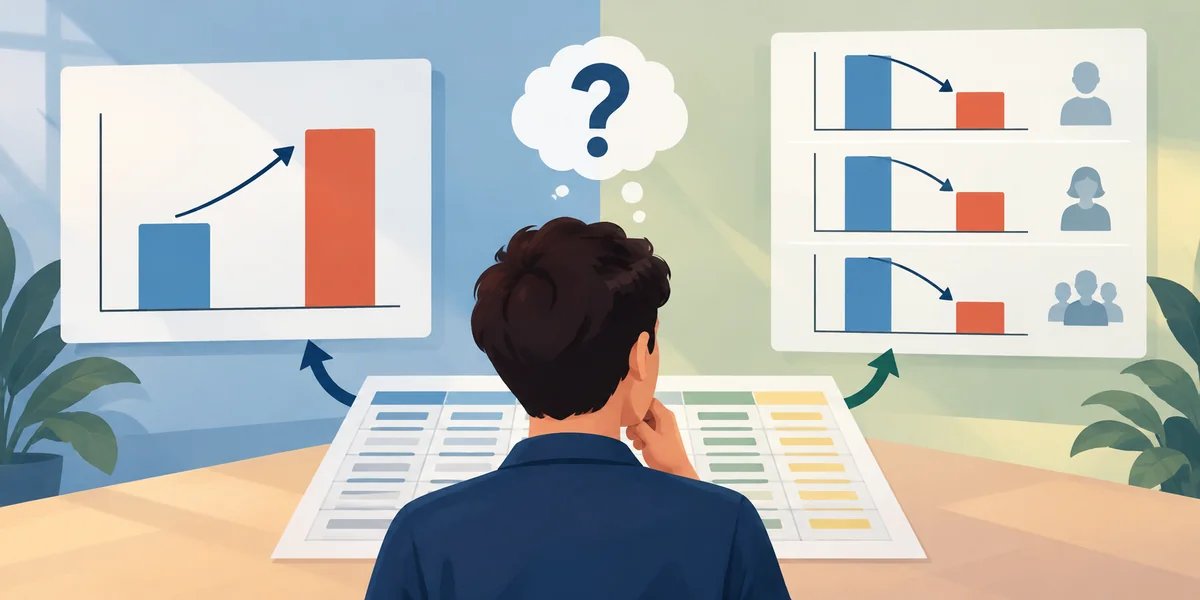
Otro paso importante es verificar las variables ocultas, factores que podrían no ser obvios inicialmente pero que tienen una influencia significativa en el resultado. Estas "variables latentes" pueden cambiar silenciosamente los resultados y voltear conclusiones sin previo aviso.
Siempre compara lo que los datos revelan a nivel de grupo versus los conocimientos generales. Si las dos historias no coinciden, eso es una señal para investigar más a fondo. La visualización también juega un papel importante. Gráficos, como gráficos de barras agrupadas o diagramas de dispersión, pueden exponer inconsistencias que las tablas podrían ocultar.
Finalmente, no subestimes el conocimiento del dominio. Comprender el contexto detrás de los números puede ayudarte a detectar resultados extraños antes de que conduzcan a ideas engañosas.
El análisis de datos no se trata solo de números, sino de razonamiento. Y cuando el riesgo es alto, como a menudo sucede en la IA, la medicina o las políticas, ese tipo de pensamiento se vuelve esencial.
Conclusión
La Paradoja de Simpson ilustra que los datos pueden ser engañosos. Una tendencia puede parecer clara en grupos separados, pero invertirse completamente cuando esos grupos se combinan. Esto puede llevar a ideas engañosas, especialmente en la IA, la salud y los negocios. Para evitar ser engañado, es importante examinar los datos desde múltiples ángulos y considerar variables ocultas. Los promedios simples no siempre cuentan la historia completa. Al profundizar en los datos, podemos tomar mejores decisiones, más precisas, basadas en lo que realmente está sucediendo.
Artículos relacionados
Libros electrónicos gratuitos sobre Inteligencia Artificial para leer en 2025
Análisis de IA: La Clave para Identificar Brechas en el Mercado
Análisis en Tiempo Real Impulsado por IA: Transformando el Seguimiento del Rendimiento Estudiantil
Controlando la Gestión de Gastos con IA para Aumentar la Eficiencia y el Crecimiento
Análisis Conductual en Centros de Contacto: La Ventaja de la IA
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
