
Hiperparámetros: El Secreto para Afinar Modelos de Aprendizaje Automático
En esta página
Los modelos de aprendizaje automático no operan de manera independiente: requieren configuraciones precisas para alcanzar un rendimiento óptimo. En el núcleo de este proceso de afinación están los hiperparámetros, configuraciones esenciales que influyen en el aprendizaje del modelo, afectando su velocidad, precisión y capacidades de generalización. A diferencia de los parámetros, que un modelo aprende durante el entrenamiento, los hiperparámetros deben ser predefinidos. Elegir incorrectamente los hiperparámetros puede ralentizar el entrenamiento o reducir la precisión, mientras que aquellos bien optimizados pueden desbloquear todo el potencial de un modelo.
Comprender los hiperparámetros es crucial para cualquiera que trabaje con aprendizaje automático, ya que influyen significativamente en el tiempo de entrenamiento y el rendimiento. Este artículo explora qué son los hiperparámetros, su impacto en el aprendizaje y cómo optimizarlos para mejorar el rendimiento.
¿Qué Son los Hiperparámetros?
Los hiperparámetros son configuraciones externas que dictan cómo un modelo de aprendizaje automático procesa los datos. A diferencia de los parámetros, como los pesos en una red neuronal, que se aprenden durante el entrenamiento, los hiperparámetros se establecen manualmente de antemano. Sirven como guías que controlan la estructura y el comportamiento del modelo.
Por ejemplo, en una red neuronal, los hiperparámetros incluyen el número de capas, neuronas por capa y la tasa de aprendizaje. En modelos más simples, como los árboles de decisión, podrían ser la profundidad del árbol o el número mínimo de muestras por hoja. Estas elecciones impactan significativamente en la capacidad de aprendizaje del modelo y su eficiencia de procesamiento.
Uno de los desafíos más significativos en la optimización del aprendizaje automático es seleccionar los hiperparámetros correctos. Un modelo mal ajustado puede sobreajustar, memorizando datos de entrenamiento sin manejar eficazmente nuevos datos. Por el contrario, configuraciones excesivamente relajadas pueden llevar a un subajuste, fallando en reconocer patrones importantes. Lograr el equilibrio correcto requiere pruebas, experiencia y, a veces, métodos de ajuste automatizados.
Por Qué los Hiperparámetros Importan en el Aprendizaje Automático
Los hiperparámetros son la clave para ajustar un modelo. Sin parámetros correctamente establecidos, un modelo puede ser ineficiente, inexacto o incluso ineficaz. Cada algoritmo de aprendizaje automático, ya sea simple o complejo, tiene hiperparámetros que gobiernan su rendimiento.
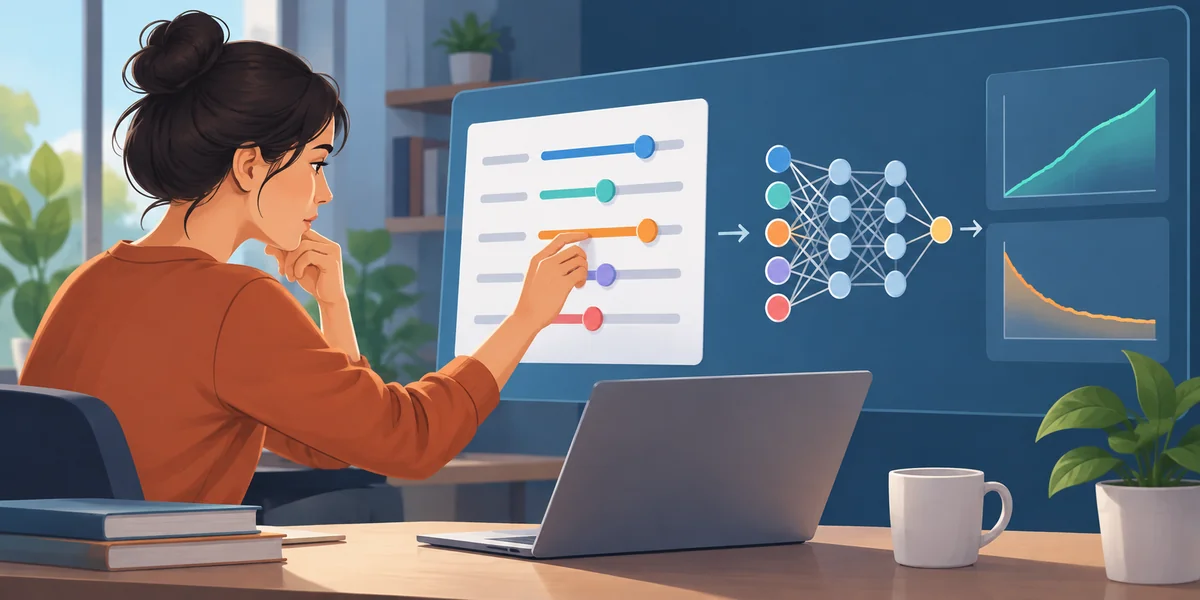
Un área crítica impactada por los hiperparámetros es el compromiso entre velocidad y precisión. Una alta tasa de aprendizaje puede acelerar el entrenamiento pero llevar a un aprendizaje inestable, perdiendo patrones importantes. Una baja tasa de aprendizaje estabiliza el entrenamiento pero puede tardar más en converger. Por lo tanto, el ajuste debe lograr el equilibrio correcto.
La complejidad del modelo es otro aspecto crucial. Las redes neuronales profundas pueden tener cientos de hiperparámetros, desde funciones de activación en capas hasta configuraciones de optimización que ajustan los pesos durante el entrenamiento. Incluso los modelos simples, como la regresión lineal, tienen hiperparámetros, como la fuerza de regularización, para prevenir el sobreajuste.
Los hiperparámetros afectan más que solo el entrenamiento; también influyen en qué tan bien un modelo generaliza a datos no vistos. Si un modelo está demasiado afinado a los datos de entrenamiento, puede tener un rendimiento deficiente en datos del mundo real. Técnicas como la validación cruzada se utilizan para probar diferentes configuraciones de hiperparámetros antes de finalizar un modelo.
Hiperparámetros Comunes y su Impacto
Diferentes modelos de aprendizaje automático tienen varios hiperparámetros que influyen en su rendimiento. Aquí hay algunos comúnmente usados y sus efectos en el aprendizaje:
Tasa de Aprendizaje: Determina qué tan rápido un modelo actualiza sus parámetros. Una alta tasa de aprendizaje puede acelerar el entrenamiento pero puede llevar a inestabilidad, mientras que una tasa baja asegura un progreso constante pero tarda más en converger.
Tamaño del Lote: Se refiere al número de muestras procesadas antes de actualizar el modelo. Un tamaño de lote más pequeño permite actualizaciones más frecuentes, pero un tamaño demasiado pequeño puede hacer que el entrenamiento sea ruidoso. Un tamaño de lote más grande proporciona estabilidad pero requiere más memoria.
Número de Épocas: Define cuántas veces el modelo pasa por el conjunto de datos de entrenamiento. Demasiadas épocas pueden causar sobreajuste, mientras que muy pocas pueden llevar a un subajuste.
Fuerza de Regularización: Técnicas como la regularización L1 y L2 ayudan a prevenir el sobreajuste añadiendo penalizaciones a pesos grandes. Elegir la configuración de regularización correcta asegura que el modelo generalice bien.
Número de Capas y Neuronas: Arquitecturas más profundas con más neuronas por capa pueden capturar patrones complejos en redes neuronales pero requieren más datos y computación para entrenar eficazmente.
Ajustar estos hiperparámetros es crucial para mejorar la precisión y eficiencia del modelo. Los valores ideales varían según el conjunto de datos y el problema en cuestión, haciendo de la experimentación una parte esencial de la optimización del aprendizaje automático.
Optimizando Hiperparámetros para un Mejor Rendimiento
Encontrar los mejores hiperparámetros no es una tarea de talla única. Involucra probar diferentes valores, realizar experimentos y comparar resultados. Este proceso, conocido como ajuste de hiperparámetros, se puede llevar a cabo de múltiples maneras.
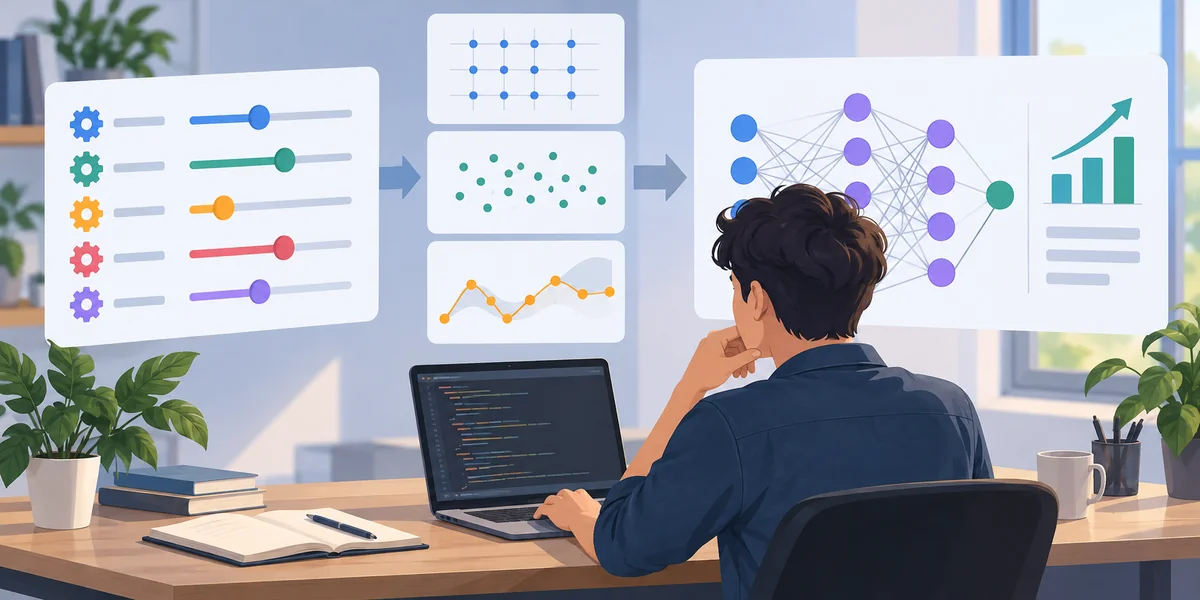
Un método común es la búsqueda en cuadrícula, donde se prueba sistemáticamente un rango de valores para encontrar la mejor combinación. Sin embargo, la búsqueda en cuadrícula puede ser lenta, especialmente para modelos complejos con muchos hiperparámetros. Otro enfoque es la búsqueda aleatoria, que selecciona combinaciones de hiperparámetros al azar para probar, a menudo obteniendo buenos resultados con menos computación.
Técnicas más avanzadas incluyen la optimización bayesiana y los algoritmos genéticos, que utilizan el rendimiento pasado para predecir mejores configuraciones de hiperparámetros. Estos métodos reducen el número de pruebas necesarias para encontrar valores óptimos.
Las herramientas de ajuste automatizado de hiperparámetros, como el AutoML de Google o Hyperopt, eliminan las conjeturas en este proceso. Analizan el rendimiento y ajustan las configuraciones dinámicamente, haciendo la optimización del aprendizaje automático más rápida y eficiente.
Elegir los hiperparámetros correctos también depende del conjunto de datos y el problema que se está resolviendo. Lo que funciona bien para el reconocimiento de imágenes podría no ser ideal para el análisis de texto. La experimentación, validación y afinación son esenciales para obtener lo mejor de los modelos de aprendizaje automático.
Conclusión
Los hiperparámetros son las palancas ocultas que moldean cómo los modelos de aprendizaje automático aprenden y funcionan. Acertar en su ajuste significa encontrar un equilibrio entre eficiencia y precisión, evitando el sobreajuste mientras se asegura que el modelo capture patrones significativos. Ya sea ajustando la tasa de aprendizaje, modificando el número de capas, o seleccionando el tamaño de lote correcto, cambios pequeños pueden hacer una gran diferencia. Aunque el ajuste de hiperparámetros puede parecer complejo, es un paso necesario para construir modelos fiables y de alto rendimiento. Con el enfoque correcto, ya sea ajuste manual o herramientas automatizadas, cualquiera puede optimizar los hiperparámetros y desbloquear todo el potencial de los modelos de aprendizaje automático.
Artículos relacionados
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Construyendo Mejores Modelos: La Batalla Entre el Sobreajuste y el Subajuste
Aprendizaje Automático: Modelos Listos para Usar o Personalizados - Pros y Contras
Por qué el Deep Learning Puede No Ser la Solución Adecuada para Su Negocio
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
Herramientas de Aprendizaje Automático
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información
Herramientas de Aprendizaje Automático Automatizado: Desbloqueando el Potencial del AutoML
CNNs vs. Transformadores: ¿Qué Modelo de IA Funciona Mejor para tu Tarea?
Conceptos de Aprendizaje Automático Explicados: El Futuro de la Inteligencia Financiera
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
