
MapReduce vs. Spark: Diferencias Clave e Insights para el Procesamiento de Datos
En esta página
Dos de las herramientas más discutidas para manejar grandes volúmenes de datos son Apache Spark y MapReduce. Ambos sirven como marcos para el procesamiento de big data, pero abordan las tareas de maneras fundamentalmente diferentes. Aunque comparten el objetivo común de gestionar conjuntos de datos masivos, Spark y MapReduce tienen ventajas y limitaciones distintas.
En este artículo, examinaremos las características de ambos, analizaremos sus ventajas y desventajas, y te ayudaremos a entender las diferencias principales que pueden determinar tu elección de herramienta para tus requisitos de procesamiento de datos.
¿Qué es Apache Spark?
Apache Spark es un marco de computación distribuida de código abierto diseñado para procesar big data a alta velocidad. A diferencia de los sistemas tradicionales de procesamiento por lotes, Spark opera en memoria, almacenando en caché los datos intermedios en RAM, lo que reduce significativamente el tiempo de procesamiento. La capacidad de Spark para procesar tanto datos por lotes como en tiempo real lo convierte en una opción versátil para aplicaciones modernas de big data.
Spark cuenta con una API de alto nivel que simplifica la programación al soportar múltiples lenguajes, incluyendo Java, Python, Scala y R. También permite realizar operaciones avanzadas de análisis como aprendizaje automático con MLlib, análisis de grafos con GraphX y consultas con Spark SQL. La versatilidad de Spark lo convierte en una herramienta preferida para ingenieros y científicos de datos que necesitan realizar operaciones complejas en grandes conjuntos de datos de manera rápida y eficiente.
Ventajas de Apache Spark
Una de las principales ventajas de Spark es su velocidad, lograda al procesar datos en memoria sin escribir resultados intermedios en disco. Esto produce grandes mejoras en el rendimiento, especialmente para el aprendizaje automático iterativo y el análisis interactivo de datos. Además, las APIs de Spark en varios lenguajes de programación facilitan su uso, permitiendo a los desarrolladores trabajar sin necesidad de aprender nuevos marcos.
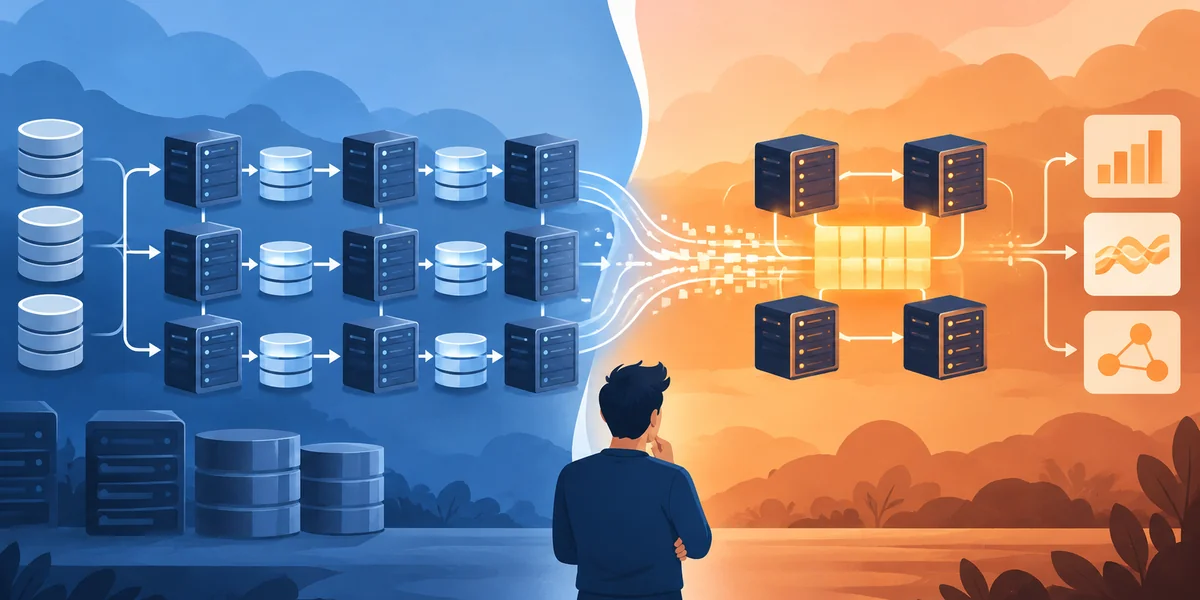
El motor unificado de Spark soporta tareas de procesamiento por lotes, streaming y aprendizaje automático, reduciendo la complejidad del flujo de trabajo. Además, Spark proporciona tolerancia a fallos a través de los Resilient Distributed Datasets (RDDs), lo que permite recomputar los datos desde el conjunto de datos original si fallan los nodos.
Desventajas de Apache Spark
A pesar de sus numerosas ventajas, Spark tiene algunas desventajas. Una preocupación principal es su uso de memoria; operar en memoria requiere una cantidad considerable de RAM, lo que puede ser costoso para operaciones a gran escala. Cuando los datos no caben en memoria, el rendimiento de Spark puede disminuir. Optimizar Spark para cargas de trabajo específicas también puede ser un desafío.
Aunque las APIs de alto nivel simplifican el desarrollo, pueden ocultar complejidades subyacentes, complicando la optimización del rendimiento. Depurar en entornos distribuidos puede ser difícil, especialmente al abordar fallos en grandes clústeres, lo que complica la resolución de problemas.
¿Qué es MapReduce?
MapReduce, desarrollado por Google y popularizado por Apache Hadoop, es un modelo de programación diseñado para procesar grandes conjuntos de datos en paralelo a través de clústeres distribuidos. El modelo MapReduce consta de dos funciones principales: la función "Map" procesa los datos de entrada, generando pares clave-valor intermedios, y la función "Reduce" agrega estos pares para producir el resultado final.
MapReduce es conocido por su escalabilidad y capacidad para procesar enormes cantidades de datos a través de numerosos nodos en un clúster. Se utiliza principalmente para el procesamiento por lotes y es adecuado para aplicaciones que involucran transformaciones simples o agregaciones sobre grandes conjuntos de datos. Muchas organizaciones dependen de MapReduce para tareas tradicionales de big data como análisis de registros, almacenamiento de datos y procesamiento por lotes.
Ventajas de MapReduce
MapReduce es conocido por su simplicidad, lo que lo hace fácil de entender, especialmente para aquellos con experiencia en programación funcional. Es altamente escalable y capaz de distribuir tareas a través de muchas máquinas, ideal para procesar conjuntos de datos masivos. Otro beneficio es su integración con el ecosistema de Hadoop.
Como componente central de Hadoop, MapReduce aprovecha la escalabilidad, fiabilidad y tolerancia a fallos proporcionadas por el Sistema de Archivos Distribuido de Hadoop (HDFS), lo que permite el procesamiento de datos en paralelo. Además, MapReduce se ha utilizado extensamente en entornos de producción durante muchos años, por lo que es una herramienta confiable y probada para el procesamiento de datos a gran escala.
Desventajas de MapReduce
A pesar de su escalabilidad y fiabilidad, MapReduce tiene desventajas notables. Un problema importante es su velocidad, ya que depende de la E/S de disco para el almacenamiento de datos intermedios, lo que puede ralentizar el procesamiento, especialmente en tareas iterativas. Aquí es donde Spark a menudo supera a MapReduce, ya que Spark procesa datos en memoria.
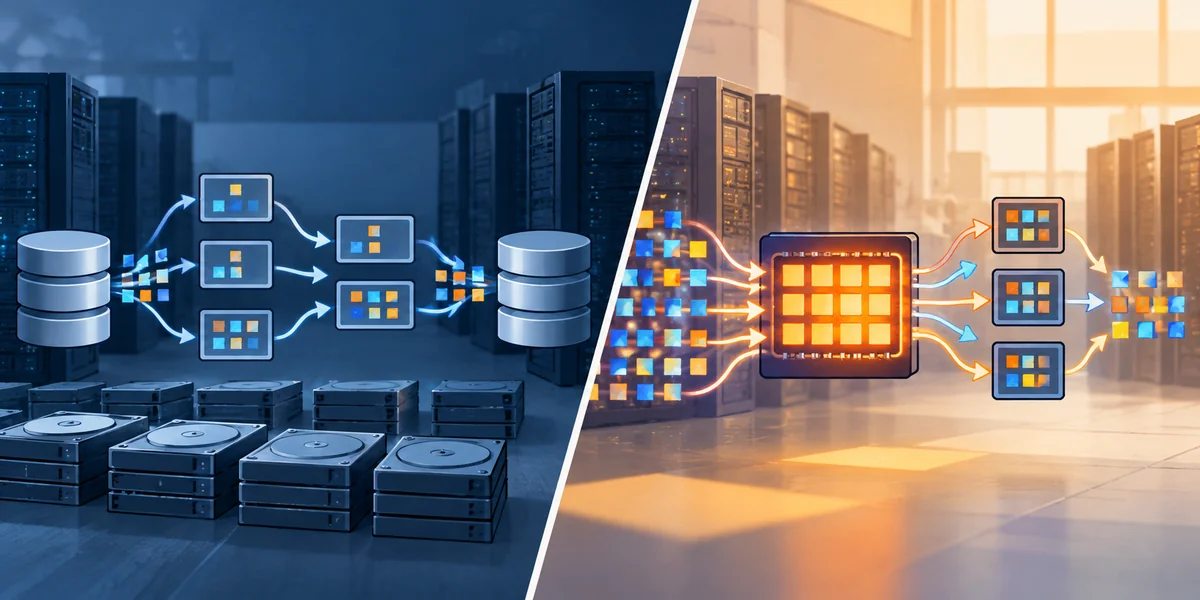
Otra limitación es la complejidad de la programación. Aunque el modelo básico es simple, manejar algoritmos complejos o procesos de múltiples etapas puede volverse engorroso. MapReduce también tiene dificultades con tareas iterativas de aprendizaje automático, ya que cada iteración requiere un paso completo a través del conjunto de datos, lo que lo hace ineficiente para esas cargas de trabajo específicas.
Diferencias Clave: Apache Spark vs. MapReduce
La diferencia principal entre Spark y MapReduce radica en cómo procesan los datos. Spark utiliza procesamiento en memoria, permitiéndole trabajar mucho más rápido que MapReduce, especialmente para tareas iterativas. En contraste, MapReduce escribe datos intermedios en disco, lo que lleva a un rendimiento más lento.
Otra diferencia clave es el nivel de complejidad. Las APIs de alto nivel de Spark y su motor unificado para tareas de procesamiento por lotes, streaming y aprendizaje automático lo hacen más versátil y fácil de usar que MapReduce, que generalmente se limita al procesamiento por lotes y es más complejo de programar.
La tolerancia a fallos es otra área en la que Spark y MapReduce difieren. Aunque ambos marcos proporcionan tolerancia a fallos, el uso de RDDs por parte de Spark le permite recomputar datos perdidos desde el conjunto de datos original, haciéndolo más resistente. MapReduce depende del HDFS de Hadoop para la tolerancia a fallos, pero puede ser más lento para recuperarse de fallos debido a su modelo de almacenamiento basado en disco.
Conclusión
Tanto Spark como MapReduce tienen sus fortalezas y limitaciones, lo que los hace adecuados para diferentes casos de uso. Spark destaca en velocidad, flexibilidad y facilidad de uso, especialmente para el procesamiento de datos iterativo y en tiempo real. Sin embargo, requiere recursos significativos de memoria y puede ser un desafío optimizarlo para ciertas tareas. Por otro lado, MapReduce es confiable, simple y bien integrado con el ecosistema de Hadoop, pero sufre de un rendimiento más lento y es menos eficiente para operaciones iterativas. Elegir entre Spark y MapReduce depende de los requisitos específicos de tus necesidades de procesamiento de big data, como velocidad, escalabilidad y complejidad.
Artículos relacionados
Guía para Ayudar a los Empleados a Adoptar la IA y Reducir la Resistencia en el Lugar de Trabajo
Cómo la IA está Transformando la Industria Minorista
Wearables impulsados por IA: Transformando el seguimiento de la salud y el fitness

Creación de Aplicaciones de IA con Gemini 2.0
Prueba Social en Marketing de IA: Utilizando Testimonios y Estudios de Caso
Cómo Hacer Marketing por Email para la Promoción de Herramientas de IA
Los 10 Principales Líderes en Aprendizaje Automático
Guionistas de Hollywood sobre IA: Cambios en la Industria y Desafíos Profesionales
El Papel de la IA en la Desigualdad de Ingresos: Cambios Económicos y Brechas en el Mercado Laboral
Los Límites de la IA Generativa: Por Qué No Puede Reemplazar Completamente la Inteligencia Humana
Asegura el Futuro de Tu Carrera: Una Guía para Estudiantes en la Era de la IA
IA y Productividad: El Poder de Trabajar Más Inteligentemente, No Más Duro
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
