
Normalización por Lote vs. Normalización por Capa: Diferencias Clave en el Aprendizaje Profundo
En esta página
Asegurar un aprendizaje eficiente y una rápida convergencia al entrenar modelos de aprendizaje profundo puede ser un desafío. Aquí es donde las técnicas de normalización como la Normalización por Capa y la Normalización por Lote entran en juego. Estos métodos son populares por estabilizar el entrenamiento y mejorar el rendimiento de las redes neuronales. Aunque ambos buscan abordar el desplazamiento covariante interno y mejorar la eficiencia del entrenamiento, difieren en su enfoque de normalización.
En este artículo, exploraremos las diferencias entre la Normalización por Capa y la Normalización por Lote, cómo funcionan y cuándo cada una es preferible para aplicaciones de aprendizaje profundo.
Los Fundamentos de la Normalización en el Aprendizaje Automático
Antes de adentrarnos en la Normalización por Capa y la Normalización por Lote, es importante entender por qué se utiliza la normalización en el aprendizaje automático, particularmente en las redes neuronales.
Los modelos de aprendizaje profundo a menudo experimentan desplazamientos covariantes internos, donde la distribución de los datos de entrada a una capa cambia durante el entrenamiento. Este cambio puede ralentizar el entrenamiento y obstaculizar la convergencia a soluciones óptimas. La normalización aborda este problema escalando y ajustando las entradas de cada capa para mantener la consistencia durante el entrenamiento. Esto resulta en una convergencia más rápida, menor sensibilidad a los hiperparámetros y un modelo más estable.
¿Qué es la Normalización por Lote?
La Normalización por Lote (BN) fue introducida para abordar el desplazamiento covariante interno. Normaliza la salida de una capa ajustando sus activaciones utilizando estadísticas (media y varianza) calculadas sobre un mini-lote de datos. Esencialmente, la Normalización por Lote estandariza las activaciones de cada capa durante el entrenamiento, asegurando que las entradas tengan una media de cero y una desviación estándar de uno.
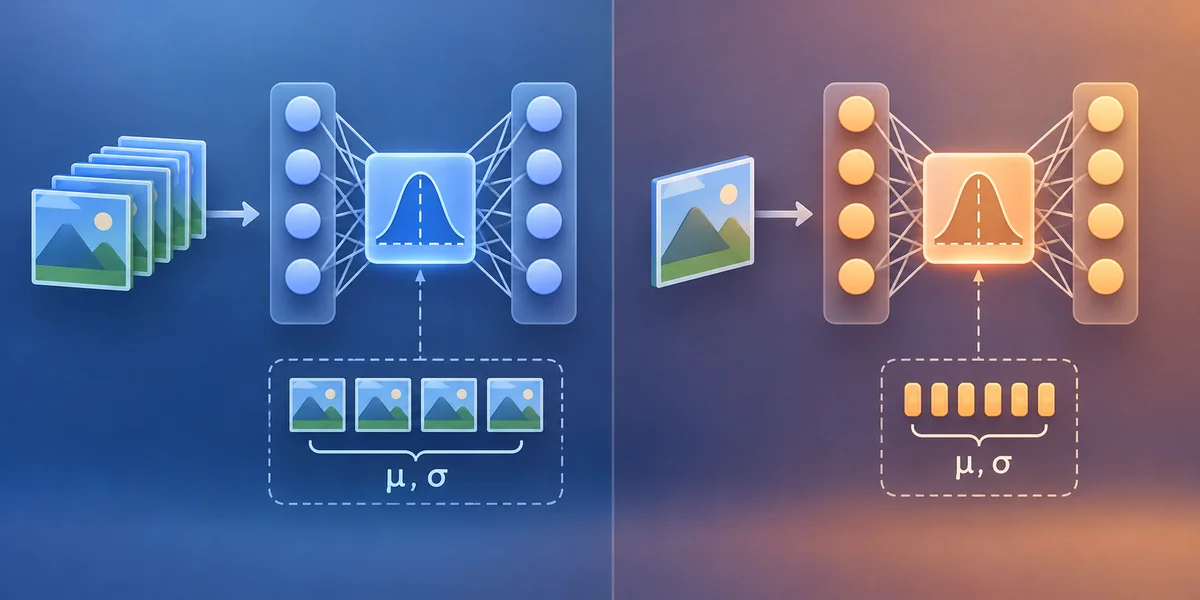
Durante el entrenamiento, la Normalización por Lote calcula la media y varianza de las activaciones dentro de un mini-lote, normaliza los datos y aplica un factor de escala y sesgo que se pueden aprender. Este proceso estabiliza el entrenamiento al reducir los desplazamientos covariantes internos.
La Normalización por Lote ha ganado popularidad debido a su capacidad para acelerar el entrenamiento, reducir la sensibilidad a los pesos iniciales y, a veces, permitir tasas de aprendizaje más altas, lo que lleva a un mejor rendimiento. Es particularmente efectiva en redes neuronales convolucionales (CNN) y otras arquitecturas donde la velocidad de entrenamiento es crucial.
Sin embargo, la Normalización por Lote tiene limitaciones. Su dependencia de las estadísticas de mini-lote puede degradar el rendimiento cuando se entrena con lotes más pequeños o con tamaños de lote altamente variables. También tiene dificultades con tareas que requieren alta flexibilidad, como redes neuronales recurrentes (RNN) o tareas con tamaños de entrada variables, como el procesamiento de lenguaje natural.
¿Qué es la Normalización por Capa?
En contraste, la Normalización por Capa (LN) normaliza las activaciones a lo largo de toda la entrada para cada ejemplo de entrenamiento, en lugar de a través de un mini-lote. LN calcula la media y la varianza para cada ejemplo de forma independiente, lo que la hace adecuada para escenarios con tamaños de lote pequeños o modelos que requieren flexibilidad en el manejo de datos secuenciales.
La Normalización por Capa se utiliza a menudo en redes neuronales recurrentes (RNN) y arquitecturas de transformadores, donde se prefiere procesar cada paso de tiempo de forma independiente. A diferencia de la Normalización por Lote, LN no depende de las estadísticas de mini-lote, evitando problemas con tamaños de lote pequeños o tamaños de entrada variables.
Similar a la Normalización por Lote, la Normalización por Capa también aplica un factor de escala y sesgo que se pueden aprender después de la normalización. Esto ayuda a mantener la capacidad del modelo para aprender patrones complejos sin introducir sesgos en los datos normalizados.
Diferencias Clave entre la Normalización por Capa y la Normalización por Lote
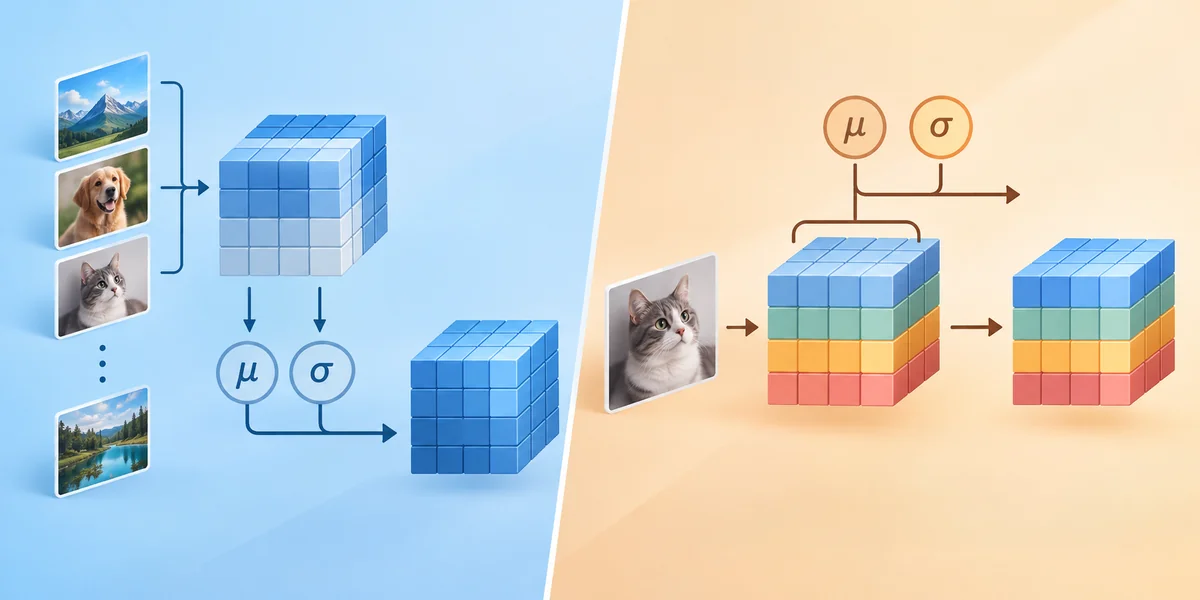
La principal diferencia entre la Normalización por Capa y la Normalización por Lote es cómo calculan las estadísticas de normalización. La Normalización por Lote normaliza sobre un mini-lote, mientras que la Normalización por Capa normaliza a través de cada entrada.
Normalización a Nivel de Lote vs. Nivel de Muestra:
La Normalización por Lote se basa en estadísticas calculadas sobre un mini-lote, utilizando múltiples muestras para calcular la media y la varianza. En contraste, la Normalización por Capa calcula estas estadísticas sobre todas las unidades de una sola capa por entrada individual. Esta distinción es crucial al elegir la técnica de normalización adecuada según sus datos y modelo.
Sensibilidad al Tamaño del Lote:
La Normalización por Lote puede tener dificultades con tamaños de lote pequeños debido a estadísticas poco confiables. En casos con lotes muy pequeños o procesamiento de una sola muestra, puede que no arroje resultados significativos. Sin embargo, la Normalización por Capa opera independientemente del tamaño del lote, ofreciendo más flexibilidad para tamaños de lote variables, como en tareas de procesamiento de lenguaje natural.
Casos de Uso:
La Normalización por Lote es altamente efectiva en redes neuronales convolucionales (CNN), donde los lotes grandes y las muestras independientes por lote son comunes. Se utiliza ampliamente en visión por computadora y tareas con tamaños de entrada fijos.
Por otro lado, la Normalización por Capa es ideal para tareas que involucran datos secuenciales, como la predicción de series temporales o el procesamiento de lenguaje natural, especialmente en modelos como RNNs y transformadores, donde cada muestra se procesa de forma independiente.
Velocidad y Eficiencia del Entrenamiento:
La Normalización por Lote puede acelerar el entrenamiento al estabilizar las tasas de aprendizaje, pero requiere un cálculo adicional para mantener las estadísticas de mini-lote. La Normalización por Capa, al enfocarse en cada muestra, puede llevar a un entrenamiento ligeramente más lento en algunos escenarios, pero en general es más estable y menos dependiente del tamaño del lote.
Conclusión
Tanto la Normalización por Capa como la Normalización por Lote desempeñan roles cruciales en la optimización de modelos de aprendizaje profundo, pero sus aplicaciones varían según la tarea. La Normalización por Lote es ideal para tareas con tamaños de lote grandes y consistentes, especialmente en CNNs. La Normalización por Capa sobresale en modelos basados en secuencias como RNNs o tareas de procesamiento de lenguaje natural, donde la flexibilidad y los lotes más pequeños son esenciales. Comprender sus diferencias te ayuda a elegir la técnica correcta para una mejor estabilidad y eficiencia en el entrenamiento.
Artículos relacionados
Clasificación de Imágenes en IA: Cómo las Máquinas Aprenden a Reconocer Imágenes
CNNs vs. Transformadores: ¿Qué Modelo de IA Funciona Mejor para tu Tarea?
¿Qué es el Aprendizaje No Supervisado? Explorando Técnicas Clave y Usos
Comprender la IA Simbólica vs. Conexionismo en la Inteligencia Artificial
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
10 Conceptos Críticos de IA Explicados en 5 Minutos
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
El Mundo de VAE y GAN: Cómo Difieren los Modelos Generativos de IA
Redes Neuronales: Los Bloques Fundamentales de la IA
De la Compresión a la Creatividad: El Papel de los Autoencoders Variacionales en la IA
Aprendizaje Personalizado con IA: Un Cambio Radical en la Educación en Línea
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
