
¿Qué es el Aprendizaje No Supervisado? Explorando Técnicas Clave y Usos
En esta página
En el aprendizaje no supervisado, la computadora identifica patrones dentro de los datos sin etiquetas o resultados predefinidos. A diferencia del aprendizaje supervisado, que utiliza tanto datos como etiquetas para entrenar modelos, el aprendizaje no supervisado explora patrones o estructuras inherentes a los datos. Este método es crucial para el análisis de datos, especialmente cuando los datos etiquetados son escasos o no están disponibles. Este artículo discutirá el concepto de aprendizaje no supervisado, sus tipos principales, aplicaciones comunes y ejemplos del mundo real.
¿Qué es el Aprendizaje No Supervisado?
El aprendizaje no supervisado implica entrenar un modelo de aprendizaje automático con datos no etiquetados. El objetivo principal es que el algoritmo descubra patrones, estructuras o relaciones dentro de los datos de manera autónoma. Es esencial en tareas como agrupamiento, detección de anomalías y reducción de dimensionalidad, las cuales son fundamentales en escenarios de análisis de datos donde el etiquetado manual es impráctico o costoso.
Tipos de Aprendizaje No Supervisado
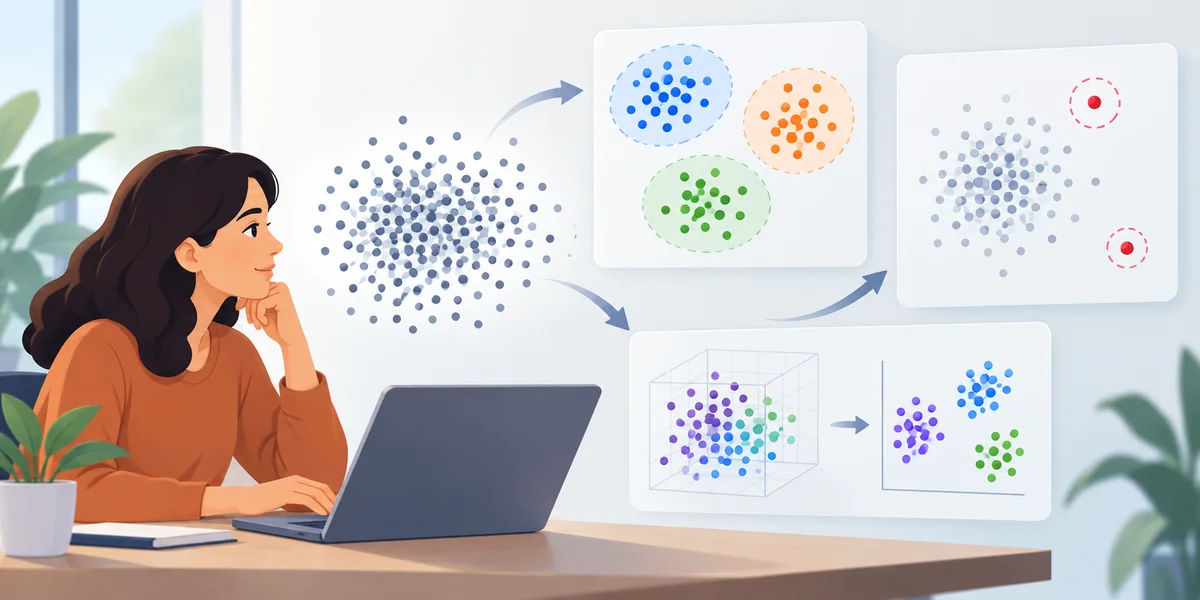
Existen dos tipos principales de aprendizaje no supervisado: agrupamiento y asociación. Ambos buscan analizar y revelar patrones dentro de los datos, aunque con objetivos diferentes.
Agrupamiento: El agrupamiento implica agrupar puntos de datos basándose en similitudes. El algoritmo identifica naturalmente qué puntos de datos son más similares y los agrupa en consecuencia. Esta técnica se utiliza comúnmente en la segmentación de mercado, donde los clientes se agrupan en base a su comportamiento de compra o preferencias. El agrupamiento también puede categorizar elementos como imágenes, documentos o ubicaciones geográficas. K-Means es un algoritmo de agrupamiento prevalente que asigna puntos de datos a grupos minimizando la distancia entre los puntos de datos y los centros de los grupos.
Asociación: La asociación se enfoca en descubrir relaciones entre variables dentro de grandes conjuntos de datos. Por ejemplo, puede identificar patrones como "clientes que compraron X también compraron Y". Esta técnica se utiliza ampliamente en el comercio minorista y el comercio electrónico para recomendaciones de productos. La asociación generalmente se aplica en sistemas de recomendación, con el objetivo de predecir artículos basados en el comportamiento previo de un cliente. Los supermercados, por ejemplo, utilizan reglas de asociación para analizar hábitos de compra, como identificar que los clientes que compran leche a menudo también compran pan, lo que puede informar sugerencias de productos u optimización del diseño de la tienda.
Algoritmos Comunes en Aprendizaje No Supervisado
Existen varios algoritmos que se utilizan comúnmente en tareas de aprendizaje no supervisado, cada uno adaptado para manejar tipos específicos de datos. Los algoritmos populares incluyen:
- Agrupamiento K-Means: Agrupa datos en un número especificado de grupos basándose en similitud.
- Agrupamiento Jerárquico: Crea una estructura en forma de árbol para representar grupos de datos en varios niveles.
- Análisis de Componentes Principales (PCA): Se utiliza para la reducción de dimensionalidad al enfocarse en las características más significativas, simplificando conjuntos de datos grandes para su análisis.
- DBSCAN: Un algoritmo basado en densidad que agrupa puntos cercanos e identifica puntos atípicos como ruido.
Estos algoritmos pueden adaptarse a varios tipos de datos y áreas de aplicación, dependiendo del problema en cuestión.
Aplicaciones del Aprendizaje No Supervisado
El aprendizaje no supervisado tiene numerosas aplicaciones prácticas en diversas industrias. Desempeña un papel crucial en permitir que organizaciones e investigadores obtengan información valiosa a partir de grandes conjuntos de datos no etiquetados. Las aplicaciones clave incluyen:
Segmentación de Clientes: Las empresas utilizan el aprendizaje no supervisado para segmentar a los clientes en grupos con características similares, como comportamiento de compra o información demográfica, mejorando los esfuerzos de marketing dirigido.
Detección de Anomalías: En ciberseguridad o detección de fraudes, el aprendizaje no supervisado identifica patrones inusuales que pueden indicar brechas de seguridad o actividad fraudulenta, como detectar transacciones de tarjetas de crédito atípicas para prevenir fraudes.
Sistemas de Recomendación: Muchas plataformas en línea emplean el aprendizaje no supervisado para recomendar productos o contenido basado en comportamientos previos de los usuarios, como Netflix sugiriendo películas o Amazon recomendando productos.
Desafíos en el Aprendizaje No Supervisado
Aunque el aprendizaje no supervisado es poderoso, presenta varios desafíos. Una dificultad significativa es la falta de salidas predefinidas, lo que complica la evaluación del rendimiento del modelo. A diferencia del aprendizaje supervisado, donde las predicciones se pueden comparar con etiquetas conocidas, el aprendizaje no supervisado requiere métodos de evaluación diferentes, como índices de validez de agrupamiento o métricas específicas de dominio.
Además, los algoritmos de aprendizaje no supervisado pueden producir resultados que son difíciles de interpretar, especialmente con datos complejos. A veces, los algoritmos pueden detectar patrones que carecen de significado significativo, lo que requiere un análisis experto cuidadoso y validación.
Ejemplos del Mundo Real de Aprendizaje No Supervisado
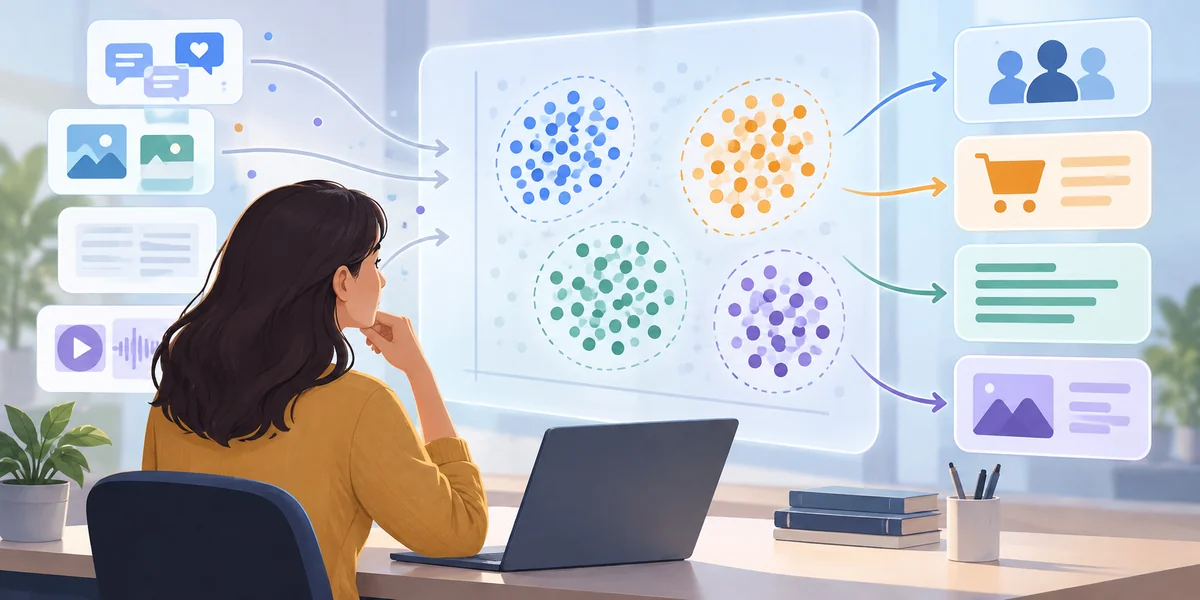
A continuación, se presentan algunos ejemplos del mundo real donde se aplica activamente el aprendizaje no supervisado:
Análisis de Redes Sociales: Las plataformas de redes sociales utilizan el aprendizaje no supervisado para analizar publicaciones, comentarios e interacciones, identificando temas de interés, sentimientos o tendencias emergentes. Estos conocimientos ayudan a las empresas y organizaciones a comprender la opinión pública o el comportamiento del cliente. Por ejemplo, Twitter emplea técnicas de aprendizaje no supervisado para identificar hashtags populares o temas emergentes en tiempo real.
Datos de Salud: En el ámbito de la salud, el aprendizaje no supervisado identifica patrones en los datos de los pacientes, como agrupar pacientes con síntomas similares o descubrir nuevos subtipos de enfermedades. Esto tiene implicaciones significativas para la medicina personalizada y la mejora del cuidado del paciente.
Agrupamiento de Documentos: El aprendizaje no supervisado también se utiliza para agrupar documentos o artículos en categorías. Las agencias de noticias o los agregadores de contenido, por ejemplo, emplean el agrupamiento para agrupar artículos similares, mejorando los motores de recomendación de contenido y ayudando a los lectores a encontrar rápidamente artículos relevantes.
Conclusión
El aprendizaje no supervisado es una técnica crítica en el aprendizaje automático, que permite la extracción de patrones y estructuras valiosas a partir de datos no etiquetados. A pesar de los desafíos en la evaluación e interpretación, su capacidad para descubrir conocimientos ocultos lo convierte en una herramienta poderosa para diversas aplicaciones, desde la segmentación de clientes hasta la detección de anomalías y más allá. A medida que los datos continúan creciendo exponencialmente, el papel del aprendizaje no supervisado será cada vez más significativo para ayudar a las empresas e investigadores a descifrar conjuntos de datos complejos.
Artículos relacionados
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Comprendiendo el Impacto de la IA en la Escritura Creativa
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
El Impacto de los GANs en la Autenticidad de los Medios
ChatGPT está reemplazando rápidamente estos 4 tipos de sitios web populares
Impulsando la IA: La Energía Detrás de los Grandes Modelos de Aprendizaje Automático
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Explorando el Aprendizaje Supervisado: Conceptos Clave y Aplicaciones
¿Qué son las Redes Generativas Adversarias (GANs)?
Prueba Estos 7 Proyectos de Agentes de IA para Mejorar tus Habilidades en Automatización
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
