
Explorando el Aprendizaje Supervisado: Conceptos Clave y Aplicaciones
En esta página
El aprendizaje supervisado es un pilar fundamental de la metodología de la inteligencia artificial (IA). Históricamente, los datos etiquetados han sido cruciales para ayudar a las computadoras a realizar predicciones precisas. En el aprendizaje supervisado, se entrena un modelo de aprendizaje automático utilizando datos que vienen con entradas y salidas predefinidas, permitiendo que el modelo anticipe resultados para datos no vistos.
Para numerosas aplicaciones de IA en el mundo real, como el filtrado de correos electrónicos y el reconocimiento de voz, el aprendizaje supervisado es esencial. Al aprender de la entrada humana, los sistemas pueden identificar patrones, categorizar datos y realizar predicciones altamente precisas. Sin esta técnica, muchas de las tecnologías de IA actuales no funcionarían tan efectivamente.
¿Qué es el Aprendizaje Supervisado?
El aprendizaje supervisado implica entrenar una computadora con datos etiquetados. Cada pieza de datos de entrenamiento incluye la respuesta correcta, que el modelo utiliza para aprender y predecir. El objetivo principal es mapear los datos de entrada a la salida correcta, permitiendo que el sistema tome decisiones informadas con nuevos datos.
Por ejemplo, en tareas de reconocimiento de imágenes, los modelos se entrenan con imágenes etiquetadas de gatos y perros. Cada imagen está etiquetada con una etiqueta como "gato" o "perro", lo que permite al modelo distinguir entre estos animales. Con suficiente entrenamiento, el sistema puede identificar si una imagen desconocida representa un gato o un perro.
El Proceso de Aprendizaje Supervisado
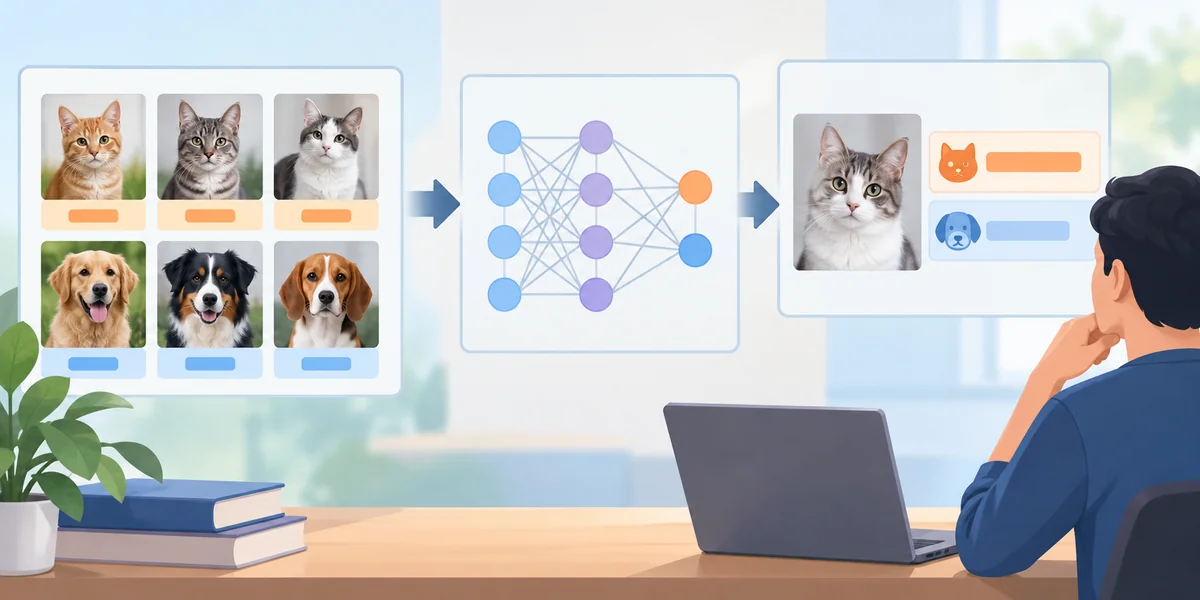
El proceso de aprendizaje supervisado generalmente sigue estos pasos:
- Recolección de Datos: Reunir grandes conjuntos de datos etiquetados, que incluyan diversas entradas y las salidas correctas correspondientes.
- Preprocesamiento de Datos: Limpiar y organizar los datos, lo que puede implicar eliminar duplicados, imputar valores faltantes o normalizar datos.
- Selección de Modelo: Elegir un algoritmo de aprendizaje automático adecuado, como árboles de decisión, máquinas de vectores de soporte o redes neuronales, según el problema.
- Entrenamiento del Modelo: Entrenar el modelo utilizando datos etiquetados. El algoritmo aprende comparando las predicciones con las etiquetas reales y ajustando para minimizar errores.
- Evaluación del Modelo: Probar el modelo con datos no vistos para evaluar su rendimiento utilizando métricas como precisión, exactitud, recuerdo y puntuación F1.
- Optimización del Modelo: Afinar el modelo en función de las evaluaciones para mejorar las predicciones, a menudo ajustando parámetros o empleando diferentes técnicas de entrenamiento.
Tipos Clave de Algoritmos de Aprendizaje Supervisado
Se utilizan varios algoritmos en el aprendizaje supervisado, cada uno con fortalezas y debilidades únicas dependiendo del tipo de datos y el problema en cuestión. Aquí hay algunos de los más utilizados:
Regresión Lineal:
Utilizada para predecir valores continuos, como los precios de viviendas basados en características como el metraje cuadrado, el número de habitaciones y la ubicación.
Regresión Logística:
A pesar de su nombre, la regresión logística se aplica a problemas de clasificación, prediciendo resultados binarios como si un correo electrónico es spam.
Árboles de Decisión:
Modelos que dividen datos en subconjuntos basados en características, llevando a predicciones. Son fáciles de interpretar y entender.
Máquinas de Vectores de Soporte (SVM):
Efectivas para tareas de clasificación, especialmente cuando los datos no son linealmente separables. Determinan el límite óptimo (hiperplano) que divide las clases.
Redes Neuronales:
Modelos complejos adecuados para tareas como el reconocimiento de imágenes y el procesamiento del lenguaje natural, simulando el cerebro humano para aprender de extensos datos.
Aplicaciones del Aprendizaje Supervisado
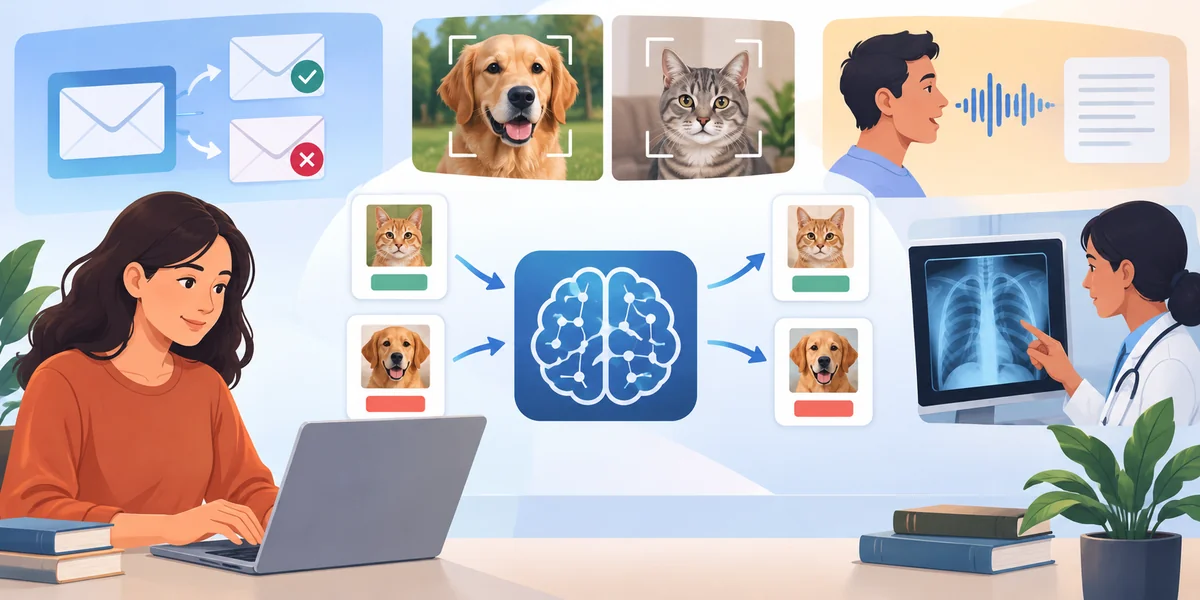
El aprendizaje supervisado cuenta con numerosas aplicaciones en el mundo real para tareas que necesitan predicciones o clasificaciones. Aquí algunos ejemplos:
Filtrado de Correos Electrónicos:
Utilizado en filtros de spam, donde algoritmos entrenados con correos etiquetados (spam/no-spam) clasifican nuevos correos electrónicos basados en patrones aprendidos.
Reconocimiento de Imágenes y Voz:
Esencial en sistemas como el reconocimiento facial y aplicaciones de voz a texto, entrenando en imágenes o muestras de audio etiquetadas para predicciones precisas.
Diagnóstico Médico:
Asiste en la atención médica al predecir enfermedades basadas en datos de pacientes. Modelos entrenados en datos médicos históricos con resultados etiquetados pronostican diagnósticos futuros.
Predicción Financiera:
Predice tendencias del mercado de valores, puntajes de crédito o aprobaciones de préstamos analizando datos históricos.
Desafíos en el Aprendizaje Supervisado
A pesar de su poder, el aprendizaje supervisado presenta desafíos, que incluyen:
Calidad de los Datos:
La precisión del modelo depende en gran medida de la calidad de los datos. Datos ruidosos, incompletos o sesgados pueden degradar el rendimiento.
Sobreajuste:
Ocurre cuando un modelo aprende demasiado bien los detalles de los datos de entrenamiento, incluido el ruido, resultando en un mal rendimiento en datos nuevos. La regularización y una evaluación exhaustiva son cruciales.
Etiquetado de Datos:
Etiquetar manualmente grandes conjuntos de datos puede ser tedioso y costoso, pero los datos etiquetados de alta calidad son vitales para la efectividad.
Conclusión
El aprendizaje supervisado es la base de la IA moderna, permitiendo que los sistemas realicen predicciones y decisiones inteligentes. Desde el reconocimiento de imágenes hasta la previsión financiera, sus aplicaciones son vastas. A medida que la tecnología avanza, el aprendizaje supervisado sigue siendo esencial en el desarrollo de sistemas de IA más inteligentes. Comprender sus conceptos y aplicaciones fundamentales mejora nuestra apreciación de cómo da forma a nuestro mundo y potencia las tecnologías de las que dependemos a diario.
Artículos relacionados
Comprendiendo el Impacto de la IA en la Escritura Creativa
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
¿Qué son las Redes Generativas Adversarias (GANs)?
Prueba Estos 7 Proyectos de Agentes de IA para Mejorar tus Habilidades en Automatización
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información
IA Tradicional vs IA Generativa
Robots Sociales y Amigos Virtuales: El Nuevo Rostro de la Compañía AI
Implicaciones Éticas del Contenido Generado por IA en Medios y Arte
IA en Petróleo y Gas: Mejorando la Eficiencia en Exploración y Producción
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
Transformando la Planificación Urbana Usando Tecnología Avanzada de IA Basada en Datos
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
