
Sobreajuste y Subajuste: Conceptos Clave en el Desarrollo de Modelos de IA
En esta página
En el ámbito del aprendizaje automático y la IA, lograr un rendimiento óptimo del modelo es crucial. Dos problemas comunes que afectan este rendimiento son el sobreajuste y el subajuste. El sobreajuste ocurre cuando un modelo se vuelve demasiado complejo y se ajusta demasiado a los datos de entrenamiento, mientras que el subajuste sucede cuando el modelo es demasiado simplista y no logra capturar los patrones en los datos. Encontrar un equilibrio entre estos extremos es esencial para desarrollar modelos de IA que se generalicen bien y hagan predicciones precisas en nuevos datos.
Entendiendo el Sobreajuste
El sobreajuste ocurre cuando un modelo se vuelve excesivamente complejo, "memorizando" efectivamente los datos de entrenamiento en lugar de aprender a generalizar para datos no vistos. Esto significa que el modelo funciona excepcionalmente bien en los datos de entrenamiento, pero tiene dificultades para hacer predicciones precisas en nuevos datos.
Indicadores Clave de Sobreajuste:
- Alta precisión en el conjunto de entrenamiento
- Pobre rendimiento en datos de validación o prueba
- Un modelo excesivamente detallado que captura ruido en lugar de tendencias subyacentes
El sobreajuste es similar a memorizar respuestas a preguntas específicas en lugar de comprender el concepto más amplio. A menudo surge cuando un modelo tiene demasiados parámetros o se entrena en exceso con datos limitados.
Entendiendo el Subajuste
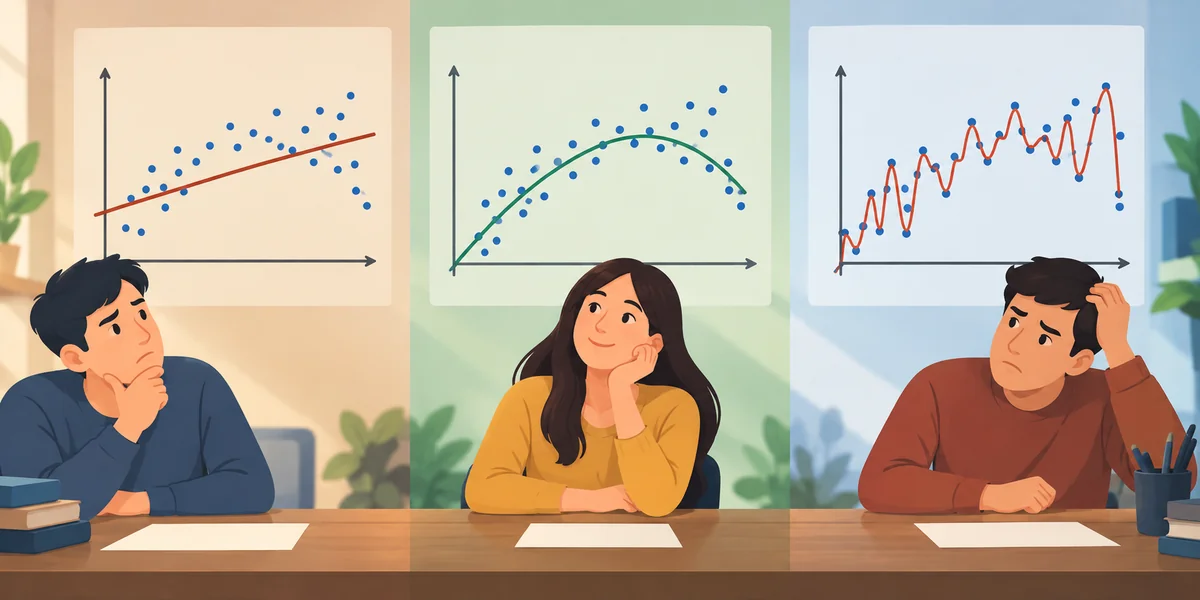
El subajuste ocurre cuando un modelo es demasiado simplista para detectar los patrones en los datos, lo que resulta en un mal rendimiento tanto en el conjunto de entrenamiento como en datos no vistos. Esto puede indicar que el modelo carece de la complejidad necesaria para aprender las relaciones subyacentes, lo que lleva a predicciones inexactas.
Indicadores Clave de Subajuste:
- Baja precisión en los conjuntos de entrenamiento y prueba
- Un modelo excesivamente simplista incapaz de captar patrones complejos
- Uso de muy pocos parámetros o modelos excesivamente simplificados
El subajuste es como intentar responder preguntas sin entender el material central, lo que hace que el modelo no pueda predecir con precisión ni siquiera los resultados más simples.
Impacto del Sobreajuste y Subajuste en el Rendimiento del Modelo de IA
Tanto el sobreajuste como el subajuste afectan negativamente a los modelos de aprendizaje automático, aunque de diferentes maneras. Mientras que el sobreajuste resulta en un modelo demasiado adaptado a los datos de entrenamiento, el subajuste conduce a un modelo que no aprende lo suficiente de los datos. Un modelo bien equilibrado debería generalizarse efectivamente a datos no vistos, manteniendo un equilibrio entre complejidad y simplicidad. Sin este equilibrio, las predicciones del modelo serán inexactas y poco fiables.
Efectos del Sobreajuste en Modelos de IA:
- Reducción de la generalización del modelo
- Aumento de la tasa de error en datos nuevos, no vistos
Efectos del Subajuste en Modelos de IA:
- Pobre rendimiento en todos los conjuntos de datos
- Falta de complejidad en las predicciones
Estrategias para Prevenir el Sobreajuste
Los científicos de datos emplean varias estrategias para mitigar el sobreajuste. Estas técnicas buscan simplificar el modelo mientras capturan los patrones esenciales de los datos.
Regularización:
Los métodos de regularización como las penalizaciones L1 y L2 introducen un costo para parámetros de modelo más grandes, alentando al modelo a permanecer simple y evitar ajustar el ruido.
Validación Cruzada:
La validación cruzada implica dividir los datos en múltiples partes y entrenar el modelo en diferentes subconjuntos. Este enfoque permite una evaluación más precisa de la capacidad del modelo para generalizarse a nuevos datos.
Poda:
En árboles de decisión, la poda elimina ramas innecesarias que aportan poco al poder predictivo del modelo, simplificando efectivamente el modelo.
Estrategias para Prevenir el Subajuste
Mientras que el sobreajuste requiere reducir la complejidad, el subajuste requiere mejorar la capacidad de aprendizaje del modelo. Aquí hay algunas técnicas para evitar el subajuste:
Aumentar la Complejidad del Modelo:
Si un modelo está subajustando, puede ser demasiado simple para capturar las relaciones de los datos. Agregar más parámetros o usar un algoritmo más complejo puede mejorar la capacidad de aprendizaje del modelo.
Tiempo de Entrenamiento Extendido:
A veces, un modelo necesita entrenamiento adicional para comprender los patrones subyacentes. Permitir que el modelo entrene más tiempo puede prevenir el subajuste, especialmente en modelos de aprendizaje profundo.
El Papel de los Datos en el Sobreajuste y Subajuste
La calidad y cantidad de los datos impactan significativamente tanto en el sobreajuste como en el subajuste. Datos insuficientes pueden causar subajuste, mientras que datos excesivos que no son representativos pueden llevar al sobreajuste.
Calidad de los Datos:
Datos de alta calidad, con mínimo ruido y valores atípicos, ayudan a prevenir el sobreajuste al permitir que el modelo se enfoque en patrones esenciales. También previene el subajuste al proporcionar suficiente variabilidad para un aprendizaje efectivo.
Cantidad de Datos:
Un mayor volumen de datos puede prevenir el sobreajuste al permitir que el modelo se generalice a través de diversos escenarios. Por el contrario, muy pocos datos pueden llevar al subajuste debido a la insuficiente variación de la que el modelo puede aprender.
Evaluando el Rendimiento del Modelo: Equilibrando el Sobreajuste y Subajuste
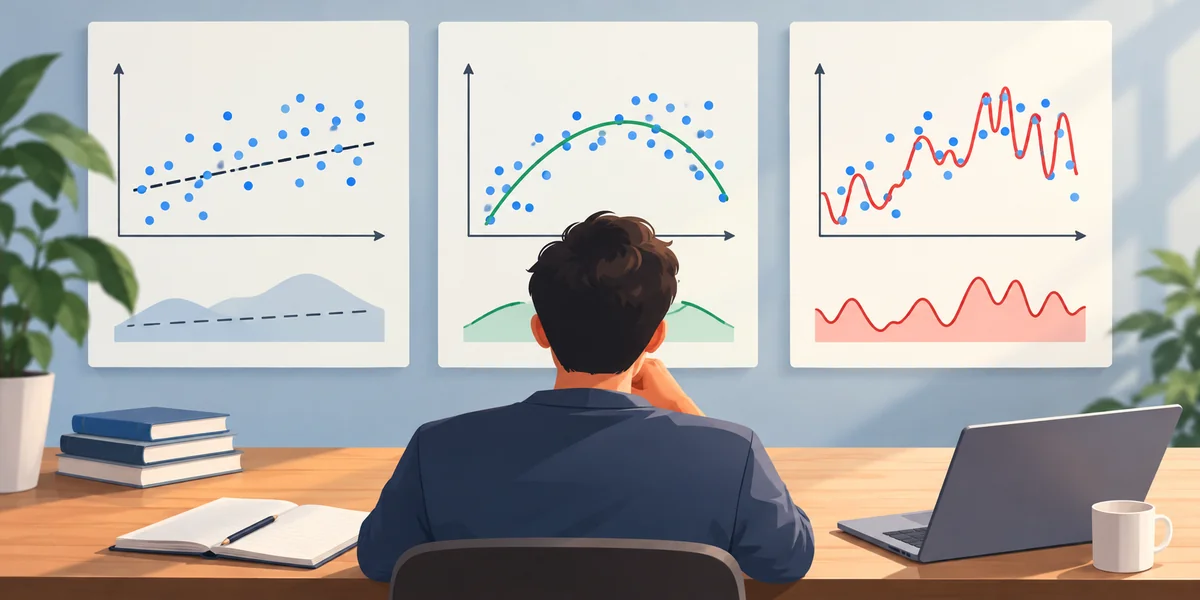
Después de entrenar un modelo, es crucial evaluar su rendimiento para verificar si hay sobreajuste o subajuste. Esto se puede hacer utilizando varias métricas y técnicas, incluyendo:
Precisión:
La precisión mide la proporción de resultados correctamente predichos. Sin embargo, confiar únicamente en la precisión puede ser engañoso si el modelo está sobreajustando o subajustando, por lo que a menudo se consideran métricas adicionales.
Precisión y Recuperación:
La precisión mide la corrección de las predicciones positivas, mientras que la recuperación evalúa la capacidad del modelo para identificar todas las instancias positivas. Estas métricas ofrecen una evaluación más completa del rendimiento del modelo que solo la precisión.
Puntuación F1:
La puntuación F1 combina precisión y recuperación en una sola métrica, proporcionando una evaluación más equilibrada del poder predictivo de un modelo.
Conclusión
El sobreajuste y el subajuste son desafíos comunes en la construcción de modelos de IA. Sin embargo, con técnicas adecuadas y un enfoque equilibrado, es posible desarrollar modelos que funcionen bien tanto en datos de entrenamiento como en datos no vistos. Al gestionar cuidadosamente la complejidad del modelo, asegurar la calidad de los datos y aplicar estrategias como la regularización y la validación cruzada, los practicantes de IA pueden construir modelos que se generalicen efectivamente, ofreciendo predicciones confiables.
Artículos relacionados
Cómo las Comunidades de IA de Código Abierto Están Cambiando el Futuro de la Tecnología
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Aprendizaje Automático: Modelos Listos para Usar o Personalizados - Pros y Contras
Por qué el Deep Learning Puede No Ser la Solución Adecuada para Su Negocio
Explorando Cómo la IA Está Transformando el Trabajo de los Equipos Financieros Modernos
Comprendiendo los Modelos Semánticos de Power BI para un Análisis Más Inteligente
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
El Impacto de los Datos Masivos en la Inteligencia Artificial y su Rol
IA Generativa para Científicos de Datos en 2025: Más Allá de la Generación de Texto
OpenHands: Desarrollador de Software de IA de Código Abierto
¿Cómo se Entrenan las Herramientas de IA?
Marketing de Contenidos para SaaS de IA: Creando Contenido que Educa y Convierte
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
