
Guía de 7 Modelos de IA Multimodal y Sus Casos de Uso Cotidianos
En esta página
La Inteligencia Artificial ha alcanzado un nuevo hito, permitiendo a las máquinas comprender el mundo de manera similar a los humanos, a través de una combinación de lenguaje, imágenes, audio e incluso video. Este avance es posible gracias a los modelos de IA multimodal, que pueden analizar y generar contenido a través de diversos tipos de datos simultáneamente.
Estos modelos están transformando industrias al generar visuales a partir de descripciones textuales e interpretar consultas sobre imágenes subidas. Ya sea que estés involucrado en la creación de contenido, educación, comercio electrónico o soporte al cliente, estas herramientas superan las capacidades de los modelos tradicionales de entrada única. Aquí exploramos siete de los modelos multimodales más utilizados e impactantes en la actualidad y sus aplicaciones en diversos escenarios del mundo real.
1. Llama 3.2 90B
Llama 3.2 90B, desarrollado por Meta AI, es el modelo multimodal de código abierto más robusto disponible. Destaca en la combinación de datos de texto e imagen para seguir instrucciones complejas y generar respuestas perspicaces.
Casos de Uso:
- Las plataformas educativas y de e-learning se benefician de la capacidad de Llama para interpretar diagramas, gráficos o problemas científicos y proporcionar explicaciones contextuales.
- En sistemas de soporte técnico, los usuarios pueden subir capturas de pantalla de errores, y el modelo los guía a través de soluciones utilizando una combinación de instrucciones textuales y referencias visuales.
- El contenido de capacitación digital se enriquece al generar explicaciones basadas en imágenes o manuales, convirtiendo a Llama en un favorito entre los desarrolladores que crean herramientas de aprendizaje.
2. Gemini 1.5 Flash
Gemini 1.5 Flash de Google es una potencia multimodal que procesa texto, imágenes, audio y video simultáneamente. Construido para la velocidad y la escala, es particularmente efectivo en aplicaciones que requieren cambios rápidos de contexto entre diversos tipos de entrada.
Casos de Uso:
- Los asistentes virtuales inteligentes utilizan Gemini para interpretar comandos de audio, analizar imágenes adjuntas y proporcionar respuestas detalladas. Por ejemplo, un usuario podría preguntar: “¿Qué está mal con este documento?” mientras sube una foto del formulario, y Gemini podría identificar problemas de formato.
- La creación de contenido asiste a los mercadólogos en la generación de campañas multimedia al combinar texto con visuales sugeridos e incluso fragmentos de video, agilizando los flujos de trabajo creativos.
- Las plataformas de salud aprovechan Gemini para interpretar grabaciones de video del comportamiento del paciente, junto con notas clínicas e insumos de voz grabados, para ayudar con los diagnósticos o el seguimiento del progreso.
3. Florence 2
Desarrollado por Microsoft, Florence 2 es un modelo ligero pero de alto rendimiento enfocado en tareas de visión-lenguaje. Su fortaleza radica en el análisis de imágenes mientras integra consultas textuales, haciéndolo altamente efectivo para aplicaciones de visión por computadora.
Casos de Uso:
- Las plataformas de comercio electrónico utilizan Florence 2 para mejorar la búsqueda al emparejar listados de productos con imágenes subidas por los usuarios. Una persona que busca un estilo específico de zapato puede tomar una foto, y Florence encuentra opciones similares al instante.
- En el etiquetado automatizado de contenido, sitios web y archivos digitales aplican el modelo para etiquetar imágenes con palabras clave relevantes, ahorrando horas de trabajo manual.
- Las herramientas de accesibilidad pueden usar Florence para generar descripciones ricas de imágenes, ayudando a los usuarios con discapacidad visual a comprender mejor el contenido visual a través de lectores de pantalla.
4. GPT-4o
GPT-4o, de OpenAI, es un modelo multimodal optimizado que combina un rendimiento rápido con la capacidad de interpretar información tanto textual como visual. Diseñado para la eficiencia, es particularmente adecuado para sistemas en tiempo real que requieren respuestas inteligentes y rápidas.
Casos de Uso:
- Los bots de servicio al cliente impulsados por GPT-4o pueden comprender entradas visuales como fotos de productos o capturas de pantalla de aplicaciones enviadas por los usuarios y ofrecer respuestas de soporte precisas al instante.
- En la escritura creativa y la publicación, los escritores utilizan GPT-4o para generar ideas de escenas o historias inspiradas en imágenes subidas. Por ejemplo, una foto de un bosque podría sugerir un escenario narrativo vívido.
- Las plataformas de software de presentación integran GPT-4o para mejorar el contenido de las diapositivas. Los usuarios suben sus diapositivas borrador, y el modelo revisa o mejora el lenguaje, asegurando claridad y compromiso.
5. Claude 3.5
Claude 3.5, de Anthropic, está diseñado con un fuerte enfoque en interacciones de IA seguras y éticas. Aunque admite tanto entradas de texto como de imagen como muchos otros, su característica destacada es su compromiso con respuestas responsables y similares a las humanas, lo que lo hace ideal para su uso en entornos sensibles.
Casos de Uso:
- En la educación en línea, Claude revisa asignaciones visuales o obras de arte y proporciona comentarios que son tanto constructivos como alentadores, ayudando a los estudiantes a crecer sin desmotivación.
- Las herramientas de moderación de redes sociales utilizan Claude para evaluar tanto imágenes como subtítulos de texto acompañantes, señalando contenido que viola los estándares de la comunidad mientras se minimizan los falsos positivos.
- Las plataformas de salud mental y bienestar implementan Claude para ayudar a los usuarios a reflexionar sobre diarios visuales o tableros de estado de ánimo, ofreciendo respuestas reflexivas y empáticas que apoyan el bienestar emocional.
6. LLaVA V1.5 7B
LLaVA V1.5 7B (Asistente de Gran Lenguaje y Visión) es un modelo de código abierto afinado para la interacción en tiempo real. Admite texto, imágenes y audio, siendo ideal para aplicaciones receptivas donde la latencia y el rendimiento son importantes.
Casos de Uso:
- Los compañeros de IA y agentes virtuales utilizan LLaVA para mantener conversaciones naturales mientras responden a imágenes o notas de voz subidas. Un usuario podría hacer una pregunta sobre una foto de producto, y el modelo responde al instante con ideas.
- Las herramientas de tecnología asistiva para usuarios con discapacidad visual confían en LLaVA para describir entornos, interpretar señales o leer texto en voz alta desde fotos en tiempo real.
- En las plataformas de aprendizaje de idiomas, crea experiencias inmersivas donde los usuarios reciben retroalimentación auditiva sobre indicaciones visuales o ejercicios.
7. DALL·E 3
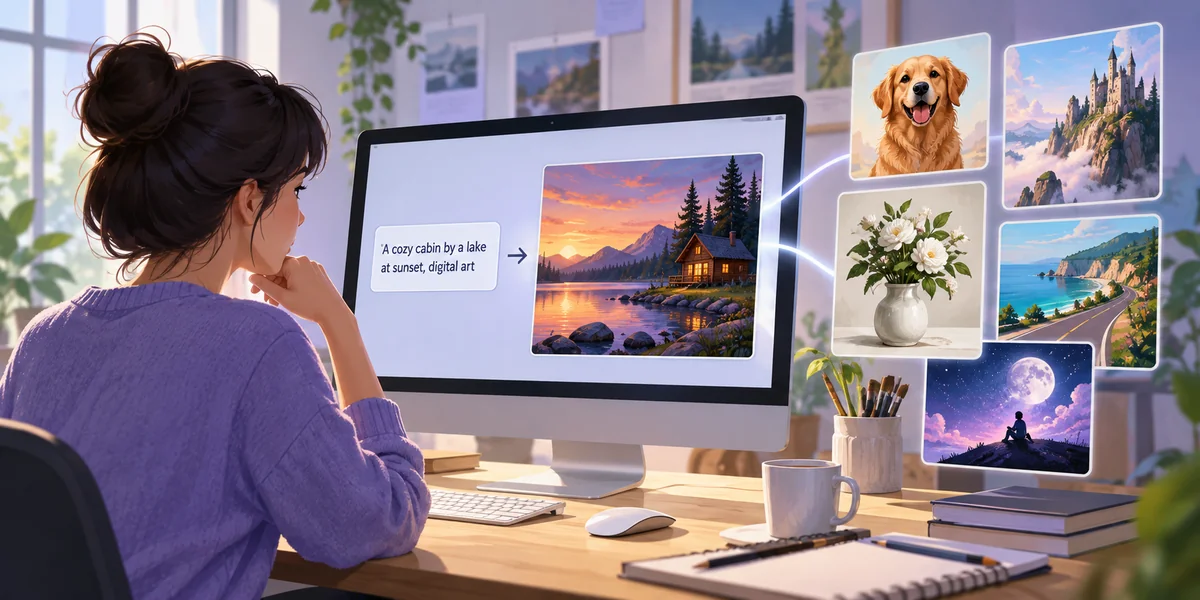
DALL·E 3, también desarrollado por OpenAI, se especializa en generar imágenes detalladas y creativas basadas únicamente en instrucciones de texto. También ofrece capacidades de inpainting, permitiendo a los usuarios modificar visuales existentes usando descripciones en lenguaje natural.
Casos de Uso:
- Los equipos de marketing generan visuales de campaña sin contratar diseñadores escribiendo una descripción de producto o lema y recibiendo un gráfico de alta calidad a cambio.
- Autores e ilustradores utilizan DALL·E para crear arte conceptual para libros, juegos o películas, traduciendo ideas narrativas en maquetas visuales.
- En la educación, los maestros diseñan hojas de trabajo personalizadas, gráficos o ilustraciones educativas con solo un aviso, ahorrando tiempo y esfuerzo en la preparación de contenido.
Conclusión
Los modelos de IA multimodal están remodelando rápidamente cómo interactuamos con la tecnología al permitir que los sistemas procesen y comprendan información a través de texto, imágenes, audio y video. Su capacidad para integrar múltiples tipos de datos abre la puerta a aplicaciones más intuitivas, inteligentes y personalizadas en diversas industrias. Desde la educación y la creación de contenido hasta el servicio al cliente y la accesibilidad, cada modelo trae fortalezas únicas a escenarios específicos del mundo real.
Artículos relacionados
Dentro de Jamba 1.5: Transformer y Mamba se Encuentran en una Arquitectura
Descubre los 5 Avances Más Innovadores en IA Generativa que Vale la Pena Probar
GPT-4o vs Gemini 2.0 Flash: ¿Cuál Ofrece la Mejor Experiencia de IA?
Sobreajuste y Subajuste: Conceptos Clave en el Desarrollo de Modelos de IA

Creación de Aplicaciones de IA con Gemini 2.0
Comprendiendo los Modelos Semánticos de Power BI para un Análisis Más Inteligente
Comprendiendo el Análisis Facial en la Tecnología de Segmentación Semántica
¿Qué es el Patrón Multiagente de AI Agente y Por Qué es un Cambio de Juego?
Nvidia Apunta a la IA Agéntica y Física con Modelos de Razonamiento Avanzados
Redefiniendo la Inteligencia: Gemini 2.0 para una Nueva Era de IA
Una Guía Sencilla para Comparar las Características de DeepSeek-R1 y DeepSeek-V3
Una Guía Completa de las Funciones de Audio de OpenAI, Herramientas y Casos de Uso Reales
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
