
Una Guía Sencilla para Comparar las Características de DeepSeek-R1 y DeepSeek-V3
En esta página
En el mundo en constante evolución de la inteligencia artificial, los modelos de lenguaje nuevos y más complejos están transformando nuestra manera de abordar la resolución de problemas. DeepSeek, un líder en investigación de IA, ha presentado recientemente dos modelos innovadores: DeepSeek-V3 y DeepSeek-R1. Cada modelo tiene fortalezas y aplicaciones únicas, lo que los convierte en temas candentes en las discusiones sobre IA. En este artículo, proporcionaremos una comparación detallada entre DeepSeek-V3 y DeepSeek-R1, destacando cuál modelo se destaca en diversos escenarios.
Comprendiendo DeepSeek-V3 y DeepSeek-R1
Antes de profundizar en los detalles, establezcamos una comprensión fundamental de estos dos modelos poderosos.
- DeepSeek-V3 es un modelo de lenguaje avanzado de Mezcla de Expertos (MoE) con impresionantes 671 mil millones de parámetros. Su innovación radica en activar dinámicamente solo alrededor de 37 mil millones de parámetros por token, optimizando el rendimiento sin aumentar significativamente los costos computacionales. Entrenado en un vasto conjunto de datos de 14.8 billones de tokens, este modelo está diseñado para la escalabilidad, la aplicabilidad en dominios amplios y un despliegue rentable.
- DeepSeek-R1, lanzado poco después del V3, incorpora el Aprendizaje por Refuerzo (RL) en su régimen de entrenamiento para mejorar las capacidades de razonamiento. Aunque comparte la arquitectura fundamental de DeepSeek-V3, DeepSeek-R1 emplea un proceso de entrenamiento especializado que aprovecha el aprendizaje por refuerzo para refinar la toma de decisiones, el razonamiento lógico y la resolución estructurada de problemas.
Arquitecturas Comparativas: MoE vs. Aprendizaje por Refuerzo
La principal diferencia entre DeepSeek-V3 y DeepSeek-R1 radica en sus arquitecturas y metodologías de entrenamiento.
DeepSeek-V3: La Potencia de MoE
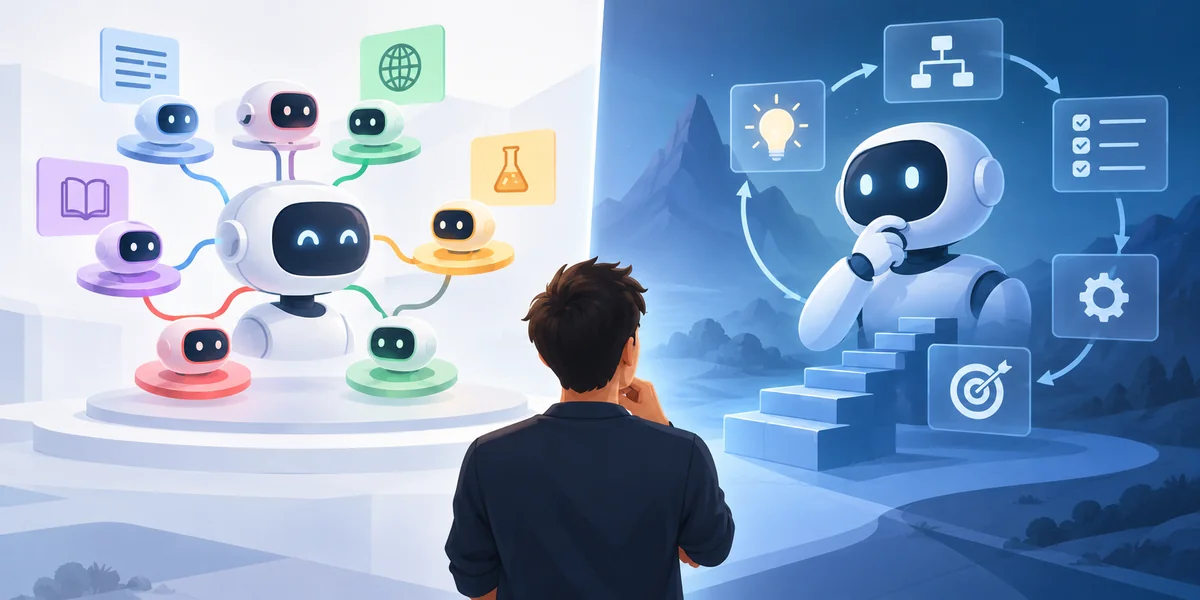
La arquitectura de DeepSeek-V3 presenta el enfoque de Mezcla de Expertos (MoE). MoE divide el conjunto de parámetros grandes del modelo en múltiples redes "expertas", cada una especializada en diferentes aspectos de la resolución de problemas.
El proceso de entrenamiento de DeepSeek-V3 involucra dos etapas principales:
- Etapa de Pre-entrenamiento: Entrenado extensamente en un corpus diverso, que incluye texto multilingüe, datos científicos y fuentes literarias. Este enorme conjunto de datos de 14.8 billones de tokens equipa al modelo con un extenso conocimiento específico del dominio y capacidades de propósito general.
- Fine-Tuning Supervisado (SFT): Después del pre-entrenamiento, DeepSeek-V3 se somete a un ajuste fino adicional con anotaciones curadas por humanos para mejorar la coherencia, la precisión gramatical y la relevancia contextual.
DeepSeek-R1: El Especialista en Aprendizaje por Refuerzo
En contraste, DeepSeek-R1 aprovecha los principios del aprendizaje por refuerzo para optimizar sus capacidades de razonamiento. A diferencia del enfoque MoE de V3, R1 se centra en tareas de estructuración lógica y resolución analítica de problemas a través de metodologías de RL como la Optimización de Política Relativa en Grupo (GRPO). Las diferencias clave en el entrenamiento incluyen:
- Fine-Tuning de Inicio en Frío: Inicialmente entrenado en datos más pequeños y meticulosamente anotados, enfocándose en ejemplos de razonamiento de alta calidad.
- Muestreo de Rechazo y Generación de Datos Sintéticos: DeepSeek-R1 genera múltiples respuestas potenciales, seleccionando solo las salidas de mejor calidad para un entrenamiento posterior, reforzando un comportamiento de razonamiento sólido.
- Entrenamiento Híbrido: Combina RL con conjuntos de datos de ajuste fino supervisados, produciendo salidas equilibradas impulsadas por el razonamiento alineadas con las preferencias humanas y la legibilidad.
Eficiencia Computacional: Manejo de Tareas a Gran Escala
Tanto DeepSeek-V3 como DeepSeek-R1 sobresalen en el manejo de tareas a gran escala, pero abordan la eficiencia computacional de manera diferente.
DeepSeek-V3: Escalado Eficiente con MoE
- La arquitectura MoE activa solo una fracción de sus 671 mil millones de parámetros (37 mil millones por token), reduciendo la sobrecarga computacional.
- Esta activación dinámica permite que DeepSeek-V3 escale de manera eficiente manteniendo bajos los costos operativos.
- Ideal para generación de texto a gran escala y procesamiento de dominios diversos, DeepSeek-V3 maneja eficientemente conjuntos de datos extensos y solicitudes de alto rendimiento.
DeepSeek-R1: Eficiencia del Aprendizaje por Refuerzo
- Confía en el aprendizaje por refuerzo (RL) para la eficiencia, sin MoE.
- La Optimización de Política Relativa en Grupo (GRPO) reduce la necesidad de modelos críticos, disminuyendo los costos computacionales.
- Bien adaptado para tareas de razonamiento, DeepSeek-R1 sobresale en la resolución de problemas complejos como tareas matemáticas o lógicas, incluso con conjuntos de datos más pequeños.
En resumen, DeepSeek-V3 está optimizado para el escalado general, mientras que DeepSeek-R1 logra eficiencia en tareas impulsadas por el razonamiento.
Flexibilidad y Adaptabilidad: Adaptándose a Necesidades Específicas
Tanto DeepSeek-V3 como DeepSeek-R1 ofrecen ventajas únicas en cuanto a flexibilidad y adaptabilidad, pero sus fortalezas están adaptadas a diferentes casos de uso.
DeepSeek-V3: Versátil para Tareas Generales
- Aplicaciones de Amplio Alcance: Gracias a su arquitectura MoE, DeepSeek-V3 es adaptable a muchos dominios, desde la generación de contenido hasta la recuperación de conocimiento.
- Multilingüe y Multidominio: Entrenado en 14.8 billones de tokens, sobresale en tareas de lenguaje diverso y puede adaptarse rápidamente a nuevos campos sin un reentrenamiento extenso.
- Eficiencia en Uso General: Su capacidad para activar solo expertos relevantes le permite escalar rápidamente en múltiples tareas, convirtiéndolo en una solución de referencia para aplicaciones de IA de propósito general.
DeepSeek-R1: Especialización para Razonamiento Profundo
- Optimizado para Razonamiento Complejo: Al utilizar el aprendizaje por refuerzo (RL), DeepSeek-R1 es más adaptable a tareas que requieren pensamiento estructurado y análisis lógico, como la resolución de problemas o el razonamiento matemático.
- Auto-Mejora: A través del muestreo de rechazo y la optimización impulsada por RL, R1 puede refinar su rendimiento de manera iterativa, asegurándose de manejar consultas complejas con mayor precisión con el tiempo.
- Experiencia Enfocada: Aunque menos versátil para tareas generales, DeepSeek-R1 sobresale en campos que demandan un análisis profundo, como la investigación científica y la codificación.
Elegir el Modelo Correcto: Guías de Decisión
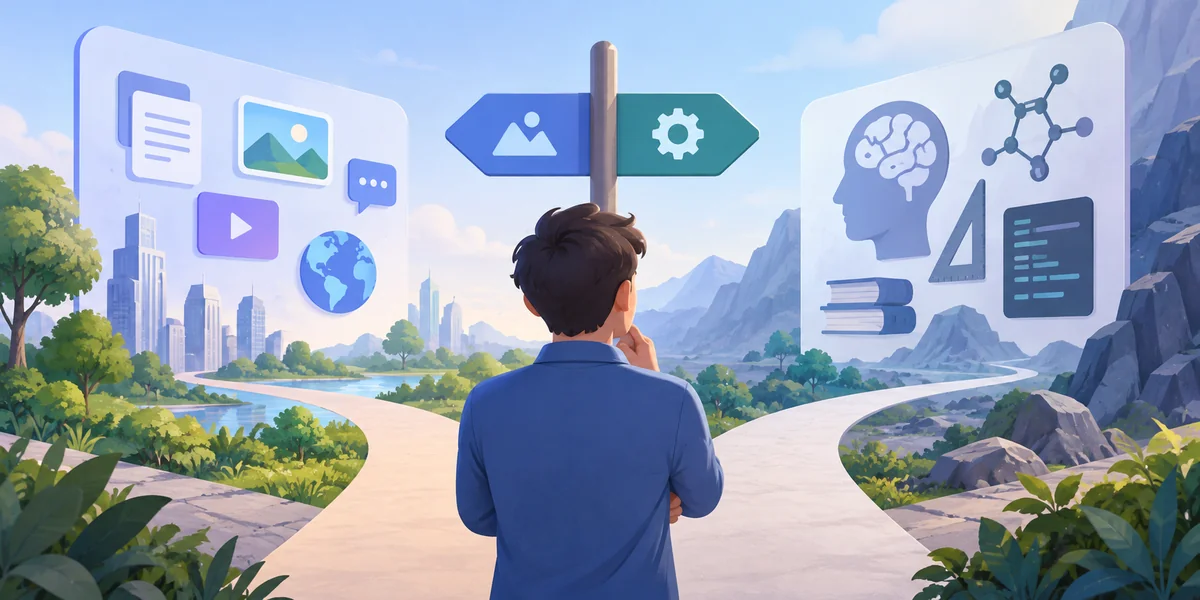
Elegir entre estos dos gigantes de la IA depende de tus necesidades específicas. Considera los siguientes criterios de toma de decisiones:
Opta por DeepSeek-V3 si:
- Tus aplicaciones requieren amplias capacidades de PLN sin demandas intensivas de razonamiento.
- La escalabilidad y la eficiencia de costos son prioridades altas.
- Tus tareas implican grandes volúmenes de generación de contenido de propósito general y multidominio.
Opta por DeepSeek-R1 si:
- Tu objetivo principal gira en torno al razonamiento estructurado, tareas intensivas en lógica y precisión computacional.
- Las tareas incluyen razonamiento matemático complejo, problemas de codificación en profundidad, análisis científicos o procesos intensivos en decisiones.
- Los presupuestos operativos pueden acomodar gastos computacionales más altos para capacidades de razonamiento premium.
Conclusión
Tanto DeepSeek-V3 como DeepSeek-R1 representan avances innovadores en IA, cada uno destacándose en diferentes áreas. DeepSeek-V3 brilla con su escalabilidad, eficiencia de costos y capacidad para manejar tareas de propósito general en varios dominios, haciéndolo ideal para aplicaciones a gran escala. Por otro lado, DeepSeek-R1 aprovecha el aprendizaje por refuerzo para especializarse en tareas intensivas en razonamiento, como la resolución de problemas matemáticos y el análisis lógico, ofreciendo un rendimiento superior en esas áreas.
La elección entre los dos modelos depende en última instancia de las necesidades específicas de la aplicación, con V3 ofreciendo versatilidad y R1 proporcionando profundidad en campos especializados. Al comprender sus fortalezas, los usuarios pueden seleccionar efectivamente el modelo correcto para optimizar sus soluciones de IA.
Artículos relacionados
Revisión Exhaustiva de las Herramientas de IA Generativa de Adobe
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
3 Historias Inspiradoras de Líderes en IA
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
Sobreajuste y Subajuste: Conceptos Clave en el Desarrollo de Modelos de IA
Cómo la IA está Transformando la Industria Minorista
Entendiendo los Límites: Las Limitaciones de Trabajo de los Modelos de Lenguaje Extensos
Por qué los Modelos de Lenguaje Pequeños Están en Auge
Descubre los Beneficios de la RPA y sus Inconvenientes por Industria
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
Comprendiendo los Modelos Semánticos de Power BI para un Análisis Más Inteligente
Aplicaciones de Aprendizaje de Idiomas Impulsadas por IA para un Aprendizaje Personalizado e Inteligente
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
