
MiniRAG: Generación Aumentada por Recuperación Más Inteligente para Modelos de IA Pequeños
En esta página
A medida que la inteligencia artificial sigue creciendo, los grandes modelos de lenguaje (LLMs) se han hecho conocidos por sus potentes capacidades. Sin embargo, su tamaño a menudo implica altos costos en términos de memoria, computación y complejidad de implementación. Este desafío ha llevado al surgimiento de modelos de lenguaje pequeños (SLMs), que buscan llevar los beneficios de la IA a entornos con pocos recursos. Una de las técnicas más prometedoras para mejorar estos modelos es MiniRAG, abreviatura de Mini Generación Aumentada por Recuperación.
MiniRAG ayuda a los modelos de lenguaje pequeños a superar sus limitaciones combinando métodos de recuperación inteligente con generación de lenguaje. Este enfoque permite que los modelos compactos produzcan respuestas de alta calidad sin necesidad de almacenar todo el conocimiento internamente.
¿Qué es MiniRAG?
MiniRAG significa Mini Generación Aumentada por Recuperación. Es una técnica que combina un modelo de lenguaje pequeño con un recuperador de datos externo. En lugar de obligar al modelo a "recordar" todo, MiniRAG le ayuda a buscar la información relevante y generar mejores respuestas basadas en eso. Este método se inspira en los sistemas RAG tradicionales utilizados en modelos grandes como GPT-4 o Claude, pero está cuidadosamente adaptado para funcionar eficientemente con modelos que tienen menos parámetros.
¿Por Qué la Recuperación es Importante para los Modelos de Lenguaje Pequeños?
Los modelos de lenguaje pequeños a menudo enfrentan limitaciones debido a su reducido número de parámetros y conjuntos de datos de entrenamiento más pequeños. Estas limitaciones afectan su capacidad para recordar información, comprender contextos complejos o proporcionar hechos precisos. MiniRAG soluciona este problema conectando el modelo con un conocimiento externo en lugar de aumentar el tamaño del modelo.
Algunos beneficios clave de MiniRAG para modelos pequeños incluyen:
- Mejora en la precisión factual: Las respuestas se basan en documentos reales.
- Bajo uso de memoria: El modelo no necesita memorizar todo internamente.
- Reducción de alucinaciones: Las respuestas son más basadas en hechos y confiables.
- Personalización: Los usuarios pueden agregar o actualizar sus propias fuentes de datos fácilmente.
- Bajo costo: Permite resultados inteligentes en dispositivos asequibles.
Esto hace que MiniRAG sea especialmente útil en situaciones donde los recursos informáticos son limitados o se requieren actualizaciones en tiempo real.
Cómo Funciona MiniRAG Paso a Paso
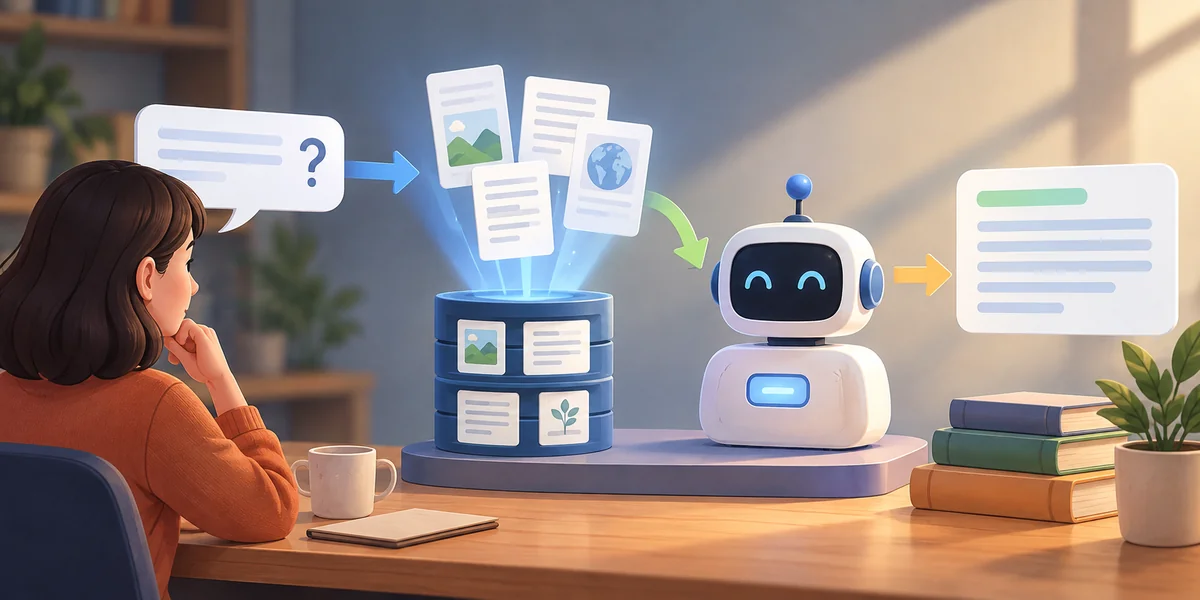
MiniRAG sigue una tubería bien estructurada que combina un módulo de recuperación y un modelo de lenguaje pequeño. El proceso es simple pero altamente efectivo.
Flujo de Trabajo de Generación Aumentada por Recuperación
Así es como típicamente funciona un sistema basado en MiniRAG:
- Entrada del Usuario
Un usuario envía una pregunta o solicitud. - Incrustación de Consultas
La consulta se convierte en un vector (formato numérico) utilizando un modelo de incrustación. - Recuperación de Documentos
El vector se utiliza para buscar en una base de datos o tienda de vectores contenido similar. Herramientas como FAISS, Chroma o Weaviate son comúnmente usadas. - Selección de Fragmentos Relevantes
Se seleccionan y formatean para el modelo los fragmentos de documentos que más coincidan. - Generación de Respuestas
El modelo de lenguaje pequeño lee el contexto y genera una respuesta basada en el material recuperado.
Usando este enfoque híbrido de búsqueda y generación, MiniRAG asegura que las respuestas sean tanto relevantes como fundamentadas en fuentes confiables.
¿Qué Hace a MiniRAG Diferente del RAG Estándar?
Aunque la idea central detrás de MiniRAG y el RAG tradicional es la misma, los objetivos de diseño son bastante diferentes. El RAG estándar está optimizado para grandes LLMs que pueden manejar múltiples documentos, contextos más largos y tareas de razonamiento complejas. MiniRAG, por otro lado, se enfoca en ser ligero, eficiente y adaptable para entornos restringidos.
Aquí hay una comparación rápida:
| Característica | RAG Tradicional | MiniRAG |
|---|---|---|
| Tamaño del Modelo Objetivo | Grande (e.g. GPT-3) | Pequeño (e.g. TinyLlama) |
| Requerimientos de Hardware | Altos | Bajos |
| Adecuado para | Nube, empresa | Dispositivos móviles, de borde |
| Latencia | Moderada a alta | Baja |
| Uso de Memoria | Alto | Mínimo |
MiniRAG permite que los modelos más pequeños sigan siendo competitivos mientras son más rentables y eficientes en el uso de energía.
Casos de Uso Donde MiniRAG Brilla
MiniRAG está diseñado para llevar capacidades avanzadas a áreas que anteriormente estaban fuera del alcance para los modelos pequeños. Puede ser implementado en varios escenarios prácticos:
Principales Casos de Uso para MiniRAG
- Sistemas de Soporte al Cliente
MiniRAG puede impulsar chatbots que acceden a manuales de soporte y bases de conocimiento para proporcionar respuestas precisas y en tiempo real a los clientes. - Herramientas Educativas
Las plataformas de aprendizaje pueden usar MiniRAG para responder preguntas de los estudiantes basadas en libros, notas de clases y artículos de investigación. - Aplicaciones de Salud
MiniRAG ayuda a crear asistentes médicos compactos que consultan documentación clínica o guías para sugerir los siguientes pasos. - Asistentes de Investigación Legal
Modelos legales pequeños pueden recuperar y resumir leyes, estudios de casos y precedentes legales rápidamente. - Dispositivos Sin Conexión
En áreas rurales o con baja conectividad, MiniRAG permite que los asistentes inteligentes trabajen sin acceso a internet al referenciar documentos almacenados localmente.
Estos ejemplos destacan cómo MiniRAG lleva los beneficios de los sistemas basados en RAG a dispositivos que anteriormente estaban limitados por restricciones de hardware.
Construyendo un Sistema MiniRAG: ¿Qué Se Necesita?
Crear un sistema MiniRAG es sorprendentemente accesible para desarrolladores y organizaciones. La configuración requiere algunos componentes básicos:
- Modelo de Lenguaje Pequeño
Modelos ligeros como Phi-2 o TinyLlama sirven como el núcleo del sistema. - Sistema de Recuperación
Herramientas como FAISS, Qdrant o Chroma pueden usarse para encontrar los documentos más relevantes utilizando búsqueda vectorial. - Almacén de Documentos
Los documentos personalizados se dividen y embeben en formato vectorial para una búsqueda eficiente. - Modelo de Incrustación
Transformadores de oraciones u otros modelos de incrustación pequeños se utilizan para convertir tanto consultas como documentos en vectores. - Plantilla de Prompts
Un prompt cuidadosamente diseñado alimenta el contenido recuperado al modelo para la generación de respuestas.
Los desarrolladores pueden experimentar con herramientas de código abierto como LangChain, Haystack o LlamaIndex para configurar esta arquitectura fácilmente.
Mejores Prácticas para Mejorar el Rendimiento de MiniRAG
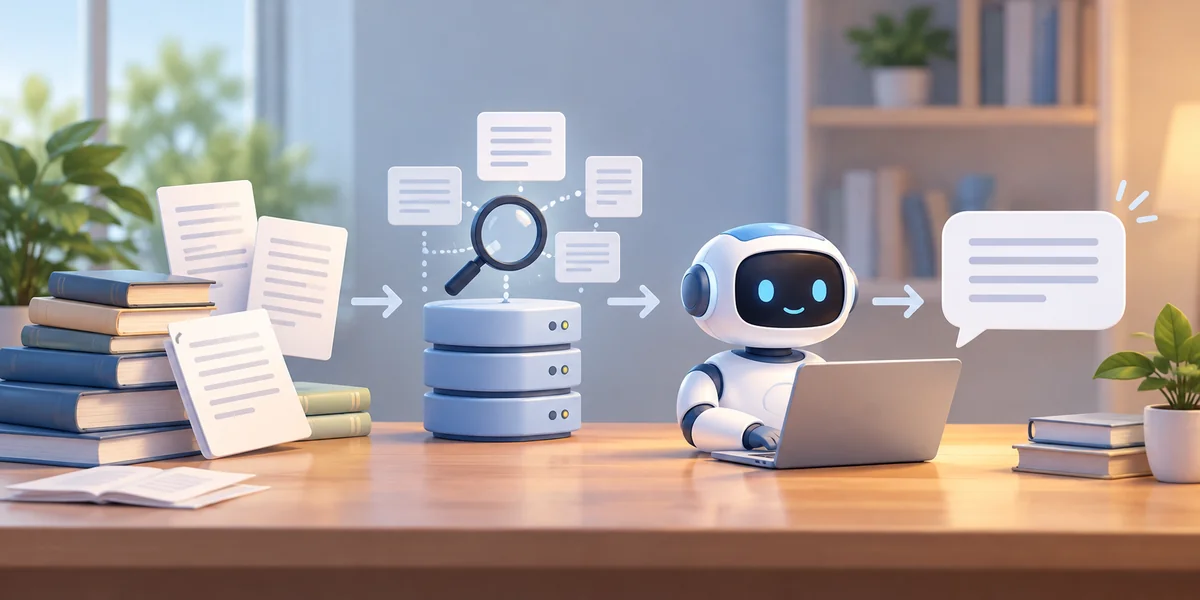
Para aquellos que desean ajustar su configuración de MiniRAG, algunas prácticas pueden mejorar la calidad y la velocidad:
- Usa documentos limpios y bien estructurados
Un buen formato mejora la relevancia de la recuperación. - Divide el texto sabiamente
Divide los documentos en párrafos o encabezados para mejorar la calidad de coincidencia. - Limita el uso de tokens
Sé consciente del límite de tokens del modelo pequeño para evitar problemas de corte. - Elige modelos de incrustación rápidos.
Los modelos de incrustación ligeros aceleran el proceso de recuperación y mantienen las cosas ágiles.
Conclusión
MiniRAG está cambiando la forma en que operan los modelos de lenguaje pequeños al darles acceso a la inteligencia basada en recuperación. Cierra la brecha entre la memoria limitada de los modelos compactos y la creciente demanda de respuestas precisas y en tiempo real. Al combinar técnicas de búsqueda inteligente con generación ligera, MiniRAG ofrece una solución práctica y rentable para desplegar IA en escenarios cotidianos. A medida que más organizaciones buscan llevar la IA a entornos con pocos recursos, MiniRAG ofrece un camino para hacerlo, sin necesidad de hardware masivo o grandes presupuestos. Con la configuración correcta, incluso un modelo pequeño puede pensar en grande.
Artículos relacionados
Cómo la Inteligencia Artificial está Transformando Sectores Tradicionales
Avanzando en la Recuperación: La Transición del RAG Tradicional al Graph RAG
Sora de OpenAI te Permite Crear Videos Impresionantes Simplemente Escribiendo Texto
Elegir entre Gemini 2.5 Pro y GPT 4.5 para Resultados más Inteligentes
Tu Guía Fácil de Seguir para Flujos de Trabajo con IA Agente
Seis Grados de Libertad: La Clave para el Movimiento Realista en la Tecnología
Dando Forma al Mañana: Nuestras Nuevas Inversiones en Infraestructura y Habilidades de IA
Modelos de IA Descubiertos: La Tecnología Detrás de los Sistemas Inteligentes
Entendiendo la Ventana de Contexto de la IA: Cómo Moldea los Modelos de Lenguaje
Aprendizaje Inteligente de Idiomas con IA: Duolingo y Otras Plataformas Destacadas
Desbloquea el Poder de la IA: Tendencias Empresariales, Herramientas y Mejores Prácticas
La IA Está Transformando los Mercados Privados como Ford Transformó la Industria
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
