
Dentro de Jamba 1.5: Transformer y Mamba se Encuentran en una Arquitectura
En esta página
En el mundo de los modelos de lenguaje de gran tamaño (LLMs), la innovación está impulsada por la búsqueda de una mayor eficiencia, escalabilidad y la capacidad de gestionar ventanas de contexto más largas. AI21 Labs ha dado un paso significativo hacia adelante con el lanzamiento de Jamba 1.5, que presenta la innovadora arquitectura híbrida Mamba-Transformer.
Jamba 1.5 está diseñado para sobresalir en tareas de lenguaje natural, ofreciendo una gestión de memoria superior, velocidad y comprensión contextual. Combina las capacidades de modelado de espacio de estado estructurado (SSM) de Mamba con las características de atención global del Transformer.
Esta arquitectura híbrida le permite procesar hasta 256,000 tokens, una ventana de contexto líder en la industria para modelos de código abierto. En esta publicación, exploramos qué hace único a Jamba 1.5, cómo funciona su arquitectura híbrida y por qué es crucial para el futuro del desarrollo y despliegue de IA.
¿Qué es Jamba 1.5? Un Modelo de Lenguaje Híbrido
Jamba 1.5 es un modelo de lenguaje ajustado por instrucciones que combina dos arquitecturas: el Transformer tradicional y el más reciente Mamba SSM. A diferencia de los modelos que dependen únicamente de los mecanismos de atención, Jamba aprovecha tanto los modelos de espacio de estado como las capas de atención, ofreciendo un rendimiento mejorado en tareas de contexto largo y entornos de baja latencia.
Jamba 1.5 está disponible en dos variantes principales:
- Jamba 1.5 Large: 94 mil millones de parámetros activos (398B en total)
- Jamba 1.5 Mini: 12 mil millones de parámetros activos (52B en total)
A pesar de sus diferencias de tamaño, ambos modelos se benefician de la misma base híbrida, permitiéndoles realizar diversas tareas de PLN, desde resumen y traducción hasta respuesta a preguntas y clasificación de texto, con una eficiencia excepcional.
La Arquitectura Híbrida Mamba-Transformer Explicada
La fortaleza central de Jamba 1.5 reside en cómo fusiona dos filosofías de diseño distintas en una arquitectura híbrida. Así es como está estructurada esta arquitectura:
1. Composición Base
Jamba 1.5 está construido utilizando 9 bloques modulares, cada uno contiene 8 capas. Estas capas siguen una proporción de 1:7, lo que significa que por cada capa de atención Transformer, hay siete capas Mamba. Este diseño permite al modelo beneficiarse de las características de largo alcance y baja memoria de Mamba, al tiempo que retiene las capacidades de atención de las capas Transformer para el reconocimiento de patrones globales.
2. Módulo de Mezcla de Expertos (MoE)
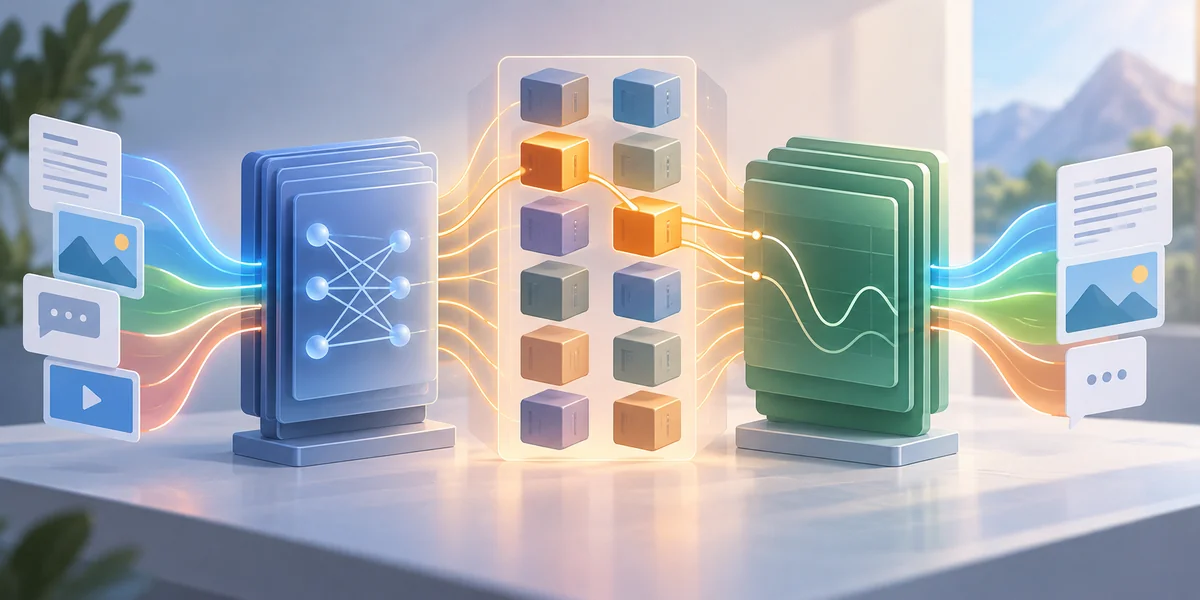
La arquitectura integra un mecanismo de Mezcla de Expertos (MoE). Consiste en 16 modelos expertos, de los cuales solo los 2 principales se activan por token. Esto permite un enrutamiento dinámico y garantiza un procesamiento especializado para diferentes tipos de entrada, mejorando el rendimiento mientras mantiene la eficiencia computacional.
3. Cuantización con ExpertsInt8
Para mejorar la eficiencia de la memoria, Jamba 1.5 utiliza cuantización ExpertsInt8 tanto para sus capas MoE como MLP. Esto le permite operar en precisión de 8 bits sin comprometer el rendimiento, reduciendo significativamente la carga de memoria, lo cual es particularmente importante para despliegues en tiempo real o con recursos limitados.
4. Manejo de Atención y Contexto
Con 64 cabezas de atención para consultas y 8 cabezas de clave-valor, Jamba 1.5 mantiene una alta capacidad de atención. Lo más importante, admite una ventana de contexto de 256K tokens, actualmente la más grande entre los modelos de código abierto disponibles públicamente. Los Transformers tradicionales luchan con secuencias largas debido al costoso almacenamiento en caché de clave-valor (KV). Jamba aborda esto con optimizaciones arquitectónicas que reducen la memoria de caché KV mientras preservan la integridad de la secuencia.
5. Estabilización de Activación con Pérdidas Auxiliares
Para asegurar un rendimiento consistente a través de arquitecturas extremadamente profundas y secuencias largas, Jamba 1.5 incorpora funciones de pérdida auxiliar que ayudan a estabilizar las magnitudes de activación. Al combinar capas Mamba y Transformer, las variaciones en el flujo de información a través de la red pueden llevar a gradientes inestables o activaciones que desaparecen.
¿Por qué Importa la Arquitectura Híbrida?
La arquitectura híbrida de Jamba 1.5 aborda algunas de las mayores limitaciones de los LLMs anteriores:
- Eficiencia de Memoria: El diseño de espacio de estado de Mamba reduce drásticamente la sobrecarga de memoria que conlleva manejar secuencias largas en Transformers.
- Longitud de Contexto: Al admitir 256K tokens, Jamba 1.5 puede modelar libros enteros, artículos de investigación o conversaciones de varios turnos sin truncamiento.
- Especialización Dinámica: MoE permite al modelo involucrar selectivamente diferentes sub-redes, mejorando la calidad sin un aumento total en el costo computacional.
- Inferencia Rápida: El equilibrio de menos capas de atención y más capas Mamba resulta en una menor latencia para el procesamiento de entradas.
Esta combinación de ventajas hace que el modelo sea especialmente adecuado para tareas de PLN de alto rendimiento en dominios como la salud, el ámbito legal, la investigación académica y la automatización del servicio al cliente.
Eficiencia y Compatibilidad de Hardware
Una preocupación importante con los LLMs modernos es si pueden ejecutarse eficientemente en hardware del mundo real. Muchos modelos requieren múltiples GPUs e infraestructura costosa. Jamba 1.5 está diseñado para ser más accesible.
- Admite Flash Attention y Paged Attention para una inferencia más rápida.
- Está optimizado para inferencia de GPU única utilizando los marcos DeepSpeed y vLLM.
- Debido a que las capas Mamba son más ligeras, el consumo de memoria es menor que en los modelos Transformer puros.
Esto hace que Jamba 1.5 sea una gran opción para startups, desarrolladores independientes y pequeñas empresas que buscan utilizar IA poderosa sin incurrir en grandes costos de infraestructura.
Variantes del Modelo y Accesibilidad
AI21 Labs ha lanzado dos versiones de Jamba 1.5 accesibles públicamente:
- Jamba 1.5 Mini (12B): Ligero, accesible para entornos locales o de bajo cómputo.
- Jamba 1.5 Large (94B): Modelo de alta capacidad para casos de uso empresariales exigentes.
Ambos modelos están ajustados por instrucciones y son multilingües, soportando nueve idiomas: inglés, portugués, hebreo, alemán, italiano, holandés, español, árabe y francés.
Desarrolladores e investigadores pueden acceder a Jamba 1.5 a través de:
- AI21 Studio API
- Hugging Face Model Hub
- Interfaz Web de Chat de AI21
Jamba 1.5 también puede integrarse en aplicaciones usando Python con simples llamadas a API, permitiendo su uso en plataformas como chatbots, herramientas de análisis de texto y servicios de generación de contenido.
¿Cómo se Compara Jamba 1.5 con los Transformers Estándar?
| Característica | Transformers Tradicionales | Modelo Híbrido Jamba 1.5 |
|---|---|---|
| Arquitectura | Solo atención | Mamba + Transformer |
| Longitud de Contexto | Típicamente 2K–32K tokens | Hasta 256K tokens |
| Uso de Memoria | Alto | Menor con Mamba e Int8 |
| Latencia | Moderada a alta | Menor (menos capas de atención) |
| Cálculo Especializado (MoE) | No | Sí (enrutamiento dinámico) |
| Cuantización | Opcional (a menudo FP16) | Integrada ExpertsInt8 |
Conclusión
Jamba 1.5 representa un avance significativo en la arquitectura de modelos de lenguaje de gran tamaño. Al fusionar el poderoso mecanismo de atención del Transformer con la capacidad del modelo Mamba para manejar secuencias largas de manera eficiente, AI21 Labs ha creado un modelo que establece un nuevo referente en LLMs de código abierto. Su estructura híbrida es más que un logro técnico, es una solución a los desafíos del mundo real en la escalabilidad de modelos de lenguaje. Con soporte para 256K de contexto, componentes modulares MoE y cuantización eficiente, Jamba 1.5 está optimizado tanto para el rendimiento como para la practicidad.
Artículos relacionados
Cómo UltraCamp utiliza la IA para construir conexiones reflexivas con los clientes
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Comprendiendo el Impacto de la IA en la Escritura Creativa
Guía para Principiantes sobre Probabilidad Conjunta, Marginal y Condicional
5 Acciones de IA Generativa a Vigilar para Oportunidades de Inversión en 2025
Descubre los 5 Avances Más Innovadores en IA Generativa que Vale la Pena Probar
Ray: La Forma Más Inteligente de Escalar Cargas de Trabajo de IA y Aprendizaje Automático
Tecnología de Gemelos Digitales: Usos Reales, Tipos y Beneficios Clave

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
El Futuro de la IA en la Publicidad Digital
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
