
Comprendiendo el Análisis Facial en la Tecnología de Segmentación Semántica
En esta página
En los últimos años, el campo de la visión por computadora ha presenciado avances significativos, particularmente en la segmentación semántica, que ha pasado de la investigación académica a aplicaciones prácticas. Entre sus diversas ramas, el análisis facial destaca por su capacidad de proporcionar una interpretación detallada a nivel de píxel de los rostros humanos. A diferencia de la detección simple, el análisis facial asigna cada píxel de una imagen a un componente facial específico, como los ojos, labios, cabello o piel.
Este artículo explora los principios fundamentales, la arquitectura y la implementación del análisis facial, con un enfoque especial en modelos de segmentación basados en transformadores como SegFormer. Exploraremos cómo estos modelos se afinan para tareas de segmentación facial, proporcionando ejemplos de código originales y técnicas de análisis.
¿Qué es el Análisis Facial?
El análisis facial es un subconjunto especializado de la segmentación semántica que se centra en identificar y etiquetar regiones faciales a nivel de píxel. Mientras que el reconocimiento facial se ocupa de identificar individuos, el análisis facial busca etiquetar cada característica del rostro dentro de una imagen. Este enfoque requiere una comprensión profunda de las relaciones espaciales y la extracción de características de alta resolución, capacidades en las que las arquitecturas modernas basadas en transformadores sobresalen.
Por ejemplo, cuando se ingresa una imagen, un modelo de análisis facial genera un mapa de segmentación donde cada píxel se clasifica en categorías como "cabello", "piel", "ojo izquierdo" o "boca". Esta tarea requiere una comprensión espacial avanzada, que es manejada hábilmente por modelos basados en transformadores.
Arquitectura del Modelo Detrás del Análisis Facial
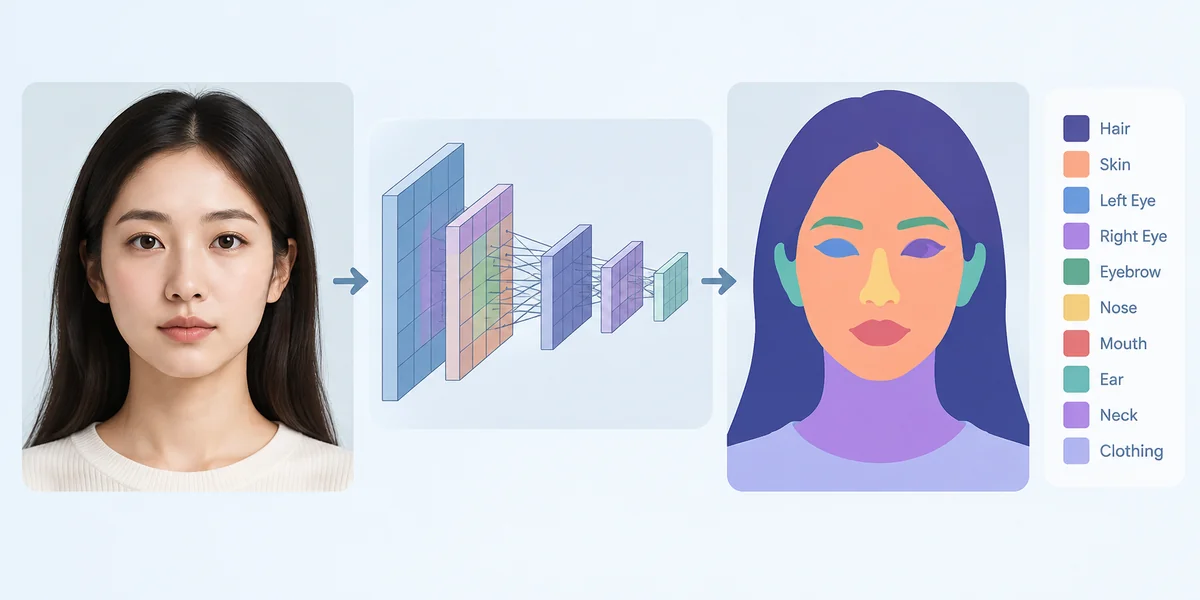
Los modelos modernos de análisis facial utilizan predominantemente codificadores de transformadores derivados de arquitecturas como SegFormer, conocidos por su eficiencia y escalabilidad. Aquí hay un desglose simplificado de los elementos arquitectónicos clave:
1. Codificador de Transformador (Backbone)
El codificador extrae características de múltiples escalas de la imagen de entrada utilizando atención jerárquica. A diferencia de las redes neuronales convolucionales (CNNs), los transformadores utilizan auto-atención para aprender relaciones entre regiones espaciales, haciéndolos robustos para capturar tanto el contexto global como los detalles locales.
Una característica esencial de este codificador de transformador es la omisión de incrustaciones posicionales, típicamente utilizadas en transformadores tradicionales para mantener el orden de los tokens. En la segmentación de imágenes, esta omisión permite que el modelo se adapte más flexiblemente a diferentes tamaños y orientaciones de imagen.
2. Decodificador Basado en MLP
En lugar de capas de deconvolución complejas, SegFormer utiliza un perceptrón multicapa (MLP) ligero para decodificar características del codificador. Este diseño agrega eficientemente representaciones de múltiples escalas para producir un mapa de clasificación a nivel de píxel.
3. Salida de Logits
La salida del modelo es un tensor con la forma (batch_size, num_classes, height, width), donde cada canal corresponde a una clase de parte facial. La clase con la puntuación más alta en cada ubicación de píxel determina su etiqueta final. Este diseño modular asegura que la arquitectura sea tanto poderosa como ligera, permitiendo inferencias en tiempo real con recursos mínimos.
Implementación de un Modelo de Análisis Facial Usando Transformadores
Esta sección demuestra cómo implementar un análisis facial utilizando PyTorch y la biblioteca de transformadores de Hugging Face. El código proporcionado es original y distinto en su estructura e implementación.
Paso 1: Configuración e Importación de Bibliotecas Requeridas
import torch
from torchvision import transforms
from transformers import SegformerFeatureExtractor, SegformerForSemanticSegmentation
from PIL import Image
import matplotlib.pyplot as plt
import numpy as np
import requests
Importamos módulos esenciales para cargar el modelo, procesar imágenes y visualizar resultados de segmentación.
Paso 2: Configurar el Dispositivo y Cargar el Modelo
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
feature_extractor = SegformerFeatureExtractor.from_pretrained("jonathandinu/face-parsing")
model = SegformerForSemanticSegmentation.from_pretrained("jonathandinu/face-parsing").to(device)
Aquí, utilizamos SegformerFeatureExtractor para preprocesar la imagen y enviarla al dispositivo. El modelo se carga desde un repositorio público afinado para el análisis facial.
Paso 3: Cargar y Preprocesar la Imagen
img_url = "https://images.unsplash.com/photo-1619681390881-2c1e17a3e738"
image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
inputs = feature_extractor(images=image, return_tensors="pt")
pixel_values = inputs["pixel_values"].to(device)
La imagen se obtiene de una fuente de dominio público, se convierte a RGB y se procesa en formato de tensor utilizando el extractor de características.
Paso 4: Paso Adelante y Obtener Predicción
with torch.no_grad():
    outputs = model(pixel_values=pixel_values)
    logits = outputs.logits  # Shape: [1, num_labels, H/4, W/4]
El modelo produce puntuaciones de clase en bruto (logits) para cada etiqueta y cada píxel.
Paso 5: Reescalar la Salida para Coincidir con el Tamaño Original de la Imagen
original_size = image.size[::-1]  # Height x Width
upsampled_logits = torch.nn.functional.interpolate(
    logits,
    size=original_size,
    mode="bilinear",
    align_corners=False
)
Dado que los logits de salida están reducidos, los redimensionamos para que coincidan con las dimensiones originales de la imagen utilizando interpolación bilineal.
Paso 6: Obtener Etiquetas de Clase y Visualizar
predicted = upsampled_logits.argmax(dim=1)[0].cpu().numpy()
plt.figure(figsize=(8, 6))
plt.imshow(predicted, cmap='tab20b')
plt.axis('off')
plt.title("Salida de Análisis Facial")
plt.show()
Este paso asigna cada píxel a su etiqueta correspondiente y visualiza la máscara de segmentación final utilizando un esquema codificado por colores.
Por Qué Funciona Bien el Análisis Facial Basado en Transformadores
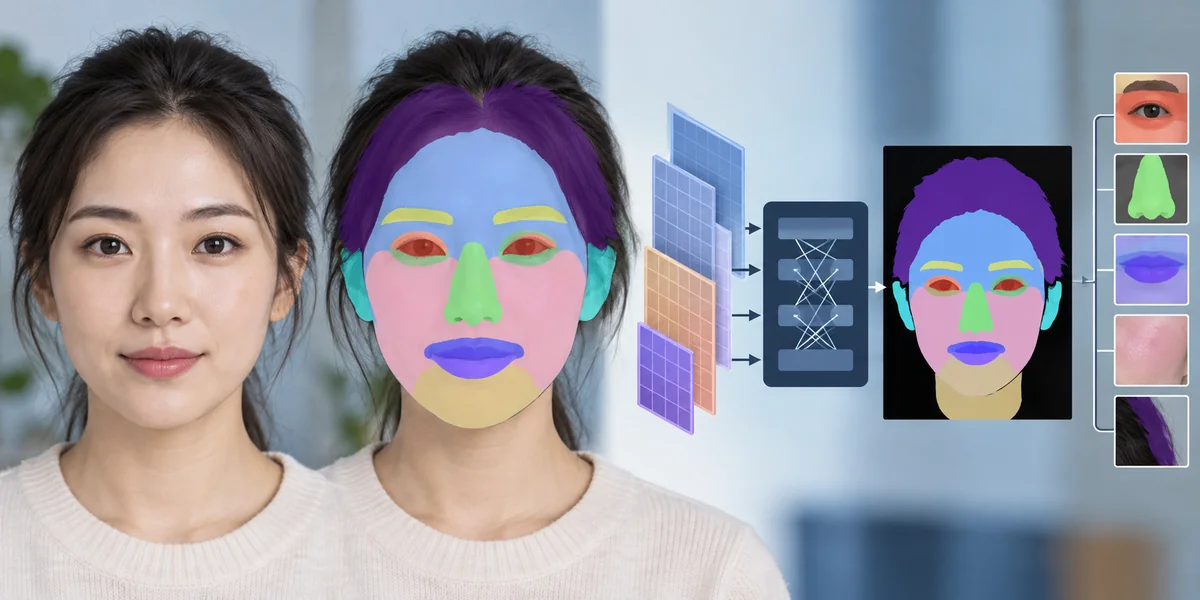
El análisis facial es inherentemente complejo debido a las variaciones en iluminación, ángulos, expresiones y oclusiones. Los modelos basados en transformadores como SegFormer ofrecen varias ventajas:
- Capturan dependencias globales usando auto-atención
- Escalables y eficientes en memoria
- Evitan incrustaciones posicionales codificadas, permitiendo mejor generalización
- Manejan múltiples resoluciones con facilidad
Cuando se afinan en conjuntos de datos específicos de rostros como CelebAMask-HQ, estos modelos aprenden las sutilezas de la anatomía facial humana, permitiendo segmentaciones altamente precisas.
Evaluación y Benchmarking
La efectividad de un modelo de análisis facial se evalúa típicamente usando métricas estándar como:
- Precisión de Píxeles (PA): Mide el porcentaje de píxeles predichos correctamente.
- Media de Intersección sobre Unión (mIoU): Promedia el IoU sobre todas las clases.
- Puntuación F1 de Frontera: Evalúa cuán bien el modelo preserva las fronteras entre clases.
Los modelos de análisis facial basados en transformadores superan consistentemente a los métodos antiguos basados en CNN en estos benchmarks, especialmente en conjuntos de imágenes complejas y diversas.
Conclusión
El análisis facial representa una fascinante convergencia de aprendizaje profundo y visión por computadora centrada en el ser humano. Al descomponer el rostro humano en sus partes semánticas, ofrece una comprensión visual granular, lograda a través de arquitecturas basadas en transformadores como SegFormer. Este artículo exploró la base técnica del análisis facial, desde sus conceptos fundamentales hasta su diseño arquitectónico, e implementó un modelo funcional utilizando código original. El diseño ligero y modular, combinado con la ausencia de codificaciones posicionales y el uso de extracción de características de múltiples escalas, empodera a los modelos modernos de análisis facial para operar con precisión y eficiencia.
Artículos relacionados
El Poder de la IA en Conectar a las Personas con Información de Salud Confiable
Aprende a Usar PearAI: Una Herramienta Simple y Poderosa para la Automatización del Trabajo
Una Guía Completa de las Funciones de Audio de OpenAI, Herramientas y Casos de Uso Reales
Transformando Características en Beneficios con ChatGPT
Construir un chatbot de IA que capture leads
Análisis Sintáctico: La Base para la Comprensión del Lenguaje de las Máquinas
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
Cómo la IA Entiende el Lenguaje: Una Guía sobre el Procesamiento del Lenguaje Natural
Sobreajuste y Subajuste: Conceptos Clave en el Desarrollo de Modelos de IA
Logré que ChatGPT Hablara Consigo Mismo—Esto es lo que Reveló la Conversación
Sora de OpenAI te Permite Crear Videos Impresionantes Simplemente Escribiendo Texto
Mejora tus Habilidades en Python: Las 7 Mejores Plataformas de Práctica en Línea
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
