
Capacidades de Imagen y Video de ChatGPT-4 Vision Explicadas en Profundidad
En esta página
La inteligencia artificial (IA) ha destacado durante mucho tiempo en tareas de lenguaje como la lectura, escritura y traducción. Sin embargo, la interpretación visual ha sido un área más desafiante. Con la introducción de ChatGPT-4 Vision, esto está cambiando. Esta versión avanzada de ChatGPT no solo responde al texto, sino que también puede analizar imágenes e interpretar partes de videos, ofreciendo perspectivas más allá del simple reconocimiento de objetos. Imaginen dar vista a una mente razonante—este es el potencial de ChatGPT-4 Vision.
Pero, ¿qué tan eficazmente entiende los datos visuales? ¿Puede manejar imágenes complejas o rastrear cambios a través de fotogramas de video? En este artículo, profundizamos en las capacidades de ChatGPT-4 Vision y exploramos cómo está transformando la inteligencia visual en la IA.
¿Cómo Entiende ChatGPT-4 Vision las Imágenes?
En el corazón de las habilidades de procesamiento de imágenes de ChatGPT-4 Vision está el aprendizaje multimodal—la integración de texto y visuales. Esto significa que la IA no solo interpreta palabras escritas; analiza el contenido de las imágenes, identificando patrones, objetos, colores e incluso contextos emocionales. A diferencia de modelos anteriores que dependían de subtítulos de imágenes o metadatos, ChatGPT-4 Vision procesa el contenido visual real.
Al cargar una imagen, el modelo la procesa a través de múltiples capas de redes neuronales diseñadas para extraer características tanto espaciales como semánticas. Puede describir escenas (por ejemplo, "un perro jugando en el césped") e inferir (por ejemplo, "el perro parece emocionado, probablemente en medio de una carrera"). Aunque el modelo funciona mejor con visuales claros, también puede interpretar imágenes complejas o abstractas más eficazmente que versiones anteriores.
Las habilidades de ChatGPT-4 Vision van más allá del reconocimiento básico. Puede comparar dos imágenes, analizar gráficos, resolver problemas matemáticos a partir de imágenes y explicar diagramas. Para gráficos, entiende ejes, valores y etiquetas, combinando señales visuales con razonamiento lógico. Este nivel de análisis de imagen y video permite que la IA funcione como un asistente visual, ayudando a los usuarios a interpretar datos, resolver problemas y tomar decisiones visuales de manera eficiente.
Avances en la Interpretación de Videos
Si bien ChatGPT-4 Vision sobresale en la interpretación de imágenes, sus capacidades de video aún están en desarrollo, aunque el progreso es significativo. A diferencia de los humanos, no analiza el video en tiempo real. En su lugar, examina fotogramas seleccionados o secuencias extraídas de un video. Este enfoque fotograma a fotograma le permite entender líneas de tiempo, identificar acciones e inferir cambios o patrones dentro de las escenas.
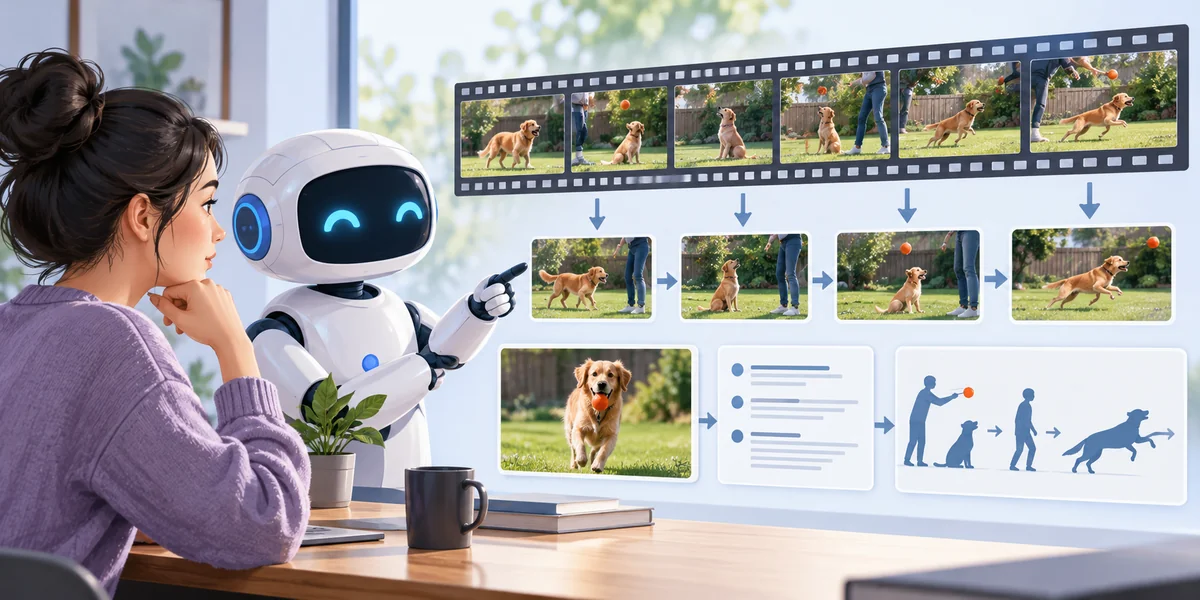
El sistema extrae fotogramas clave—imágenes críticas que capturan momentos importantes—y los utiliza para construir una comprensión integral del contenido del video. A partir de estas imágenes, determina quién está involucrado, qué están haciendo y cómo cambia el contexto. Este método es valioso en áreas como el análisis de imágenes de seguridad, tutoriales en video y guías prácticas, donde la secuencia de acciones es crucial.
En educación, puede analizar videos de experimentos, explicando cada paso. En entretenimiento, puede resumir tramas, notar cambios de ánimo o identificar transiciones clave. Aunque aún no procesa el movimiento de alta velocidad o secuencias de video completas de manera fluida, supera a las herramientas solo de texto cuando se involucran visuales.
Cuando se combina con consultas de usuarios, ChatGPT-4 Vision sobresale—desglosando clips, reconociendo gestos y analizando tiempos. Este conjunto de habilidades en evolución marca un avance significativo en hacer que la IA sea verdaderamente multimodal y consciente del contexto.
Aplicaciones del Mundo Real de la IA Visual
Las aplicaciones prácticas de las capacidades de imagen y video de ChatGPT-4 Vision son vastas e impactantes. Esta herramienta no es solo una novedad; tiene implicaciones significativas en diversas industrias y profesiones. Ya seas educador, ingeniero, trabajador de la salud o profesional creativo, ChatGPT-4 Vision puede agilizar tareas y mejorar la toma de decisiones.
En salud, por ejemplo, el modelo puede ayudar a analizar registros visuales como radiografías, tomografías computarizadas o diapositivas de patología. Aunque no reemplaza a los especialistas capacitados, apoya la detección temprana al resaltar posibles problemas o anomalías, proporcionando una capa adicional de revisión cuando sea necesario.
En diseño y arquitectura, la IA evalúa planos, bocetos o maquetas, ofreciendo retroalimentación, identificando inconsistencias y sugiriendo mejoras—todo a través de una comprensión visual de los materiales. Esta capacidad mejora tanto la creatividad como la precisión.
El servicio al cliente también se beneficia ya que los usuarios pueden enviar fotos de problemas de hardware, errores de pantalla o configuraciones defectuosas. La IA interpreta la imagen y proporciona pasos de solución de problemas específicos, reduciendo conjeturas y tiempos de respuesta.
En educación, los docentes pueden subir trabajos de estudiantes—como diagramas, matemáticas escritas a mano o mapas históricos—y solicitar a la IA que genere preguntas, explique errores o proporcione contexto. Este modelo transforma imágenes estáticas en herramientas de enseñanza interactivas, mejorando el compromiso.
ChatGPT-4 Vision también contribuye a la accesibilidad al describir imágenes para usuarios con discapacidad visual u ofrecer soporte multilingüe para instrucciones visuales.
En última instancia, su fuerza radica en adaptarse a diferentes contextos—entender, razonar y responder a través de visuales tan proficientemente como a través del texto.
El Futuro del Razonamiento Visual en la IA
El futuro de ChatGPT-4 Vision sugiere una integración más profunda de la percepción visual y el razonamiento. A medida que avancen las capacidades de análisis de imágenes y videos, se espera que la interpretación en tiempo real se vuelva más prevalente. Este desarrollo podría desbloquear nuevas posibilidades en áreas como vigilancia, análisis deportivo y comunicación basada en gestos. La integración con la realidad aumentada también podría conducir a interacciones más inteligentes y receptivas con nuestro entorno.
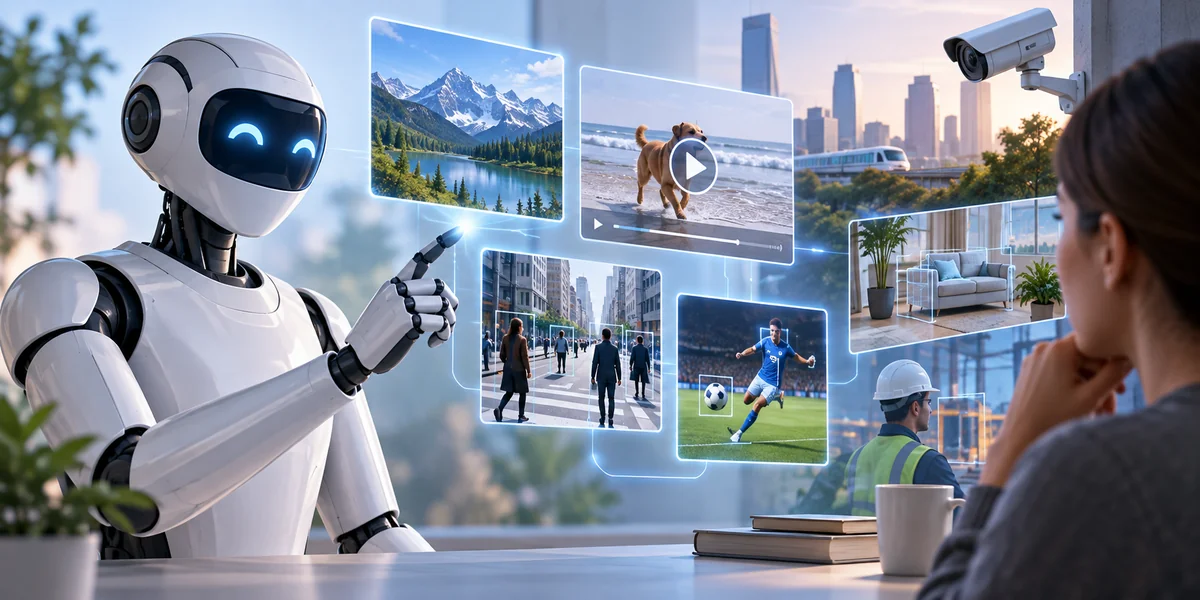
A medida que esta tecnología evoluciona, las consideraciones éticas se volverán cada vez más importantes. Cuestiones como la privacidad, el consentimiento de datos y el despliegue responsable deben abordarse junto con la innovación. También se anticipa que ChatGPT-4 Vision mejorará en la fusión de múltiples formas de entrada—texto, imágenes y video—en perspectivas cohesivas y ricas en contexto.
En lugar de reemplazar la visión humana, mejorará nuestra comprensión y uso de la información visual. Está evolucionando hacia un asistente visual capaz, uno que no solo observa sino que también ayuda a los usuarios a actuar con claridad.
Conclusión
Las capacidades de imagen y video de ChatGPT-4 Vision significan un avance significativo en la interacción de la IA con el mundo visual. Puede identificar, analizar y razonar con imágenes y videos de formas que se sienten intuitivas y útiles. Desde la educación hasta el diseño y la solución de problemas, aporta comprensión visual a las tareas cotidianas. Si bien la interpretación de videos aún está evolucionando, las capacidades fundamentales son sólidas. A medida que esta tecnología madura, continuará transformando la forma en que nos comunicamos con las máquinas—a través tanto de palabras como de visuales.
Artículos relacionados
Revisión Exhaustiva de las Herramientas de IA Generativa de Adobe
El Lado Oscuro de la IA: Cómo los Deepfakes y las Noticias Falsas Están Reconfigurando la Realidad
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
3 Historias Inspiradoras de Líderes en IA
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
Cómo la IA está Transformando la Industria Minorista
Aprende a Eliminar Datos Duplicados en Excel con Estos 5 Métodos Fáciles

¿Qué es la depuración de datos y por qué es importante para conjuntos de datos limpios?
Diferencias Clave Entre Ciencia de Datos y Aprendizaje Automático Explicadas
IBM Watson OpenScale: Control y monitoreo de IA para cualquier nube

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas

11 Libros Que Todo Científico de Datos Debe Leer en 2025
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
