
Clustering y Reducción de Dimensionalidad: Conceptos Clave en el Aprendizaje No Supervisado
En esta página
El aprendizaje no supervisado es un concepto transformador en la inteligencia artificial que permite a las máquinas aprender de datos sin etiquetar y sin orientación explícita. Imagina entrar en una sala llena de desconocidos y discernir patrones basados únicamente en su comportamiento o vestimenta, sin ningún contexto previo. En el corazón del aprendizaje no supervisado, se encuentran dos técnicas fundamentales: clustering y reducción de dimensionalidad. El clustering implica agrupar puntos de datos similares, mientras que la reducción de dimensionalidad simplifica conjuntos de datos complejos, preservando la información esencial.
Estas técnicas trabajan en conjunto para descubrir patrones y estructuras en datos caóticos, haciendo del aprendizaje no supervisado una herramienta indispensable para tareas como la segmentación de clientes, el análisis de imágenes y la detección de anomalías. Esto impulsa la obtención de conocimientos significativos en diversos campos.
Entendiendo el Clustering: Descifrando Datos No Etiquetados
El clustering es un método para identificar agrupaciones naturales dentro de los datos. Es similar a clasificar un cajón lleno de artículos variados—monedas, llaves, bolígrafos—sin guía sobre qué pertenece junto. Podrías organizarlos por forma, color o función. Las máquinas realizan esta clasificación a una escala y velocidad que supera la capacidad humana.
El algoritmo de clustering más conocido es K-Means, que divide los datos en un número determinado de grupos o clusters, con cada punto perteneciendo al valor medio más cercano. A pesar de su simplicidad, K-Means es efectivo para tareas como la segmentación de clientes, la categorización de publicaciones en redes sociales y la caracterización de expresión génica.
Sin embargo, K-Means tiene limitaciones. Requiere conocimiento previo del número de clusters y asume que son aproximadamente esféricos. Cuando estas condiciones no se cumplen, entran en juego algoritmos como DBSCAN o Clustering Jerárquico. DBSCAN puede identificar clusters de cualquier forma y eliminar ruido, mientras que el Clustering Jerárquico crea un árbol de clusters, útil cuando se desconoce el número de grupos.
El clustering es crucial para la segmentación de clientes en marketing, la detección de anomalías en seguridad y el descubrimiento de patrones en el procesamiento de imágenes. Su naturaleza no supervisada demuestra que incluso sin ejemplos etiquetados, existe estructura que puede ser detectada.
No obstante, persisten desafíos, como seleccionar el número óptimo de clusters, evaluar su calidad e interpretarlos de manera significativa. Aunque los algoritmos ayudan, la intuición humana a menudo juega un papel significativo en entender qué representan los clusters.
Reducción de Dimensionalidad: Simplificando la Complejidad
Imagina tratar de apreciar una pintura a través de un microscopio—demasiado detalle oscurece la visión general. Este es el problema con los datos de alta dimensión, donde numerosas características los hacen ruidosos y difíciles de manejar, conocido como la "maldición de la dimensionalidad". La reducción de dimensionalidad ofrece una solución.
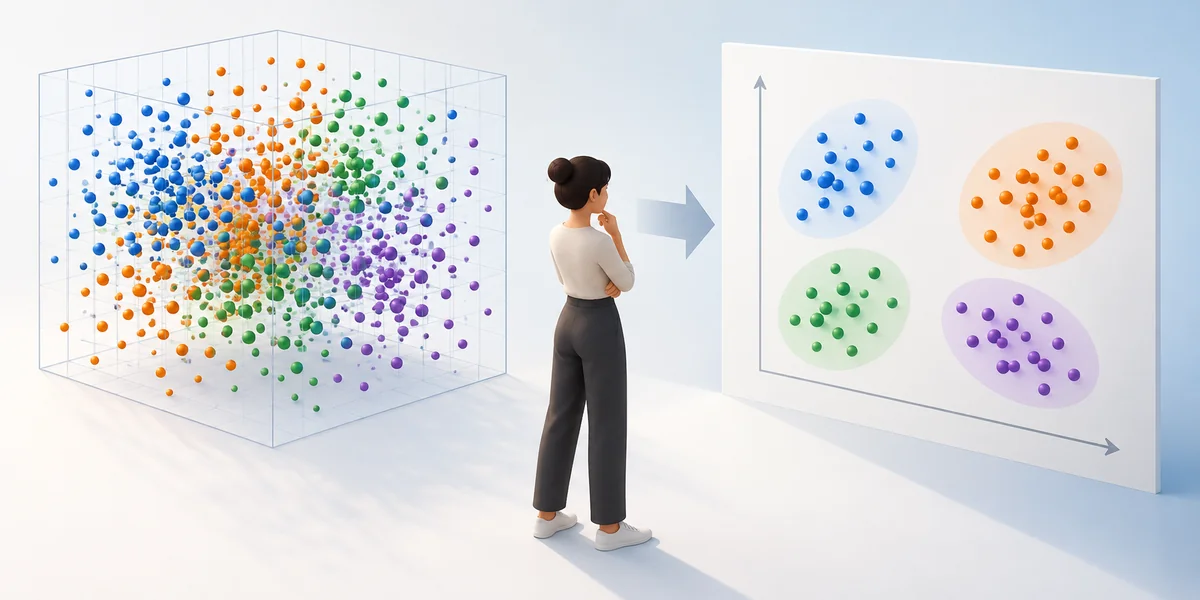
El objetivo es reducir características mientras se preserva la mayor cantidad de información relevante posible. El Análisis de Componentes Principales (PCA) es una técnica ampliamente utilizada que transforma datos originales en nuevas variables, o componentes principales, capturando una varianza significativa. Es similar a comprimir un objeto 3D en una imagen 2D sin perder su forma.
PCA es invaluable para revelar patrones ocultos y reducir la complejidad, mejorando tareas como clustering y visualización. Sin embargo, PCA es lineal, asumiendo que los datos pueden ser aplanados a lo largo de líneas rectas. Para datos complejos, métodos no lineales como t-SNE (t-distributed Stochastic Neighbor Embedding) o UMAP (Uniform Manifold Approximation and Projection) son preferibles. Estos métodos sobresalen en mantener la estructura local de los datos, ideales para imágenes, audio o incrustaciones de palabras.
Una aplicación práctica de la reducción de dimensionalidad es el reconocimiento facial. Una foto contiene miles de píxeles, cada uno una dimensión. Reducir esto a características esenciales permite la coincidencia y reconocimiento facial en tiempo real.
En genómica, donde los investigadores manejan conjuntos de datos con miles de genes por muestra, la reducción de dimensionalidad resalta elementos cruciales. En finanzas, simplifica extensos conjuntos de datos de historial de transacciones, ayudando en la detección de fraudes o análisis de tendencias.
El desafío radica en la interpretación. Reducir dimensiones puede oscurecer el significado de las nuevas características. Equilibrar precisión e interpretabilidad es una consideración continua.
Combinando Clustering y Reducción de Dimensionalidad
Estas técnicas a menudo se complementan entre sí. El clustering se beneficia de la reducción de ruido, y la reducción de dimensionalidad conduce a mejores conocimientos. Un flujo de trabajo común implica preparar datos para clustering usando PCA o t-SNE, resultando en clusters más estables y significativos.
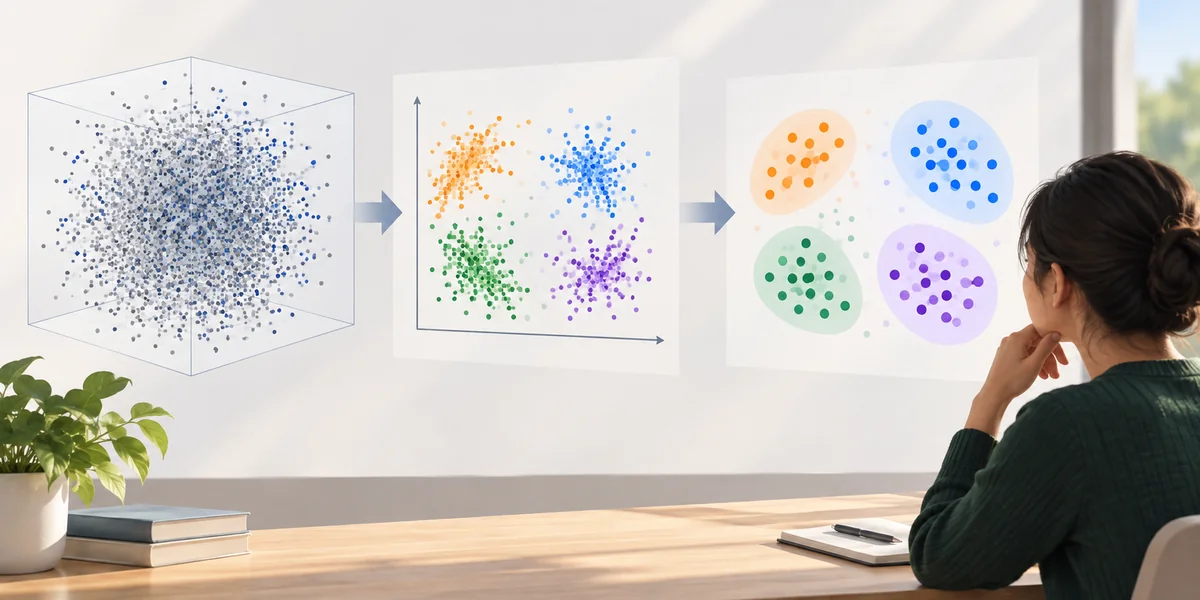
En análisis visual, un conjunto de datos de alta dimensión podría primero comprimirse usando UMAP, seguido de agrupar con K-Means, revelando clusters que de otro modo estarían ocultos en datos sin procesar.
Esta sinergia es evidente en los sistemas de recomendación. Con miles de usuarios y películas, cada uno con características únicas, la reducción de dimensionalidad destaca preferencias influyentes. El clustering luego identifica usuarios o categorías de películas similares, permitiendo recomendaciones más precisas y relevantes.
En salud, la IA analiza datos complejos de historiales de pacientes, resultados de laboratorio y genética. La reducción de dimensionalidad destila variables en patrones esenciales, mientras que el clustering revela subgrupos, potencialmente descubriendo nuevos tipos de enfermedades o factores de riesgo.
Juntos, estas herramientas forman un dúo dinámico en el aprendizaje no supervisado, permitiendo a las máquinas clasificar y simplificar datos incluso sin contexto.
Conclusión
El aprendizaje no supervisado, a través de clustering y reducción de dimensionalidad, proporciona herramientas poderosas para descubrir patrones ocultos en datos complejos y no etiquetados. Estas técnicas simplifican el ruido abrumador, ayudando a las máquinas a encontrar estructura y significado. Aunque la interpretación humana sigue siendo crucial, estos métodos ofrecen un apoyo invaluable en diversos campos, desde la salud hasta el marketing. A medida que la IA evoluciona, el aprendizaje no supervisado continuará siendo un método vital para extraer conocimientos de datos sin procesar y no estructurados, impulsando la innovación y el descubrimiento de maneras inexploradas.
Artículos relacionados
¿Qué es el Aprendizaje No Supervisado? Explorando Técnicas Clave y Usos
Aprendizaje Zero-Shot: Cómo la IA Reconoce lo Desconocido Sin Datos de Entrenamiento
Guía para Principiantes sobre la Discretización en Modelos de Aprendizaje Automático
Diferencias Clave Entre Ciencia de Datos y Aprendizaje Automático Explicadas
Descubre Cómo los Tutores de IA Están Cambiando la Forma en que los Estudiantes Aprenden en Casa
El Futuro del Aprendizaje: Cómo la IA Está Redefiniendo las Aulas Virtuales
Comprendiendo PyTorch: El Poderoso Marco para el Aprendizaje Profundo
TensorFlow: El Marco de IA que Impulsa Innovaciones en el Aprendizaje Automático
Normalización por Lote vs. Normalización por Capa: Diferencias Clave en el Aprendizaje Profundo
Redes Neuronales: Los Bloques Fundamentales de la IA
De la Compresión a la Creatividad: El Papel de los Autoencoders Variacionales en la IA
Aprendizaje Personalizado con IA: Un Cambio Radical en la Educación en Línea
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
